
 محصولات
اجرای سهمرحلهای مدل VLM با OpenVINO بر روی پردازندههای Intel برای کسبوکارهای کوچک
Hugging Face با بهرهگیری از OpenVINO و Optimum Intel، راهنمای سادهای در سه گام برای راهاندازی مدلهای Vision‑Language بر روی پردازندههای Intel ارائه داد؛ در این راهنما به کاهش نیاز به منابع، بهینهسازی مدل و اجرای در محیطهای محلی پرداخته شد.
 مدلها
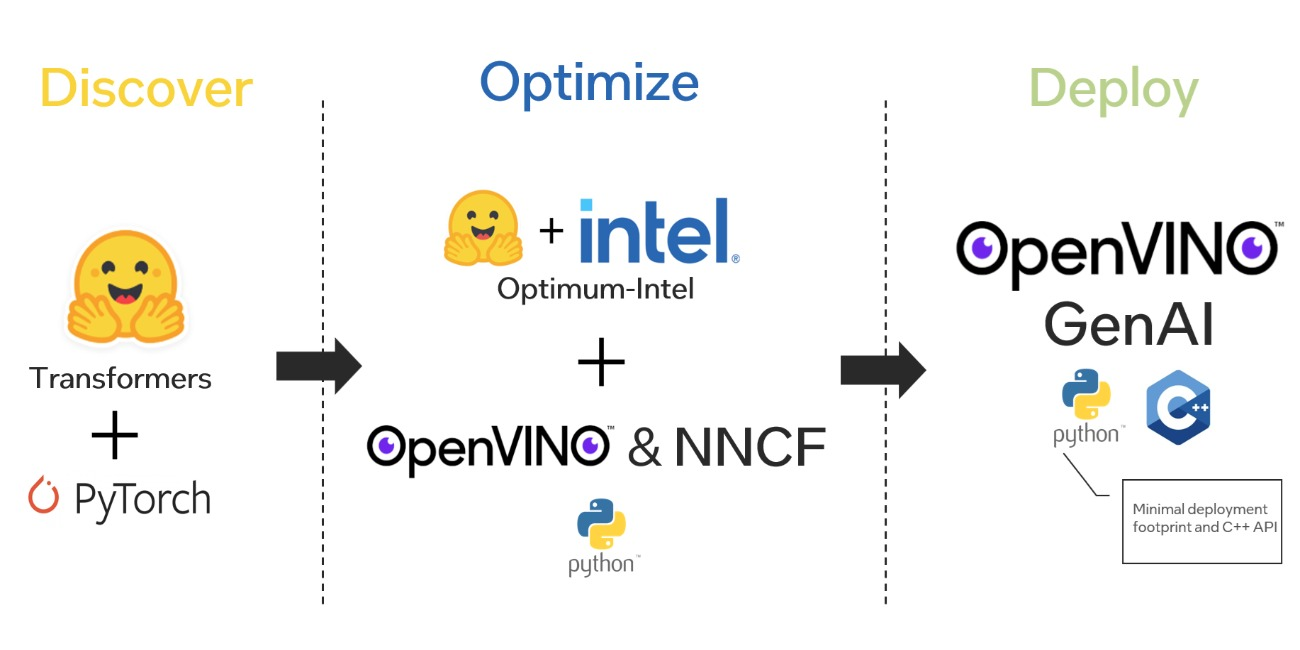
بهینهسازی و استقرار مدلهای هوش مصنوعی با OpenVINO و Optimum-Intel
محبوبترین روش برای استقرار مدلهای ترنسفورمر در لبه (Edge) با استفاده از ابزارهای Optimum-Intel و OpenVINO GenAI را که بهرهوری را افزایش میدهد، بررسی میکنیم.
 اخبار
پشتیبانی سریعتر Assisted Generation بر روی Intel Gaudi در هوش مصنوعی
شرکت Intel و هابانا پردازنده Gaudi را برای سرعتپردازی Assisted Generation طراحی کرده و هزینه و مصرف انرژی را بهطور چشمگیری کاهش میدهد.
 پژوهش
هوش مصنوعی بر روی سرورهای Xeon: SetFit با سرعتشده توسط Intel
SetFit با بهرهگیری از Optimum Intel بر روی پردازندههای Xeon با سرعت بیسابقهای به قضاوتهای چند-خطی دست مییابد؛ مقاله این راهحل و روند بهینهسازی را بررسی میکند.
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 مدلها
بهینهسازی مدلهای جاسازی هوش مصنوعی روی CPU با Optimum Intel و fastRAG
روش جدید بهینهسازی مدلهای جاسازی (Embedding) با ابزار Optimum Intel و fastRAG برای اجرای سریع و کمهزینه روی پردازنده مرکزی، بدون افت کیفیت.
 اخبار
آموزش استفاده از خط لوله متنسازی هوش مصنوعی روی شتابدهنده اینتل گائودی ۲
اجرای مدلهای Llama 2 روی شتابدهنده Intel Gaudi 2 با خط لوله جدید Hugging Face ساده شد. در این مقاله روش استفاده و مزایای آن را میخوانید.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 سختافزار
هوش مصنوعی: سرعت جاندادانهای برای Llama 2 روی AWS Inferentia2
AWS Inferentia2 با همکاری Hugging Face و optimum‑neuron، Llama 2 را برای تولید متن به سرعتی بیسابقه بر روی سرورها میشکند. در این مقاله نقشه راه و نتایج آزمایشات را بررسی میکنیم.
 مدلها
بهینهسازی Bark با 🤗 Transformers: صدای واضح و سریعترین زمان
مطالعه جدید Hugging Face پردازش سریعتر و مصرف کمتر حافظه مدل Bark را با ابزارهای Transformers، Optimum و Accelerate توضیح میدهد؛ سهمرحله ساده برای عملکرد برتر.