
 پژوهش
هوش مصنوعی Papers with Code: قدرتمندتر از پیش با ابزارهای Hugging Face
بازسازی پلتفرم Papers with Code با تکیه بر Inference Endpoints، Jobs و Buckets هاتفیس؛ جستجوی معنایی، سرعت و دقت بالاتر برای پژوهشگران هوش مصنوعی.
 مدلها
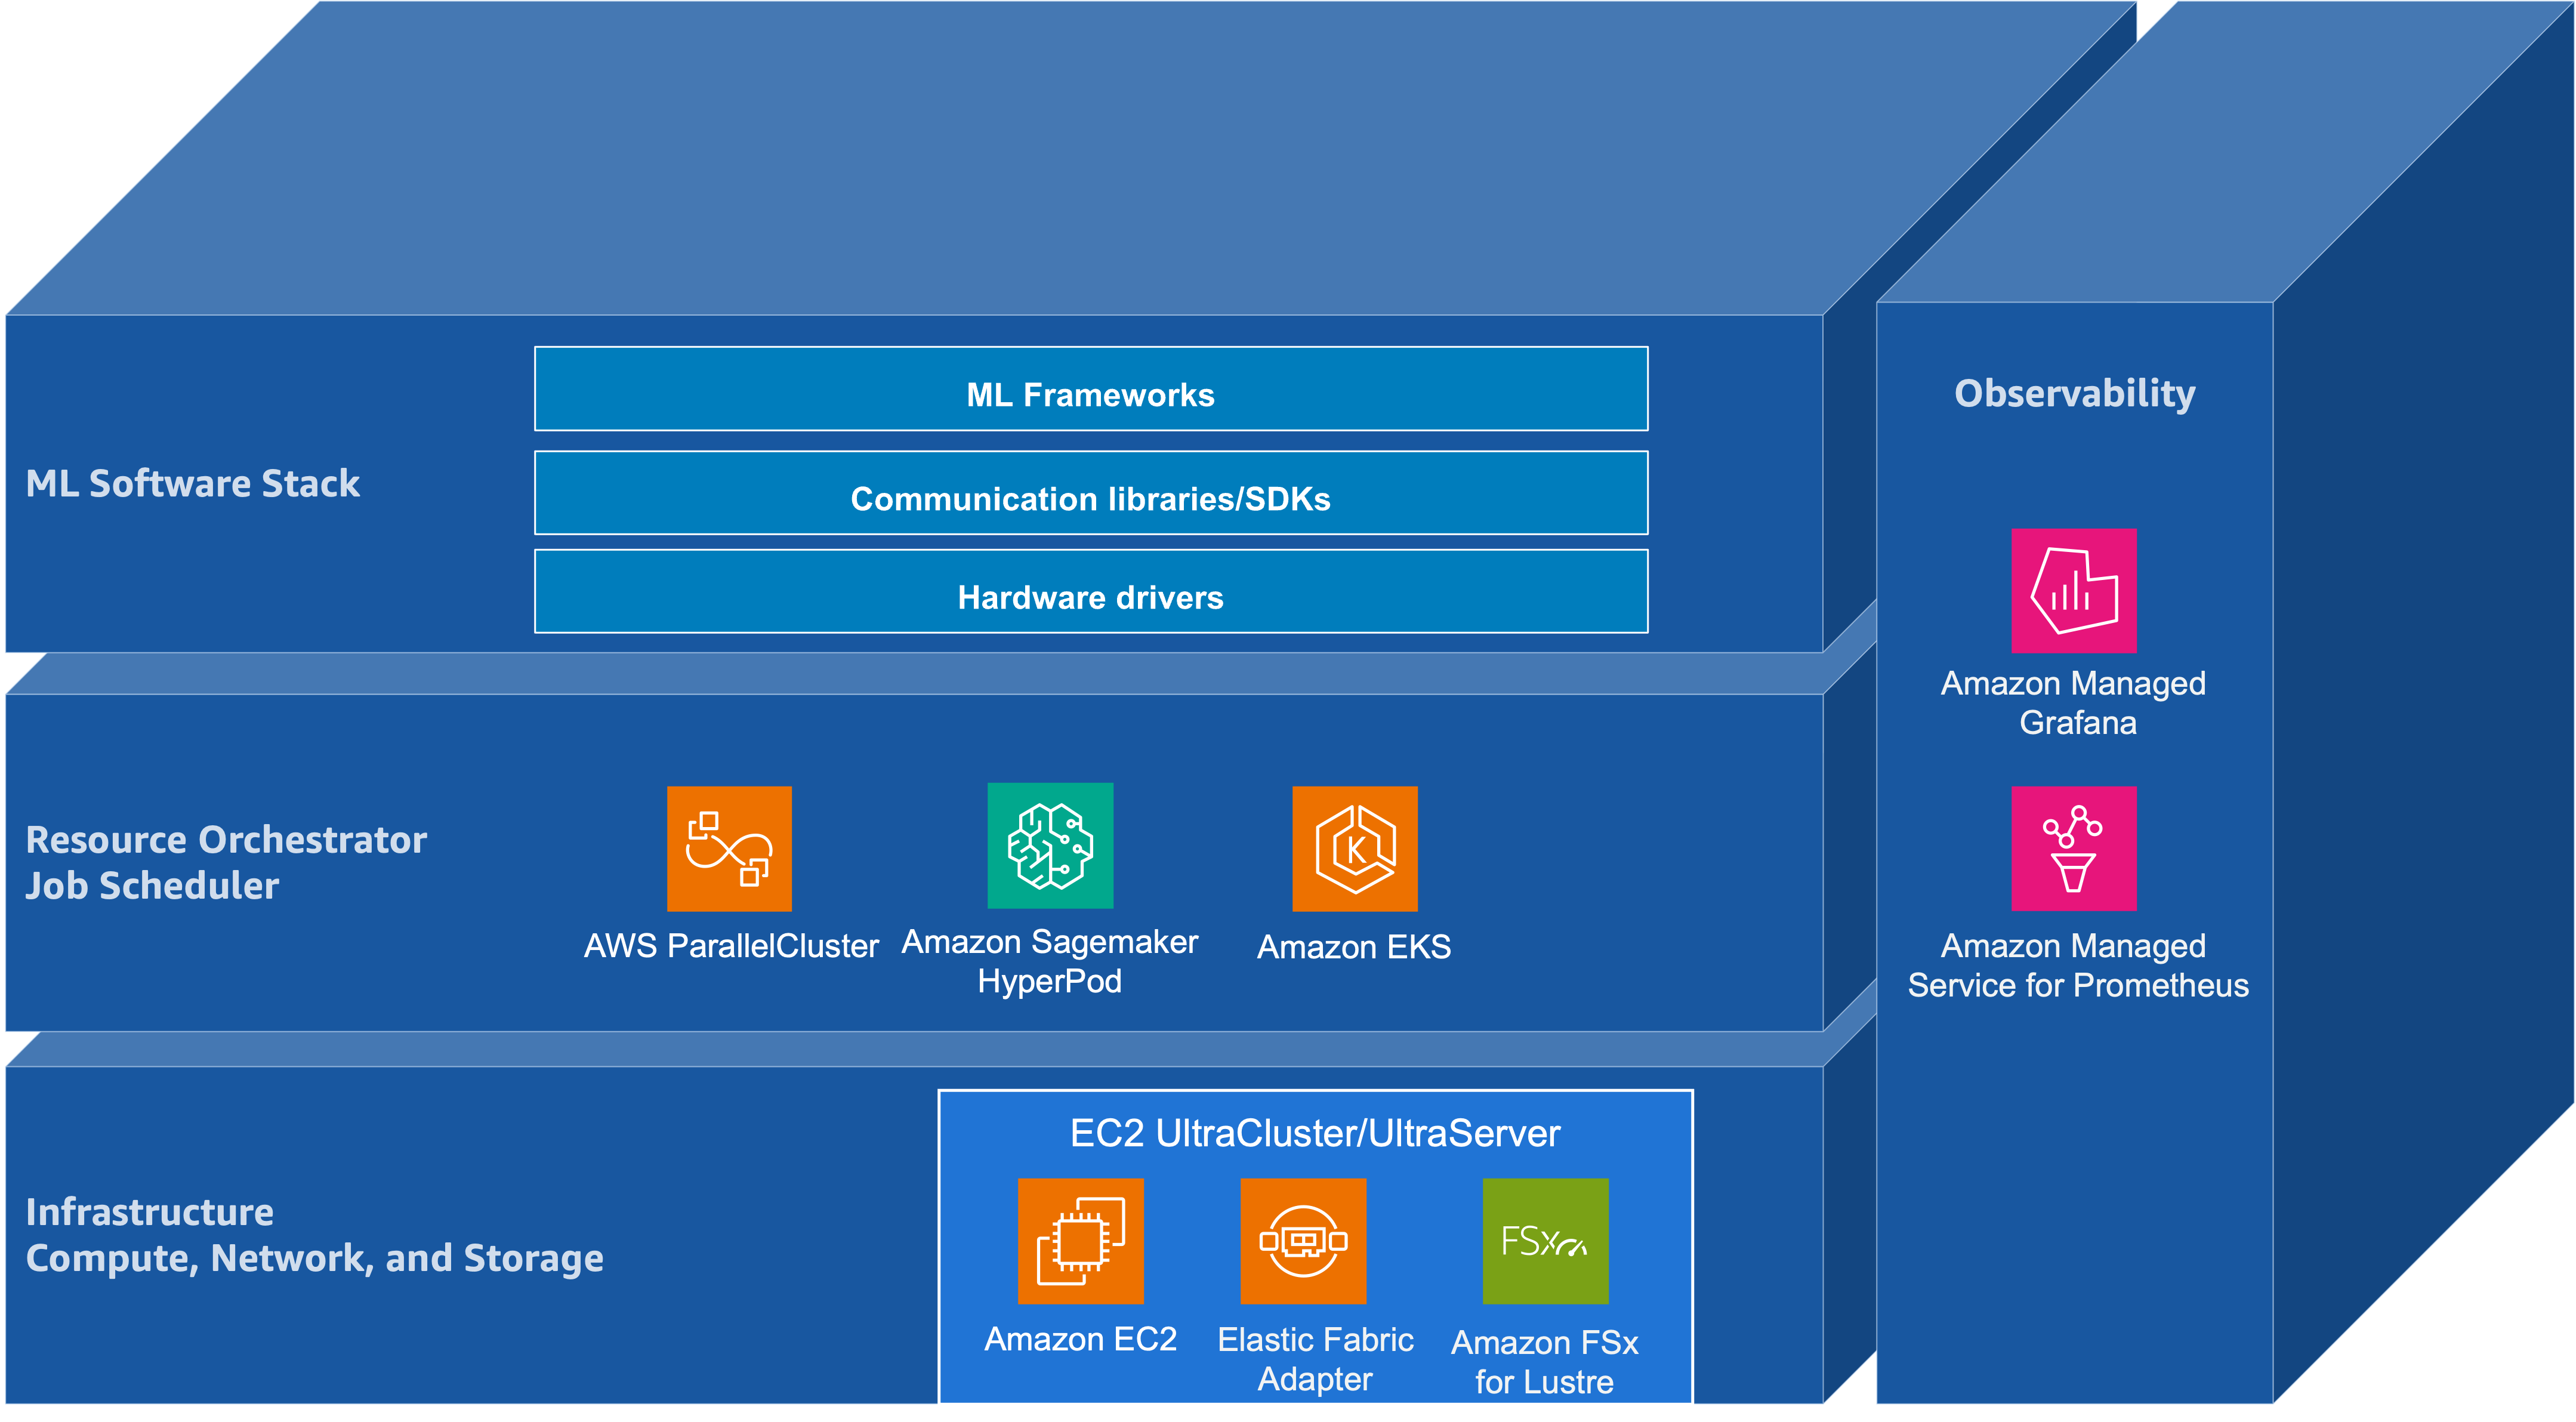
AWS: بلوکهای اساسی برای آموزش پیشرفته و تست مدلهای پایه هوش مصنوعی
در این مقاله به بررسی بلاکهای ساختاری مشارکت Amazon در آموزش و inference مدلهای پایه هوش مصنوعی روی پلتفرم AWS پرداختهایم. امکانات و نکات کلیدی را بررسی میکنیم.
 کسبوکار
هوش مصنوعی در کلاود: OVHcloud بهعنوان ارائهدهندهی جدید در Hugging Face
OVHcloud با یکپارچگی مطمئن در Hugging Face، خدمات پیشپرداز و سرورمدار بدون سرور را برای مدلهای هوش مصنوعی محبوبی مانند gpt-oss، Qwen3، DeepSeek R1 و Llama فراهم میکند.
 سختافزار
هوش مصنوعی در دستهی Groq: پیوستن به Hugging Face و سرعت بینظیر
Groq به تازگی به عنوان یک ارائهدهندهی استنتاج در Hugging Face Hub معرفی شد؛ تکنولوژی LPU™ آن، سرعت بیسابقهای را برای مدلهای زبانی سنگین فراهم میکند. این پیشرفت در حوزهی سرورلس و هوش مصنوعی چگونگی کارکرد آن چیست؟
 کسبوکار
سرعت بینظیر استنادات صوتی با Inference Endpoints هوش مصنوعی
هفتاد و نه درصد بهبود در سرعت استنادات صوتی با جدیدترین نسخه Whisper در Inference Endpoints؛ یک قدم در جهت آزادسازی هوش مصنوعی، سرعت و هزینه را کاهش میدهد.
 اخبار
هوش مصنوعی در شتاب TGI بر روی Intel Gaudi: راهنمای جامع
TGI (Text Generation Inference) با یکپارچگی نوین در پردازندههای Intel Gaudi، سرعت و کارایی مدلهای بزرگ زبان را به طور چشمگیری بهبود میبخشد و اجرای مدلهای LLM را در زمان کمتری ممکن میسازد؛ راهنمای جامع برای پیادهسازی و بهرهبرداری.
 اخبار
پیوستن Fireworks.ai به Hugging Face بهعنوان ارائهدهنده استنتاج: سرعت بالاتر برای هوش مصنوعی
پلتفرم Fireworks.ai بهصورت رسمی به اکوسیستم Hugging Face پیوست تا کاربران از استنتاج سرورلس سریعتر برای مدلهای هوش مصنوعی محبوب بهرهمند شوند.
 اخبار
همکاری Hugging Face و FriendliAI: جهشی بزرگ در استقرار مدلهای هوش مصنوعی
هوش مصنوعی با همکاری استراتژیک Hugging Face و FriendliAI به سرعت بیشتری در استقرار مدلها دست مییابد. این شراکت، دسترسی به زیرساختهای پیشرفته و NVIDIA H100 را برای توسعهدهندگان آسان میکند.
 محصولات
هوش مصنوعی با HUGS: راهکار نوین برای توسعه سریع مدلهای متن باز و مقیاسپذیر
HUGS (Hugging Face Generative AI Services) امکانات Zero‑Configuration inference را برای مدلهای متن باز فراهم کرده و سرعت و مقیاسپذیری توسعه AI را به سطح جدیدی میبرد.
 اخبار
پایان سرویس رایگان انفرونس با NVIDIA در হاجینگ فیس؛ جایگزین چیست؟
سرویس Serverless Inference مبتنی بر NVIDIA NIM در هاجینگ فیس از ۱۰ آوریل ۲۰۲۵ منسوخ شد. میتوانید با مرور این مقاله، جزئیات جایگزینها و پیامدهای آن برای مدلهای بازیابی اطلاعات را بیابید.