
 پژوهش
هوش مصنوعی در سفینهٔ Multi‑GPU با راهنمای Accelarate ND‑Parallel
افزایش سرعت و کارایی آموزش مدلهای بزرگ هوش مصنوعی با استفاده از ترکیب چندین شیوهٔ موازیسازی، بهوسیلهٔ کتابخانهٔ Accelerate ND‑Parallel.
 پژوهش
هوش مصنوعی در Liger GRPO: تقویت TRL با بهینهسازی حافظه و مقیاسپذیری
در این خبر، Liger GRPO با کاهش مصرف حافظه ۴۰٪ و افزودن امکانات FSDP و PEFT، آموزش RL را برای مدلهای بزرگ بهینه میکند و به تسهیل مقیاسپذیری در چند گپ تبدیل میشود.
 پژوهش
DeepSpeed و FSDP: با یکدیگر در پشتیبان هوش مصنوعی Hugging Face
دستگاههای DeepSpeed و FSDP در Hugging Face بهصورت متناظر در پردازش دادههای هوش مصنوعی به کار گرفته میشوند؛ مقاله اینبار تفاوتهای میان دو معماری و بهینهسازی در بحث توانمندسازی مدلها را بررسی میکند.
 پژوهش
هوش مصنوعی: خوشگذرینه تخصیص منابع برای fine-tuning Llama 2 70B در پایتورچ
Fine‑tuning مدل Llama‑2 70B را با PyTorch FSDP در هستهٔ هوش مصنوعی هدفگذاری کردهایم. از طریق واریسهای سفارشی، چالشهای سختافزاری و الگوریتمهای تقسیم پارامترها بهصورت دقیق در SLURM، بهحرفهای مدل را آموزش میدهیم.
 مدلها
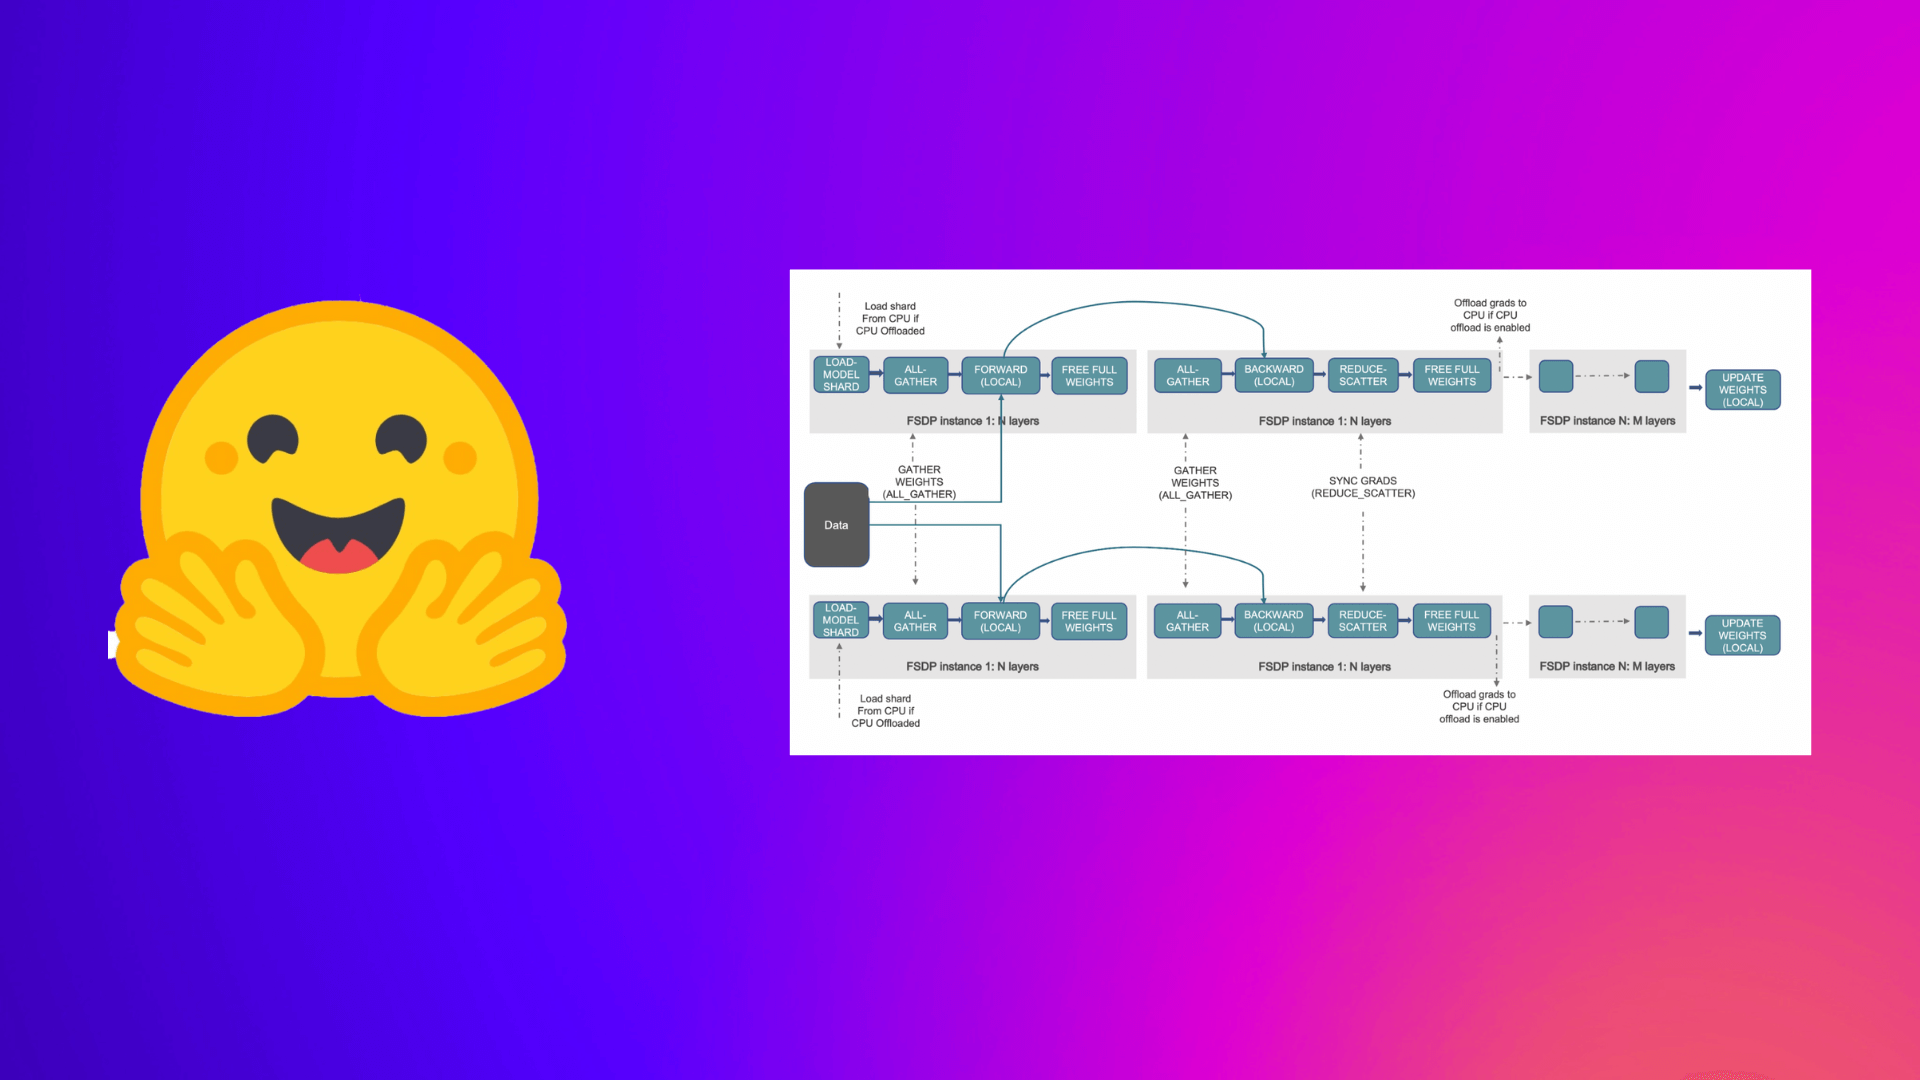
هوش مصنوعی در مقیاس بزرگ: PyTorch FSDP و Accelerate برای تسریع آموزش مدلهای عظیم
PyTorch FSDP با کتابخانه Accelerate موجب تسریع آموزش مدلهای عظیم میشود؛ بدون تغییر در کد، به راحتی مقیاس معادل Multi‑GPU و یادگیری بهسختافزار دست یابید.