مقدمه
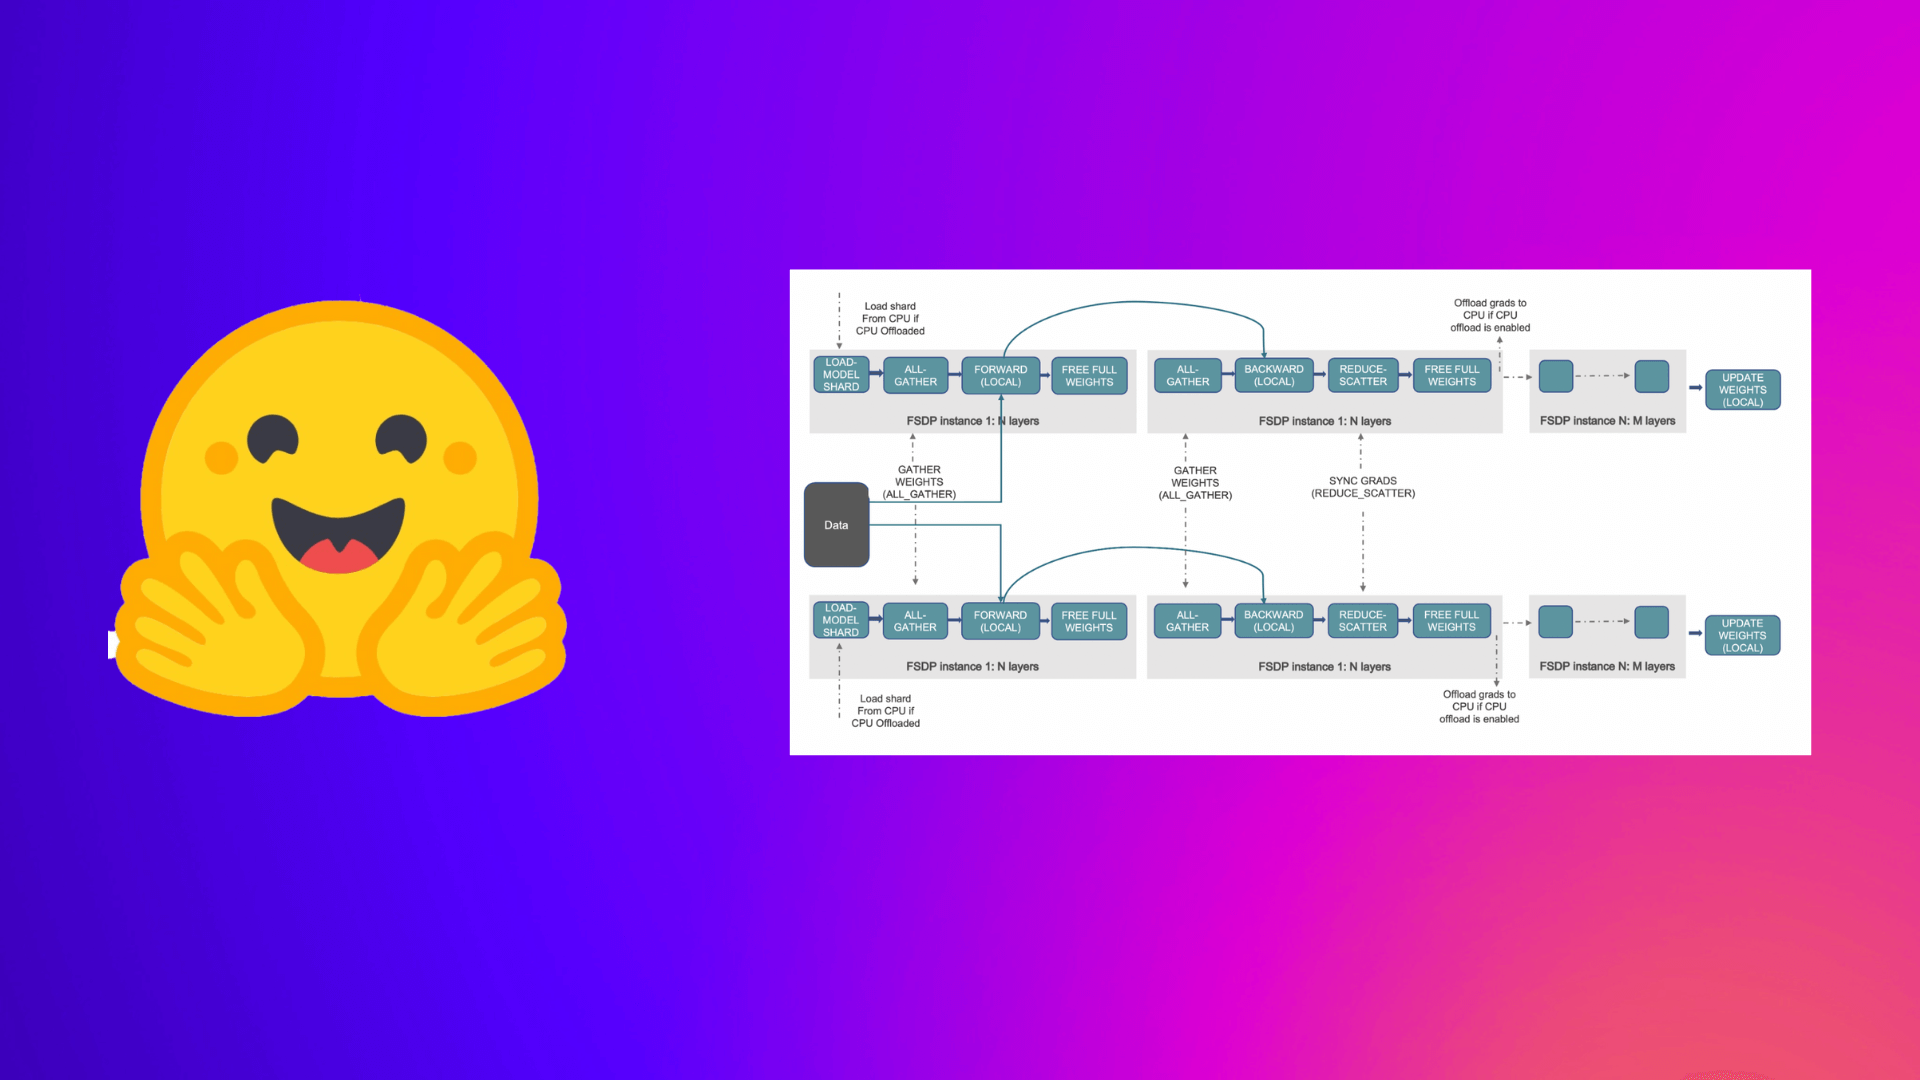
علاوه بر پیشرفتهای چشمگیر در معماری مدلهای هوش مصنوعی، مشکل وادی سازی و ذخیرهسازی پارامترهای میلیاردی هنوز پابرجاست. PyTorch'ها و ابزارهای Distributed Training نقش اساسی در رفع این محدودیت دارند.
چرا FSDP مهم است؟
- کاهش مصرف حافظه در هر گره تا 30٪
- کاهش زمان انتشار گرادیان با تقسیم شارژ پیادهسازی
- توانایی آموزش در شبکههای بزرگ با تعداد GPU بالا
کيف کار میکند با Accelerate
کتابخانه Accelerate نقطهٔ شروع کار است؛ از طریق کمینه تغییر در کد، اجرا بر روی FullyShardedDataParallel (FSDP) تبادل میشود. روند سادهٔ پیادهسازی در چند خط بهصورت زیر است:
model = FSDP(model) trainer = Accelerator()پرسشهای پرتکرار
FSDP در مقایسه با DataParallel چه مزیتی دارد؟
FSDP با تقسیمبندی کامل متغیرها در حافظه، مصرف RAM را بهدرستی کاهش میدهد و بهعلاوه نیازی به ازدواج حافظه میان GPUها ندارد، در حالی که DataParallel پارامترها را در همه دستگاهها تکثیر میکند.
چگونه میتوان با استفاده از Accelerate به سرعت FSDP را برای پروژهام پیادهسازی کردم؟
یکبار مطمئن شوید که PyTorch و کتابخانههای دیپ لیرنینگِ خود را به آخرین نسخه بروزرسانی کردهاید. سپس <code>Accelerator()</code> را ایجاد کرده و پارامترهای مدل، optimizer و dataloader را آن را فراخوانی کنید؛ با چند خط کد، آموزش شما به صورت خودکار در محیط چندگرافیک و با FSDP اجرا میشود.