
 پژوهش
هوش مصنوعی در تولید متن سریعتر: Self‑Speculative Decoding
بهبود سریعسازی تولید متن با استفاده از Self‑Speculative Decoding، که ترکیبی از تحلیل زودهنگام و بازنگری در لایههای LLM است، میتواند سرعت و مصرف حافظه را به طور چشمگیری کاهش دهد.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.
 پژوهش
هوش مصنوعی امن: لیور برد DecodingTrust و چالشهای جدید هوش مصنوعی
در آخرین پژوهش هابِیگنِگ فِیچ، لیور برد DecodingTrust بررسی جامع امنیت مدلهای بزرگ زبان (LLM) را معرفی میکند؛ نیاز به راهکارهای امنیتی برای هوش مصنوعی را برجسته میکند.
 پژوهش
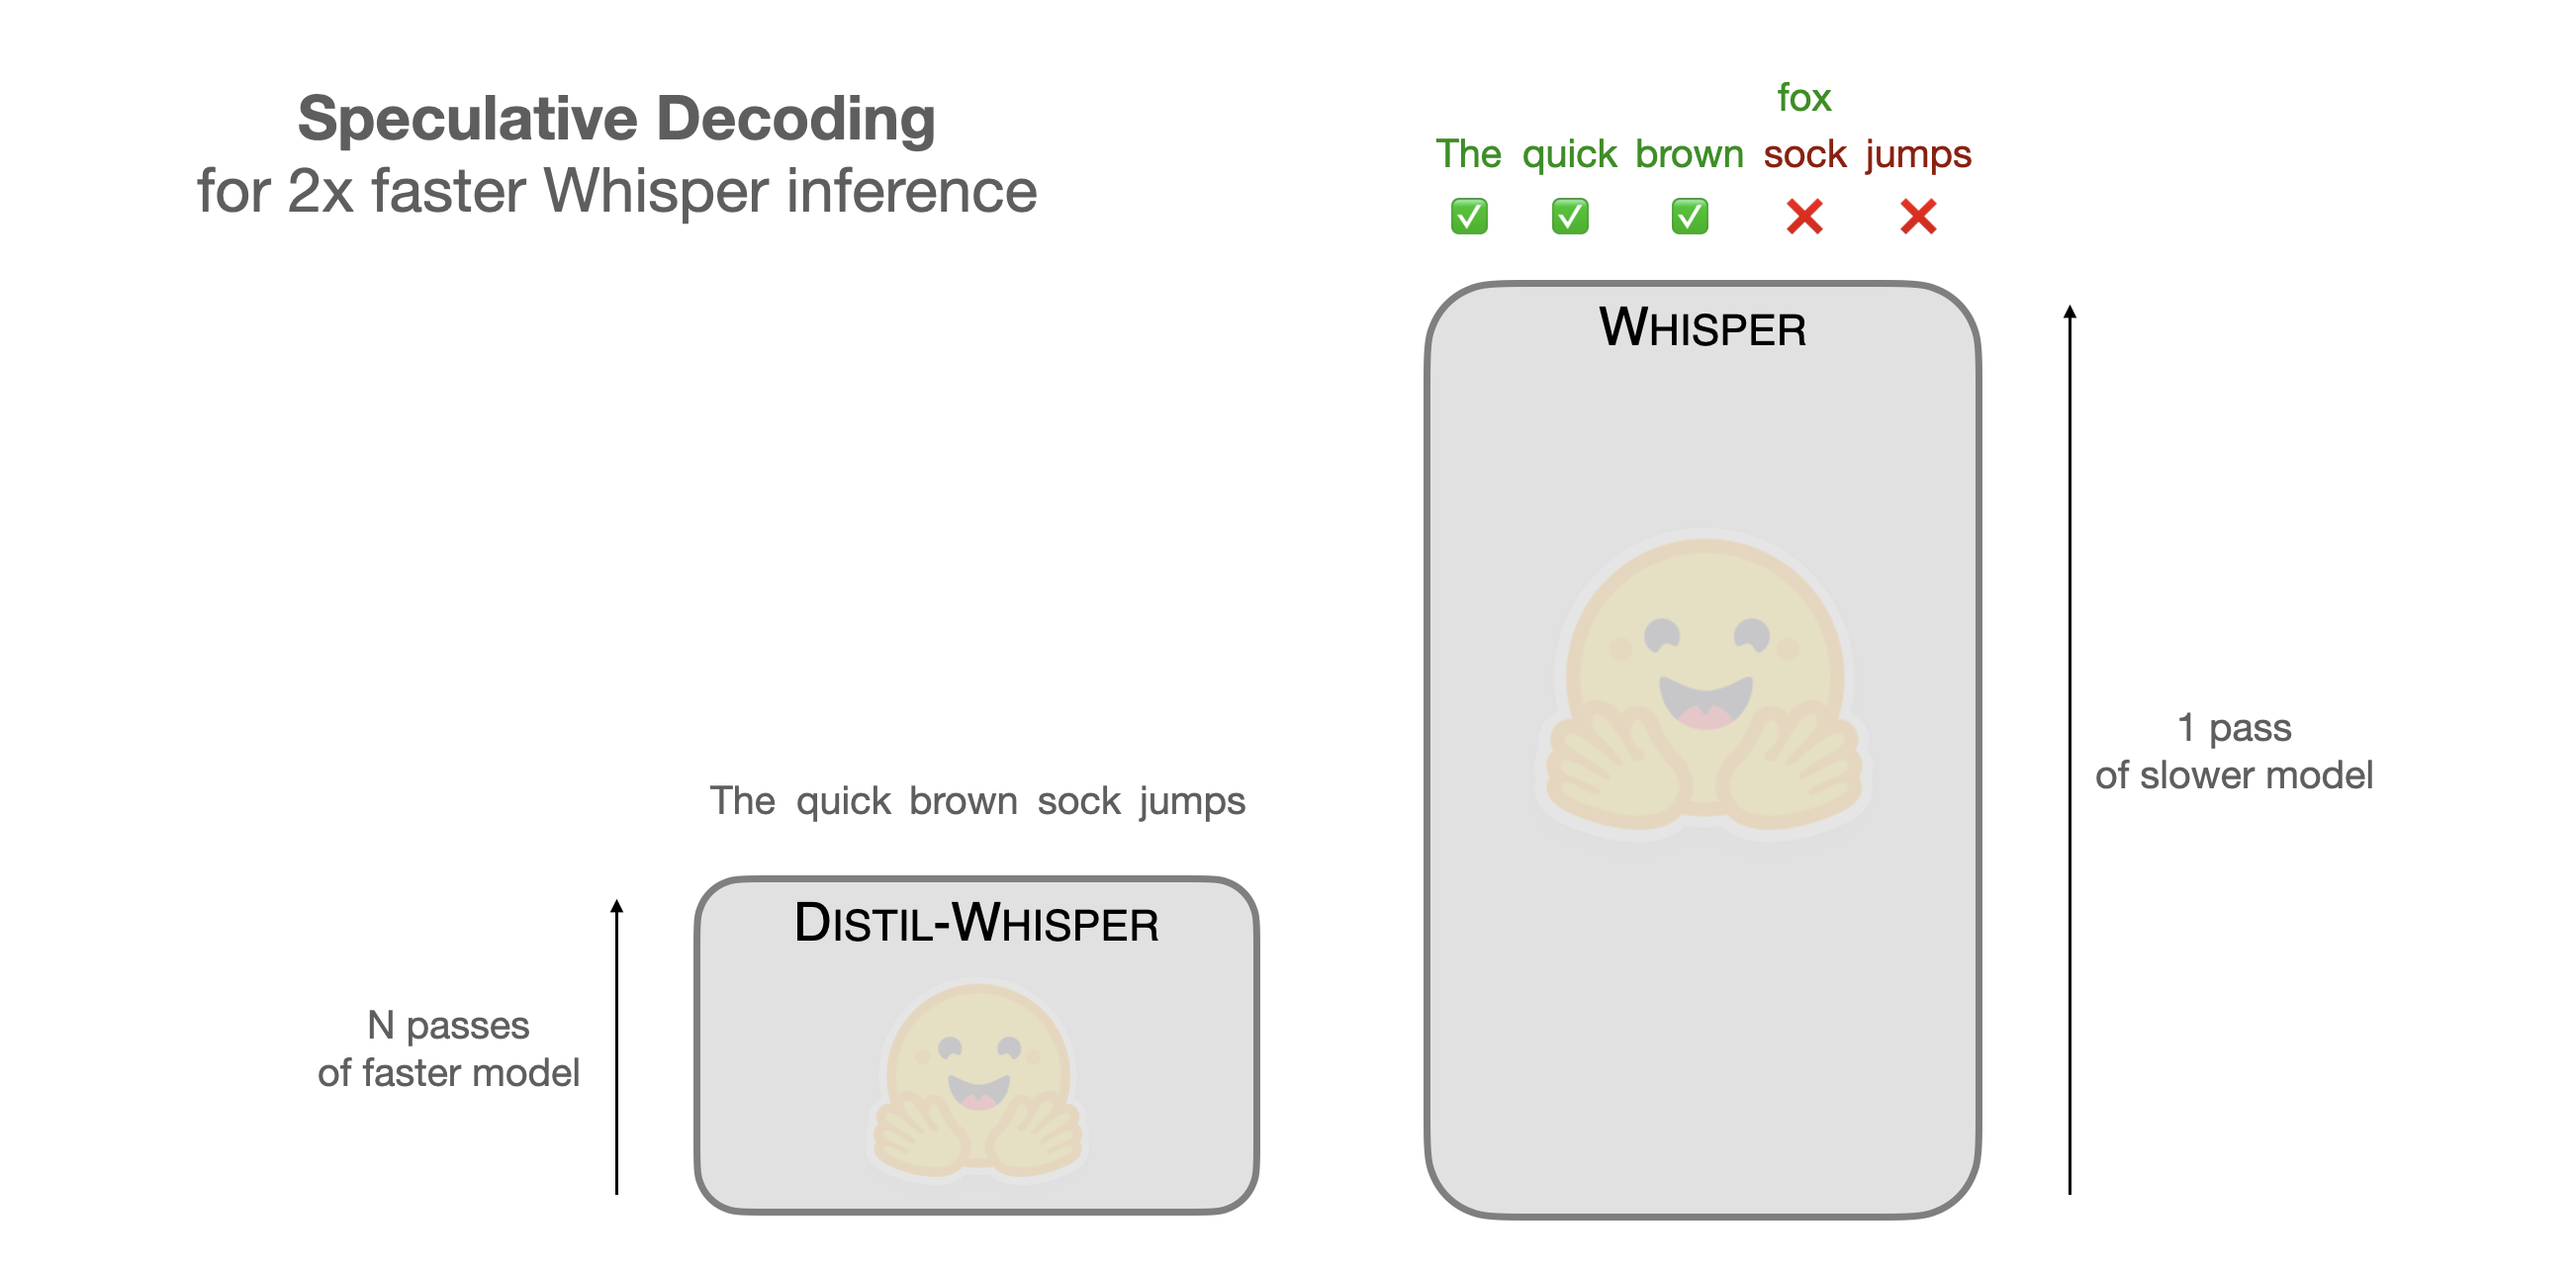
دو برابر سرعت ورایشر با Speculative Decoding در پردازش گفتار
استفاده از تکنیک Speculative Decoding در مدل Whisper، سرعت پردازش گفتار را دو برابر میکند و دقت آن را حفظ میدارد؛ یک گام مهم در توسعهٔ هوش مصنوعی
 آموزش
تولید متن با هوش مصنوعی: بررسی روشهای Decoding در مدلهای زبانی
در این مقاله از وبلاگ هوما، روشهای مختلف تولید متن با مدلهای زبانی مانند جستجوی حریصانه، beam search، sampling و top-p را بررسی میکنیم و نحوه پیادهسازی آنها را با کتابخانه transformers یاد میگیریم.