
 مدلها
Granite Switch 4.1؛ یک هوش مصنوعی برای گفتگو، تصمیمگیری و گفتار
مدل Granite Switch 4.1 آیبیام، گفتگو، تصمیمهای عمومی و تخصصی و تشخیص گفتار را از یک endpoint واحد با اشغال VRAM برابر مدل پایه ارائه میدهد.
 پژوهش
هوش مصنوعی Papers with Code: قدرتمندتر از پیش با ابزارهای Hugging Face
بازسازی پلتفرم Papers with Code با تکیه بر Inference Endpoints، Jobs و Buckets هاتفیس؛ جستجوی معنایی، سرعت و دقت بالاتر برای پژوهشگران هوش مصنوعی.
 پژوهش
هوش مصنوعی و DPO؛ راهکاری نوین برای مهار چرخههای تکراری در مدلهای OCR
پژوهشگران Dharma-AI در مقاله جدیدی نشان میدهند که با Direct Preference Optimization و جفتهای رد شده از خروجیهای نامطلوب خود مدل، نرخ تخریب متن در مدلهای OCR کاهش مییابد.
 کسبوکار
سرعت بینظیر استنادات صوتی با Inference Endpoints هوش مصنوعی
هفتاد و نه درصد بهبود در سرعت استنادات صوتی با جدیدترین نسخه Whisper در Inference Endpoints؛ یک قدم در جهت آزادسازی هوش مصنوعی، سرعت و هزینه را کاهش میدهد.
 مدلها
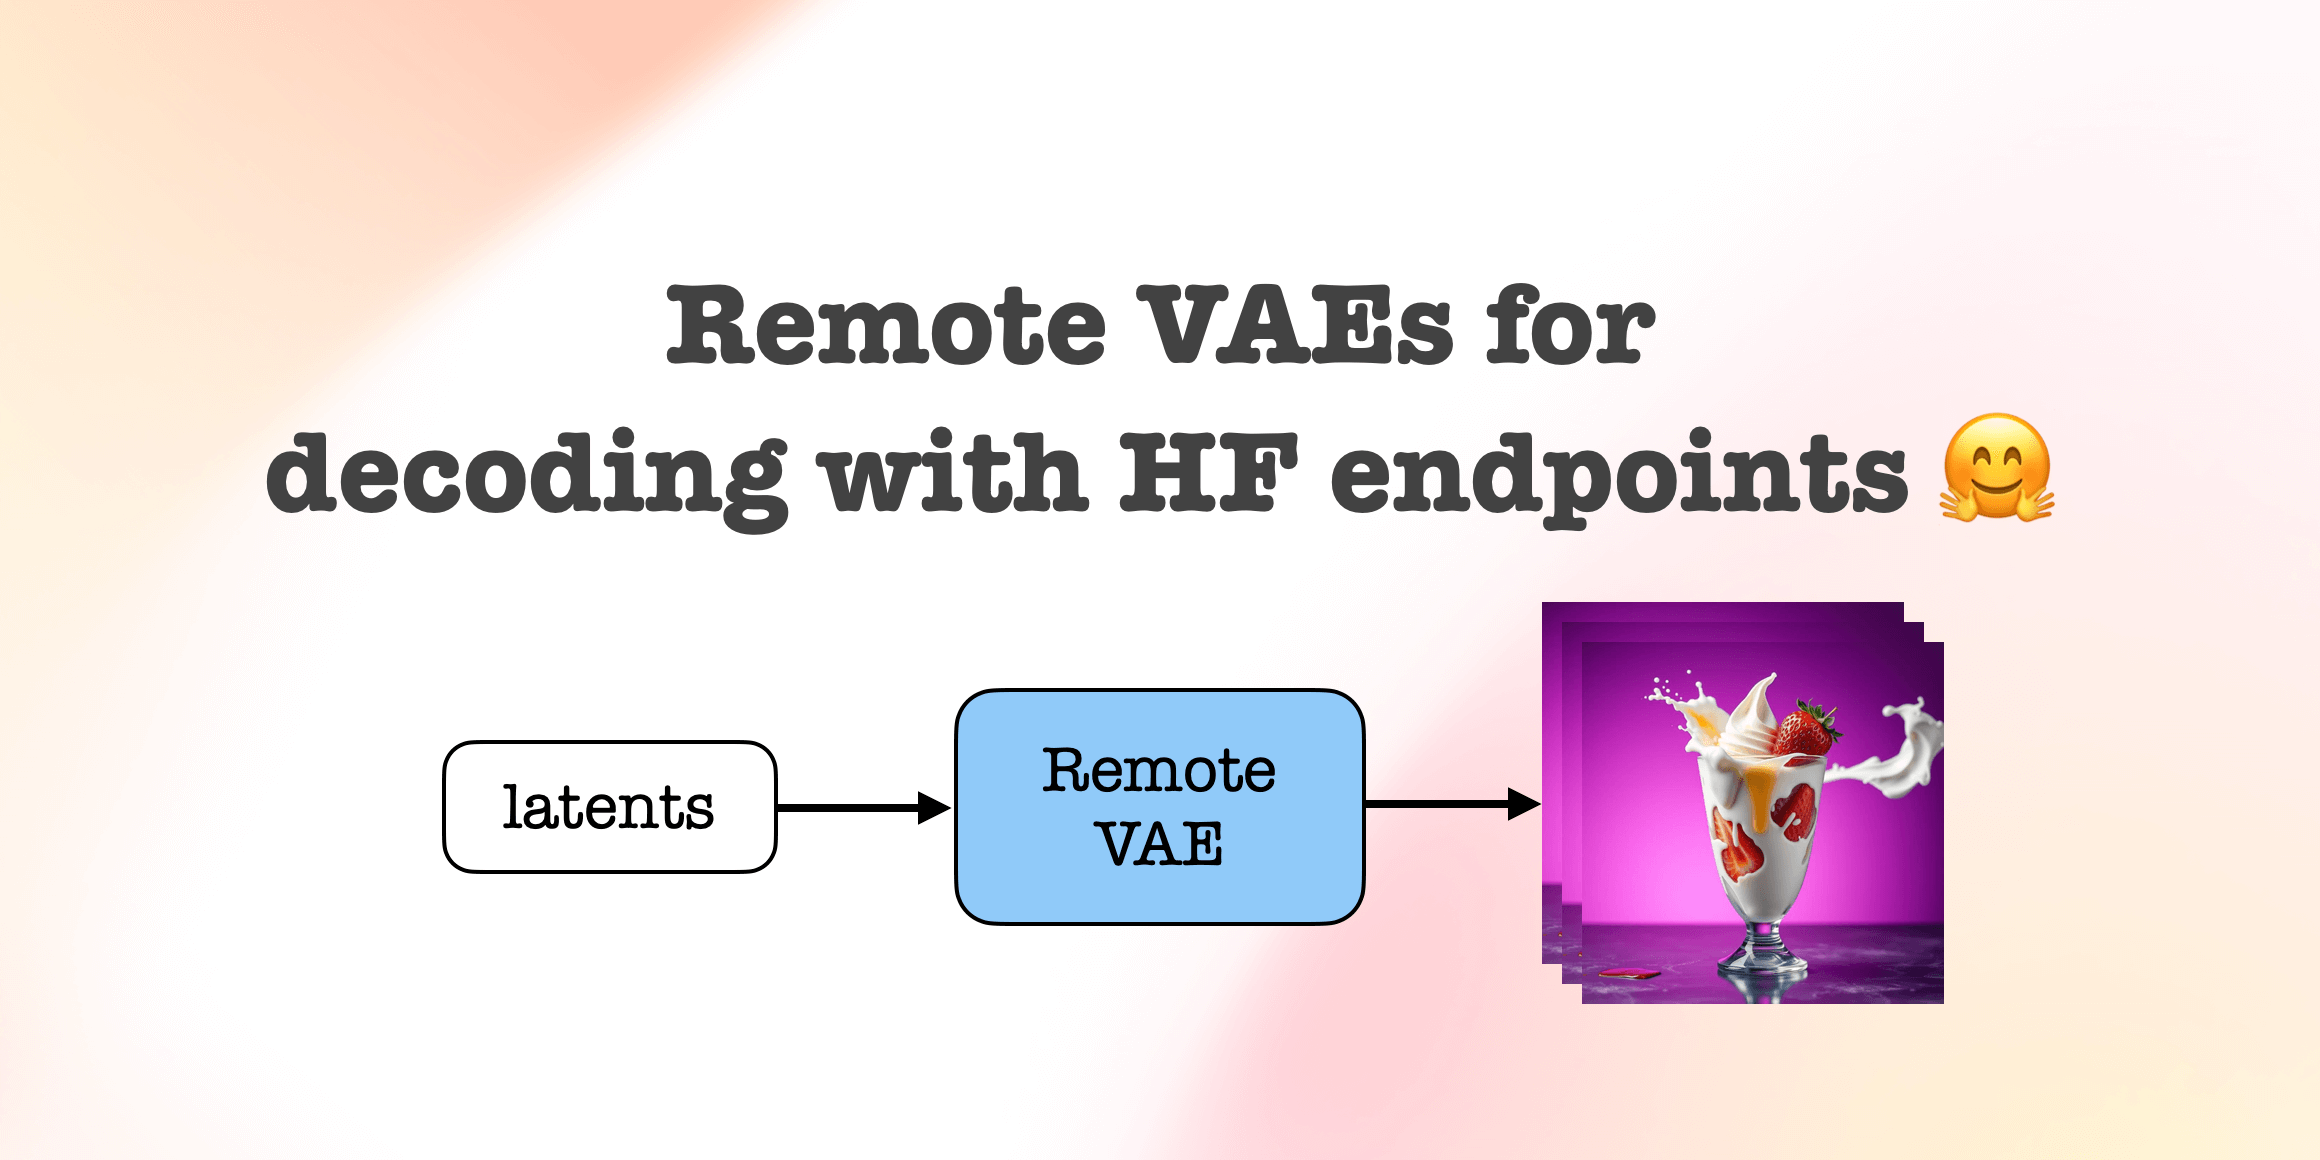
هوش مصنوعی با Remote VAE ها: تسهیل پردازش تصویر با اِندپوینت خارج از سازمان
Hugging Face با Remote VAE، پردازش دیسک‑کدینگ تصاویر و ویدیوها را با مصرف حافظه کمتر و سرعت بالاتر با استفاده از Endpoints ارائه میکند.
 سختافزار
Hugging Face راهاندازی endpointهای هوش مصنوعی بر روی AWS Inferentia2
پلتفرم Hugging Face با معرفی endpointهای جدید مبتنی بر AWS Inferentia2 امکان قیمتپذیر و سریعتر اجرای بیش از 100,000 مدل هوش مصنوعی را فراهم کرده است.
 پژوهش
هوش مصنوعی با حریم شخصی: اجرای حوسبهپوشیده در Hugging Face Endpoints
دستگاههای پیشرفتهٔ FHE برای اجرای مدلسازی هوش مصنوعی در محیط امن و معکوسشدهٔ Hugging Face Endpoints معرفی شدند؛ روند و نکات کلیدی برای توسعهدهندگان و پژوهشگران.
 پژوهش
هوش مصنوعی: بهبود مدلهای زبانی با روشهای بهینهسازی ترجیحات مستقیم
در آخرین پژوهش از هاگفیس، روشهای بهینهسازی ترجیحات مستقیم میتوانند مدلهای زبانی را بدون استفاده از یادگیری تقویتی همگرا کنند. نتایج نشان میدهد IPO مشابه DPO و بهتر از KTO است.
 پژوهش
همراه با هوش مصنوعی: آموزش فاینتوینس پیشرفته Stable Diffusion با DDPO و TRL
در این مقاله، نحوهی استفاده از الگوریتم DDPO در فاینتوینس مدلهای Stable Diffusion را با ابزار TRL توضیح میدهیم. کارایی نسبت به سامانههای سنتی نشان داده شده است.
 پژوهش
هوش مصنوعی در لامّا ۲: آموزش مستقیم با DPO و سادهسازی RLHF
در این مقاله، نحوهی آموزش مستقیم لامّا ۲ با روش DPO در Hugging Face بررسی میشود؛ سادهسازی یادگیری بازخورد انسانی و مزایای آن توضیح داده میشود.