
 مدلها
هوش مصنوعی: کشف حافظه کوانتیزه برای تولید متن طولانی در مدلهای بزرگ
کاهش مصرف حافظه در تولید متن طولانی با کوانتیزه کردن KV Cache، راهحلی قابل تنظیم برای مدلهای بزرگ – معیارهای عملکرد و کیفیت بدون کاهش قابل توجهی در خروجی.
 پژوهش
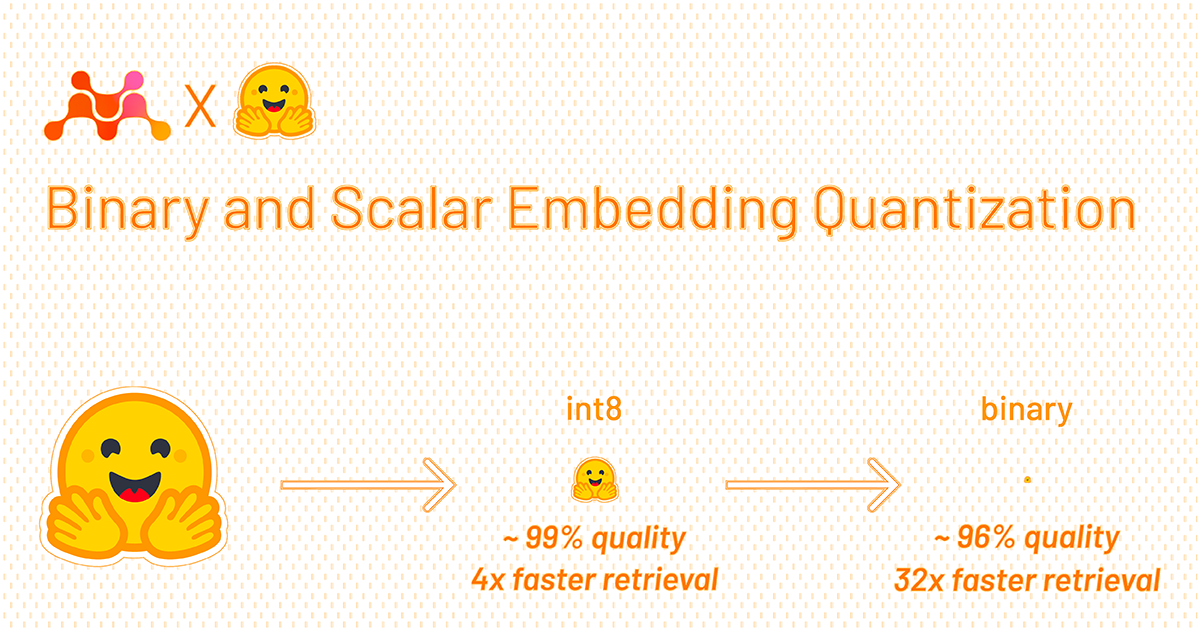
کمتر شدن هزینه و افزایش سرعت بازیابی دادهها با کوانتیزهسازی هوش مصنوعی
Hugging Face روشهای کوانتیزهسازی باینری و اسکالر را برای کاهش بهمراتب مصرف حافظه و افزایش سرعت بازیابی مدلهای ادغام در ۴۱ میلیون سند ویکیپدیا معرفی کرد. این فناوری دموکراتیزاسیون هوش مصنوعی را تسهیل میکند.
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 مدلها
بهینهسازی مدلهای جاسازی هوش مصنوعی روی CPU با Optimum Intel و fastRAG
روش جدید بهینهسازی مدلهای جاسازی (Embedding) با ابزار Optimum Intel و fastRAG برای اجرای سریع و کمهزینه روی پردازنده مرکزی، بدون افت کیفیت.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.
 پژوهش
کشف مزایا و معایب کوانتیزهسازی مدلهای هوش مصنوعی در Transformers
متن به بررسی مزایا و معایب دو روش کوانتیزهسازی، BitsAndBytes و AutoGPTQ، در کتابخانه Transformers میپردازد و راهنمایی برای انتخاب مناسب ارائه میدهد.
 پژوهش
Stable Diffusion XL در مک با کوانتیزهکردن پیشرفته Core ML: آیندهی هوش مصنوعی در دسترس
Stable Diffusion XL بر پایهٔ Core ML بهینه شده و در دسکتاپهای مک اجرا میشود. با تکنیکهای کوانتیزهکردن پیچیده، کیفیت تصاویر بالا و سرعت ذخیرهسازی بهترین است.