
 اخبار
Apertus 1.5: تحولی در هوش مصنوعی متنباز با درک تصویر، صوت و استدلال
Apertus 1.5 با ادامه پیشآموزش و افزودن ۴ تریلیون داده جدید، درک چندحالته و حالت تفکر را به مدلهای متنباز میآورد و پنجره زمینه را چهار برابر میکند.
 پژوهش
Granite 4.1: هوش مصنوعی IBM امکان پردازش 512k توکن در بلاکهای بزرگ
شرکت IBM با معرفی خانواده مدلهای بزرگ LLM ۴.۱ Granite، پردازش متن را با ۱۵ تریلیون توکن و امکان پردازش متون ۵۱۲ هزاریه و برای استفاده ابری افزایش میدهد.
 پژوهش
FLUX‑2 از Black Forest Labs: مدل جدید تولید تصویر با هوش مصنوعی
Hugging Face با انتشار FLUX‑2، مدل تولید تصویر جدیدی را معرفی کرده که با معماری تازه، پیشآموزش از صفر، و پشتیبانی از ورودیهای چندگانه دستانوی و متنی ارائه میدهد.
 پژوهش
هوش مصنوعی: رقابت E2LM 2025 – ارزیابی زودهنگام مدلهای زبانی
در قالب جدید پیشآموزش مدلهای زبانی، رقابت E2LM 2025 مهندسان را میطلبد؛ نتایج در NeurIPS 2025 اعلام خواهد شد با سه ماه برای ثبتنام
 اخبار
فکان ۲؛ مدل زبانی ۱۱ پارامتری با قابلیت چندزبانی و پشتیبانی بصری
فکان ۲ (Falcon 2) مدل زبانی جدید با ۱۱ میلیارد پارامتر است که با بیش از ۵۰۰۰ میلیارد توکن و پشتیبانی از ۱۱ زبان آموزش دیده و هم بهصورت متنی و هم بصری کار میکند.
 پژوهش
کازموپدیا؛ انقلاب دادههای سنتتیک در پیشآموزش مدلهای هوش مصنوعی
هاگینگ فیس مجموعهداده سنتتیک کازموپدیا را با میلیاردها توکن برای بازتولید عملکرد Phi-1.5 منتشر کرد؛ گامی بزرگ در تولید داده برای هوش مصنوعی.
 مدلها
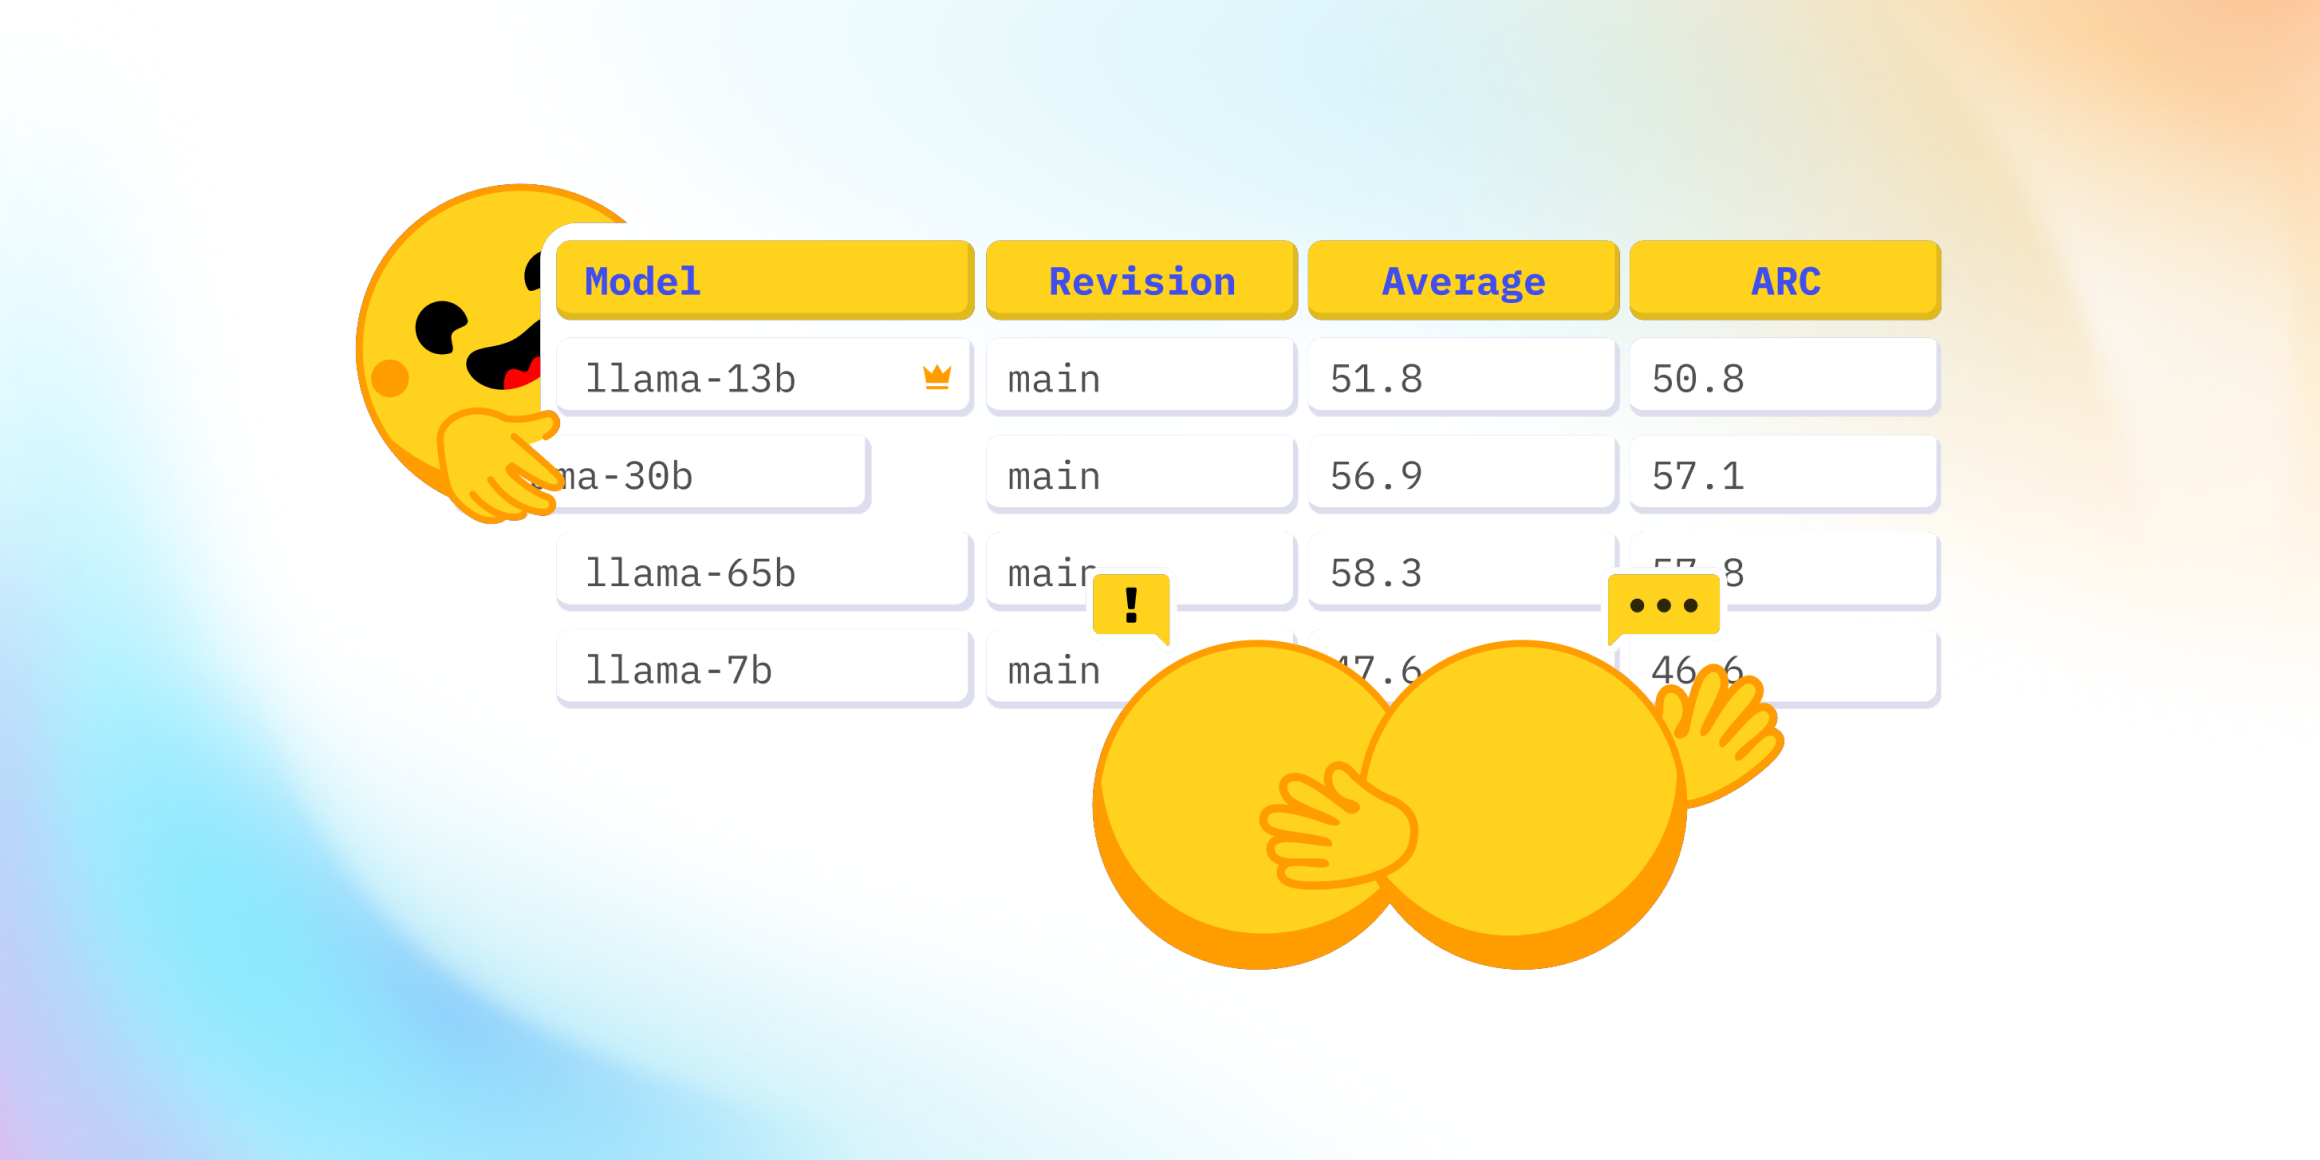
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 پژوهش
هوش مصنوعی SpeechT5: تبدیل متن به گفتار، گفتار به متن و همگرایی مدل
SpeechT5، مدلی یکپارچه متن‑به‑گفتار، گفتار‑به‑متن و همگرایی مدل، با پیشآموزش چندمودال بر روی دادههای ترکیبی، در پردازش زبان گفتاری عملکرد برتری ارائه میدهد.
 پژوهش
هوش مصنوعی در اوج: PaddlePaddle وارد هاب Hugging Face به شد
پروژه PaddlePaddle از بیدود در سال 2016، اکنون به هاب Hugging Face پیوست و این ادغام باعث دسترسی آسانتر به مدلهای پیشآموزش دیده در حوزههای متن، تصویر، صدا و ویدئو میشود.
 مدلها
سکشنسیون تصویر بدون آموزش: CLIPSeg، الگوریتم جدید هوش مصنوعی دریافت
مدل جدید CLIPSeg با رویکرد Zero‑Shot سکشنسیون تصاویر را بدون برچسبگذاری پیشآموزشپذیر میکند؛ در این مقاله از کاربردها، روش پیادهسازی و نکات کلیدی آن میآموزیم.