
 مدلها
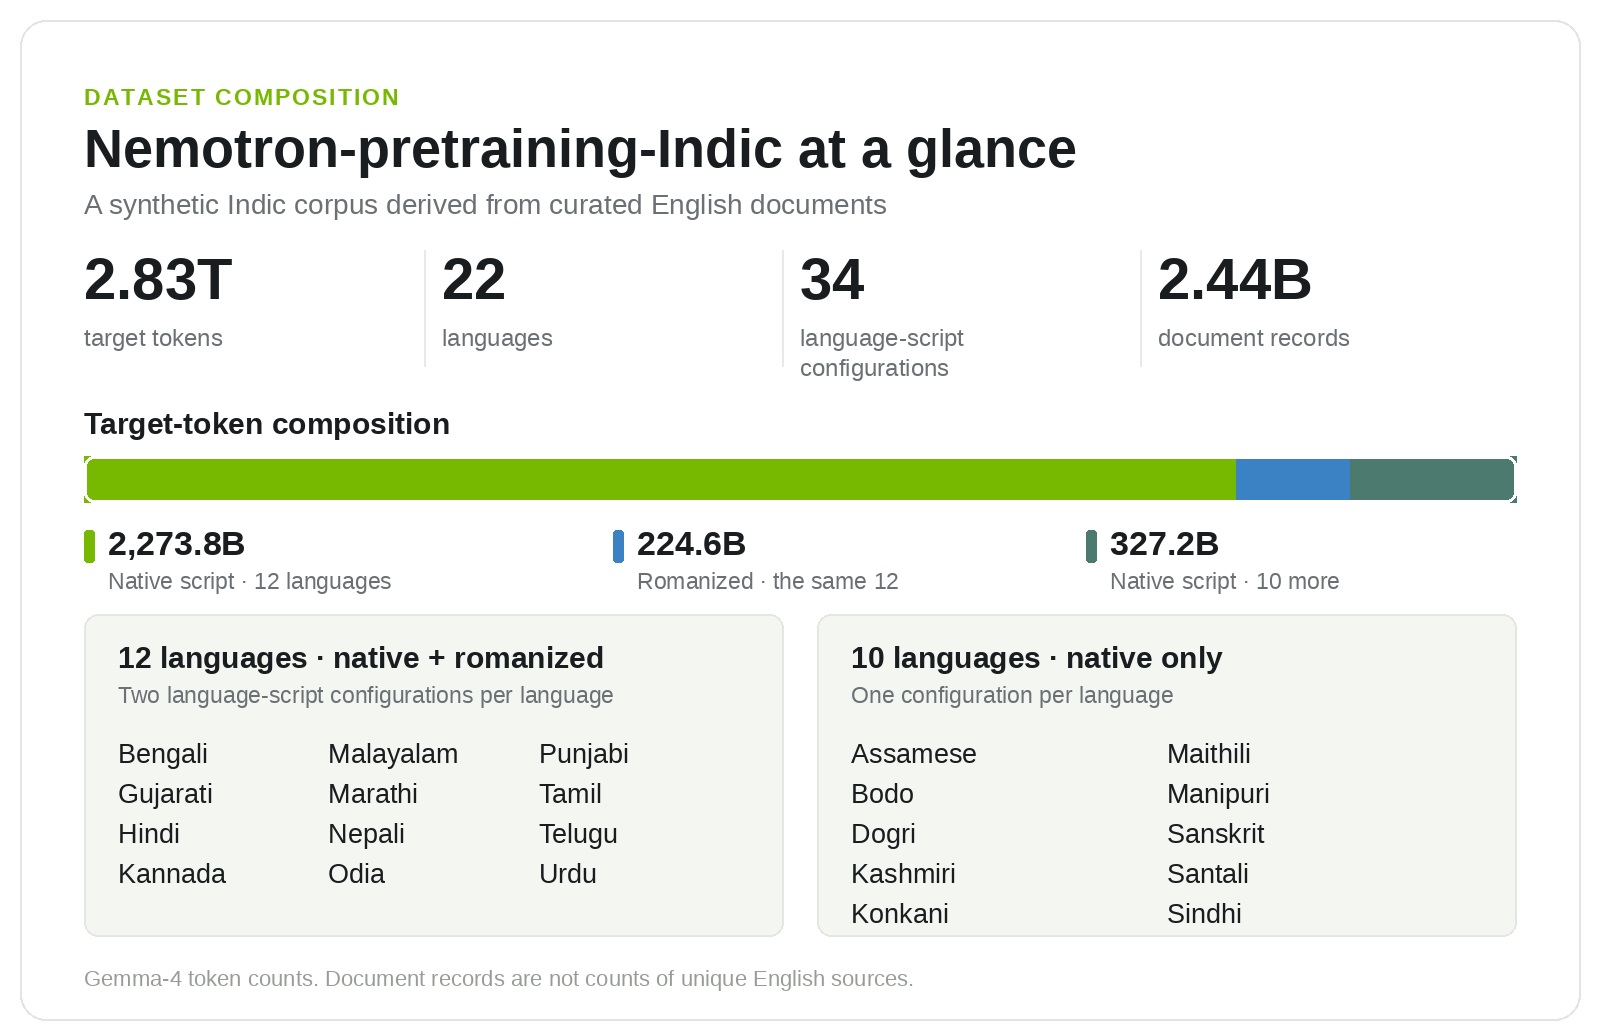
NVIDIA مجموعه داده ۲.۸ تریلیون توکنی برای آموزش هوش مصنوعی هندی منتشر کرد
NVIDIA با همکاری AI4Bharat مجموعهداده عظیم ۲.۸ تریلیون توکنی برای ۲۲ زبان هندی منتشر کرد؛ گامی بلند برای آموزش مدلهای زبانی هوش مصنوعی.
 پژوهش
هوش مصنوعی و امنیت سایبری: چرا شفافیت کلیدپایه آینده در دنیای دیجیتال؟
در این مقاله به بررسی نقش شفافیت در فرهنگ هوش مصنوعی و تأثیر آن بر امنیت سایبری میپردازیم. پروژههای Mythos و Glasswing و چالشهای ناشی از آینده.
 مدلها
تحلیل دادهها با ChatGPT
یاد بگیرید که چگونه با ChatGPT مجموعه دادهها را بررسی کنید، بینش ایجاد کنید، مصورسازی ایجاد کنید و یافتهها را به تصمیمات عملی تبدیل کنید.
 پژوهش
SAIR: دادههای سهبعدی پروتئین‑لیگاند برای پیشبینی IC₅₀ با هوش مصنوعی و شتابگذاری داروپژوهی
مجموعهداده بزرگ SAIR، بیش از ۵ ملیون ساختار سهبعدی پروتئین‑لیگاند همراه با مقادیر IC₅₀، به پژوهشگران امکان میدهد با هوش مصنوعی فرآیند کشف دارو را به سرعت بینظیر پیش ببرند.
 پژوهش
برندمارک 3LM: استاندارد نوین هوش مصنوعی عربی در STEM و برنامهنویسی
برندمارک ۳LM، استانداردی جدید برای ارزیابی مدلهای زبانی عربی در حوزههای علمی‑فناوری و برنامهنویسی، با تمرکز بر مسائل تخصصی و کد. در این مقاله به جزئیات روش، مجموعه دادهها و نتایج کلیدی میپردازیم.
 پژوهش
LeRobot به مدرسه رانندگی میرود: بزرگترین مجموعه داده خودران متنباز جهان
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 پژوهش
هوش مصنوعی و چالش جدید: ارزیابی استدلال صوتی با Big Bench Audio
مجموعه داده Big Bench Audio به کمک هوش مصنوعی، توانایی استدلال مدلهای صوتی را میسنجد؛ نتایج اولیه نشان میدهد مدلهای گفتاربهگفتار از مدلهای بومی جلوترند.
 پژوهش
لیست برداری هوش مصنوعی: ورود LLMهای ژاپنی به هافینگ فیس
این مقاله لیستبرداری Open Japanese LLM در هافینگ فیس را معرفی کرده؛ از ۲۰+ مجموعه داده و چالشهای ژاپنی در کنار ابزارهای پیادهسازی را جمعآوری کردهاند.
 پژوهش
معرفی کنسول SQL در مجموعه دادهها
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 مدلها
هوش مصنوعی با مدل SmolLM: سرعت بیسابقه و کارایی خارقالعاده
مدل SmolLM، خانواده کوچک و قدرتمندی از هوش مصنوعی با 135M، 360M و 1.7B پارامتر، بر پایه مجموعه داده قوی ساخته شده و امکان اجرا بر دستگاههای محلی را فراهم میکند.