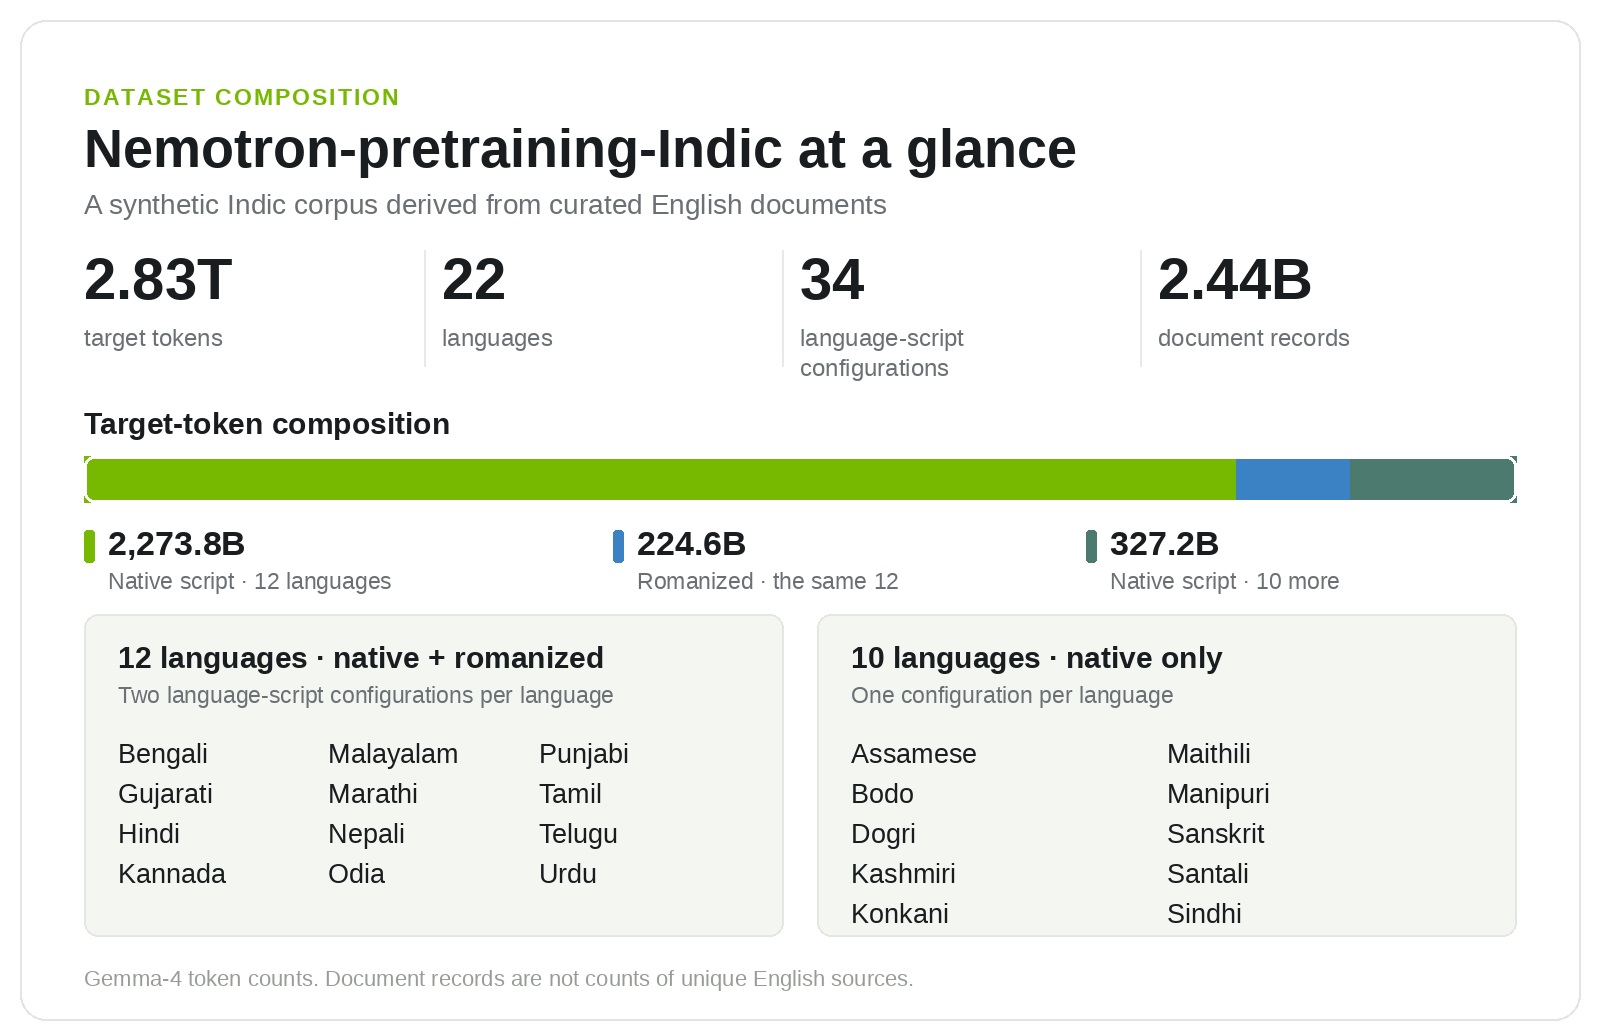
در دنیای مدلهای زبانی، داده حرف اول را میزند. حالا NVIDIA با انتشار مجموعهداده «Nemotron-pretraining-Indic-v1» گام مهمی برای پوشش زبانهای هندی برداشته است. این مجموعهداده حدود ۲.۸ تریلیون توکن را در ۲۲ زبان هند در بر میگیرد و با یک خط لوله باز و مبتنی بر GPU تولید شده است.
مجموعهداده Nemotron-pretraining-Indic-v1 چیست؟
این مجموعهداده که با همکاری تیم AI4Bharat و NVIDIA توسعه یافته، یکی از بزرگترین منابع دادههای متنی برای زبانهای هندی به شمار میرود. دادههای آن شامل متنهای بومی برای ۲۲ زبان و دادههای رومیسازیشده برای ۱۲ زبان است. این تنوع، امکان آموزش مدلهای هوش مصنوعی را در طیف وسیعی از زبانها و خطها فراهم میکند.
خط لوله باز تولید داده؛ از انگلیسی تا زبانهای هندی
یکی از نکات برجسته این پروژه، طراحی یک خط لوله باز و قابل استفاده مجدد برای تولید داده است. این خط لوله مبتنی بر GPU، مراحل ترجمه، ارزیابی کیفیت و تعمیر دادهها را خودکار انجام میدهد. به این ترتیب، پژوهشگران میتوانند از دادههای انگلیسی بهعنوان منبع استفاده کرده و محتوای باکیفیتی به زبانهای هندی تولید کنند.
- دادههای بومی برای ۲۲ زبان هندی
- دادههای رومیسازیشده برای ۱۲ زبان
- خط لوله GPU-accelerated برای ترجمه و کیفیتسنجی
- قابلیت بازتولید و سازگاری با نیازهای جدید
قابلیتهای گسترده در Nemotron 3.5 Super VL
پس از ادامه پیشآموزش بر روی این مجموعهداده، تواناییهای زبانی مدل Nemotron 3.5 Super VL بهطور چشمگیری در زبانهای هندی بهبود یافته است. این بهبود شامل درک بهتر متن، تولید پاسخهای دقیقتر و عملکرد قویتر در کاربردهای چندزبانه هوش مصنوعی میشود.
جمعبندی
انتشار مجموعهداده ۲.۸ تریلیون توکنی NVIDIA، گامی مهم در جهت توسعه هوش مصنوعی برای زبانهای کممنبع است. با ارائه خط لوله باز تولید داده و تأکید بر شفافیت، این پروژه میتواند الگویی برای پژوهشهای آینده در سایر زبانها و مناطق باشد.
پرسشهای پرتکرار
مجموعه داده Nemotron-pretraining-Indic-v1 شامل چه زبانهایی است؟
این مجموعه داده حدود ۲.۸ تریلیون توکن را در ۲۲ زبان هندی پوشش میدهد؛ دادههای بومی برای ۲۲ زبان و دادههای رومیسازیشده برای ۱۲ زبان در آن ارائه شده است.
خط لوله تولید داده NVIDIA چه ویژگیهایی دارد؟
خط لوله باز و مبتنی بر GPU برای ترجمه، ارزیابی کیفیت و تعمیر دادهها بهکار میرود و امکان بازتولید و سازگاری آن با نیازهای جدید فراهم است.