
 پژوهش
هوش مصنوعی در عربی: روند نوین ارزیابی کیفیت مدلهای LLM – راهنمای QIMMA
معرفی QIMMA، لواردبورد پیشرفتهٔ عربی با پردازش کیفیت بیخطا، موجب دستکاری دقیقتر نتایج ارزیابی مدلهای زبانی عربی میشود.
 پژوهش
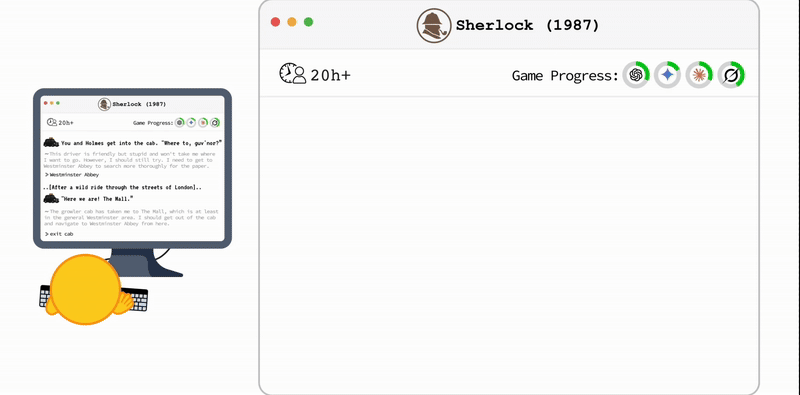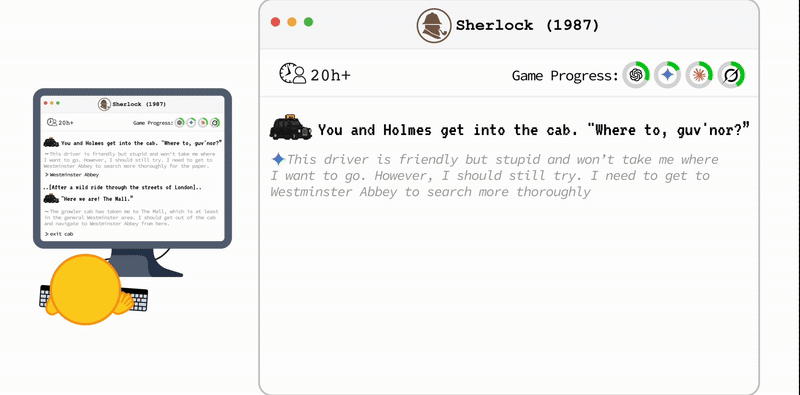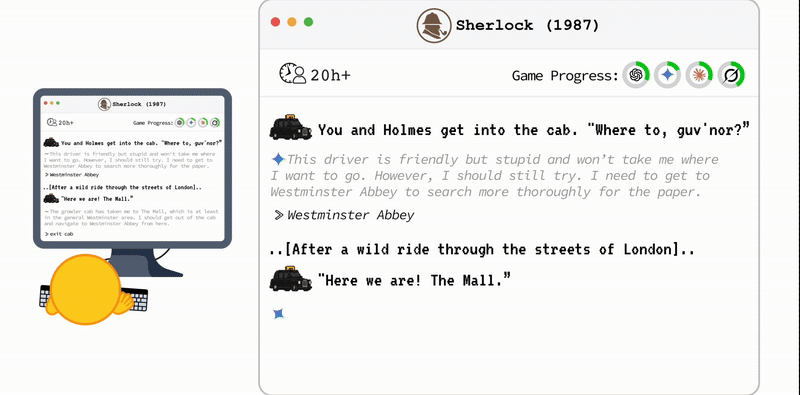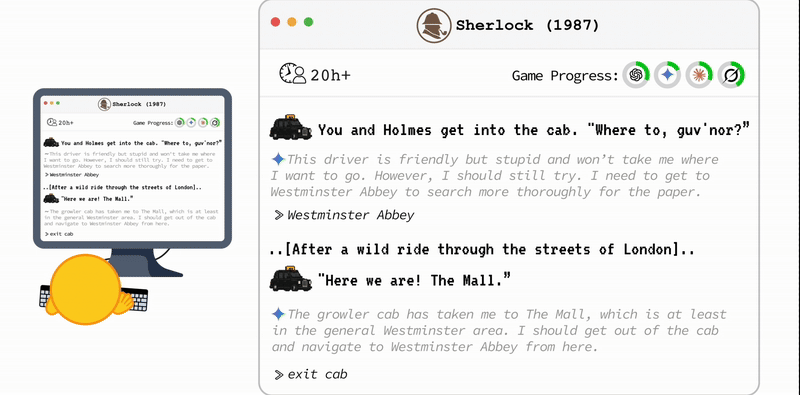
هوش مصنوعی در بازیهای ویدئویی متنی: عملکرد LLMs و چالشها
این مقاله به بررسی توانایی مدلهای زبان بزرگ در بازیهای متنی میپردازد، روشهای ارزیابی، چالشهای فنی و راهکارهای بهبود را بررسی میکند.
 پژوهش
مسابقه بحث چندزبانه مدلهای هوش مصنوعی: کیفیت و اعتماد
در این مسابقهی جدید، Hugging Face ادغام مدلسازی چندزبانه و ارزیابیهای چندوجهی را در قالب بحثهای زنده به نمایش میگذارد، تا تواناییهای استدلال و زبان مدلها را بسط دهد.
 پژوهش
هوش مصنوعی در زبان چک: BenCzechMark و آزمون دقیق مدلهای LLM
بنچکمارک اولین مجموعه ارزیابی جامع برای مدلهای بزرگ زبان (LLM) در زبان چک را معرفی میکند. با ۵۰ کار و ۹ حوزه، عملکرد زبانپردازی را اینچنین بررسی میکند.
 پژوهش
BigCodeBench: هوش مصنوعی در ارزیابی برنامهنویسی انسانی نسل بعدی
BigCodeBench یک بنچمارک جامع جدید برای ارزیابی توانمندیهای زبانهای بزرگ مدل در حل مسایل برنامهنویسی انسانی به همراه پوشش بالای ۹۹٪ تست است.
 پژوهش
آیندهساز کدنویسی: لیورورد LiveCodeBench و ارزیابی هوش مصنوعی بر رمز و تلاقی
LiveCodeBench یک بنچمارک نوین برای ارزیابی تولید کد توسط مدلهای هوش مصنوعی است که با استفاده از مسائل واقعی مسابقات برنامهنویسی، ارزیابیهای زمانی و تست خروجی را پوشش میدهد.