
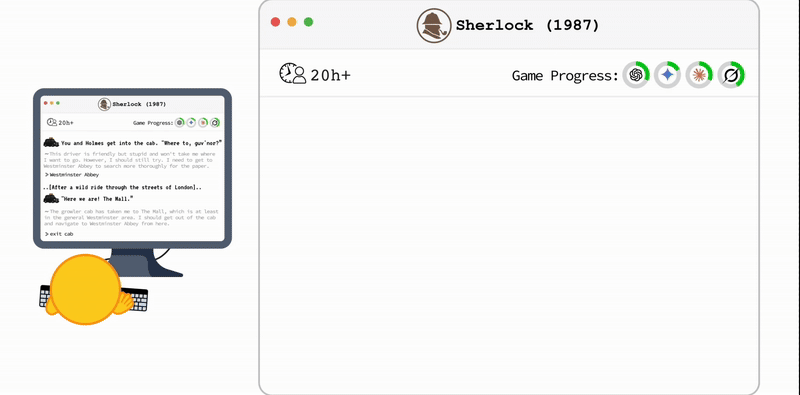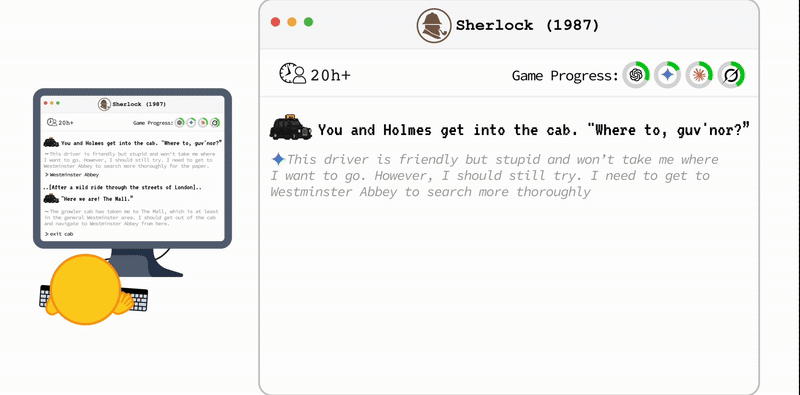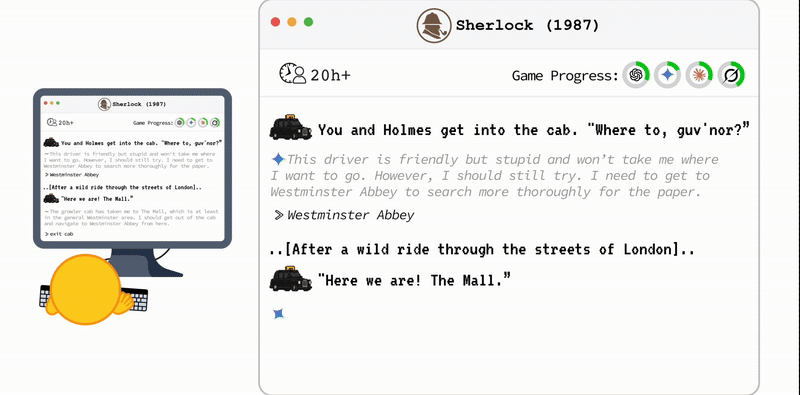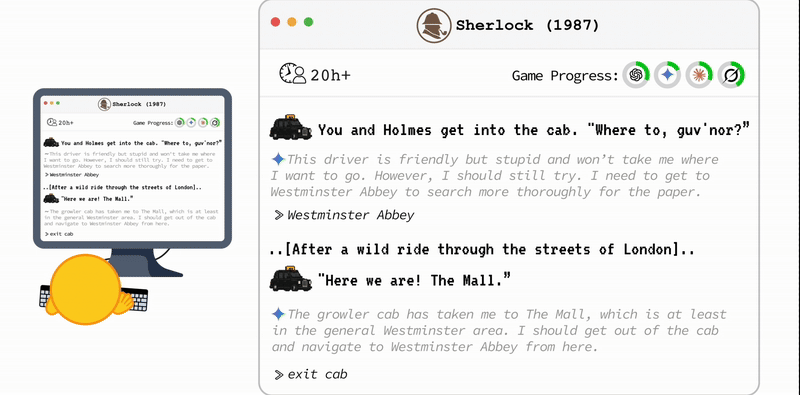
چرا بازیهای متنی مهماند
بازیهای متنی، با ترکیب داستانسرایی، فکری و تصمیمگیری، امکان ارزیابی تواناییهای درک متن و استدلال در محیطهای پویا را فراهم میکنند. این ویژگیها برای توسعه رباتهای هوشمند واقعی ضروری است.
روش ارزیابی LLMs در بازیهای متنی
تحقیقگران روی مجموعهای از بازیهای متنی ساده تا پیچیده کار میکنند تا به میزان دقت و توانایی تطبیق LLM ها در حل پازلها، تعامل با شخصیتها و مدیریت منابع پیوند بزنند. برای این منظور، همانگونه که در مقالات بهروز آمده است، از سکو Hugging Face و مستندات TextQuests استفاده میشود.
- چالشهای بینظیر تعادلی بین حافظه طولانیمدت و پردازش سریع
- نیاز به الگوریتمهای تصمیمگیری مبتنی بر بازخورد یادگیری همزمان
- محدودیت در دسترسی به اطلاعات تاریخی بازیکن در طول طول بازهی بازی
هشدارها و راهنماییها برای پژوهشگران
مطمئن بودن از تعادل میان سختکوشی مدل و هزینه زمان پردازش، و همچنین حمایت از بازخوردهای انسانی جهت بهبود مدل، در این حوزه مهمترین نکات اساسی هستند. پژوهشگران باید بهطور مداوم دادهها را بازبینی کنند تا جلوی «دوبارهفکر» مدل در زمینههای خاص را بگیرند.
پرسشهای پرتکرار
آیا LLM ها میتوانند بازیهای متنی را بهصورت کامل حل کنند؟
LLMها در حال حاضر در حالتخانهای میتوانند برخی از بازیهای ساده متنی را حل کنند، اما برای بازیهای پیچیدهتر که نیاز به یادگیری بلندمدت و تصمیمگیری در مواجهه با فرضیات جدید دارند، هنوز محدودیتهایی وجود دارد.
چه چالشهایی در ارزیابی LLM ها در بازیهای متنی وجود دارد؟
ارزیابی درمجموعههای بازیهای متنی شامل چالشهایی مثل حافظه محدود، نیاز به تعامل چندمرحلهای، و عدم وجود استانداردهای مشترک برای سنجش دقت و اثربخشی است، که پژوهشگران در حال توسعه رویکردهای جدید برای غلبه بر این مشکلات هستند.


