
 پژوهش
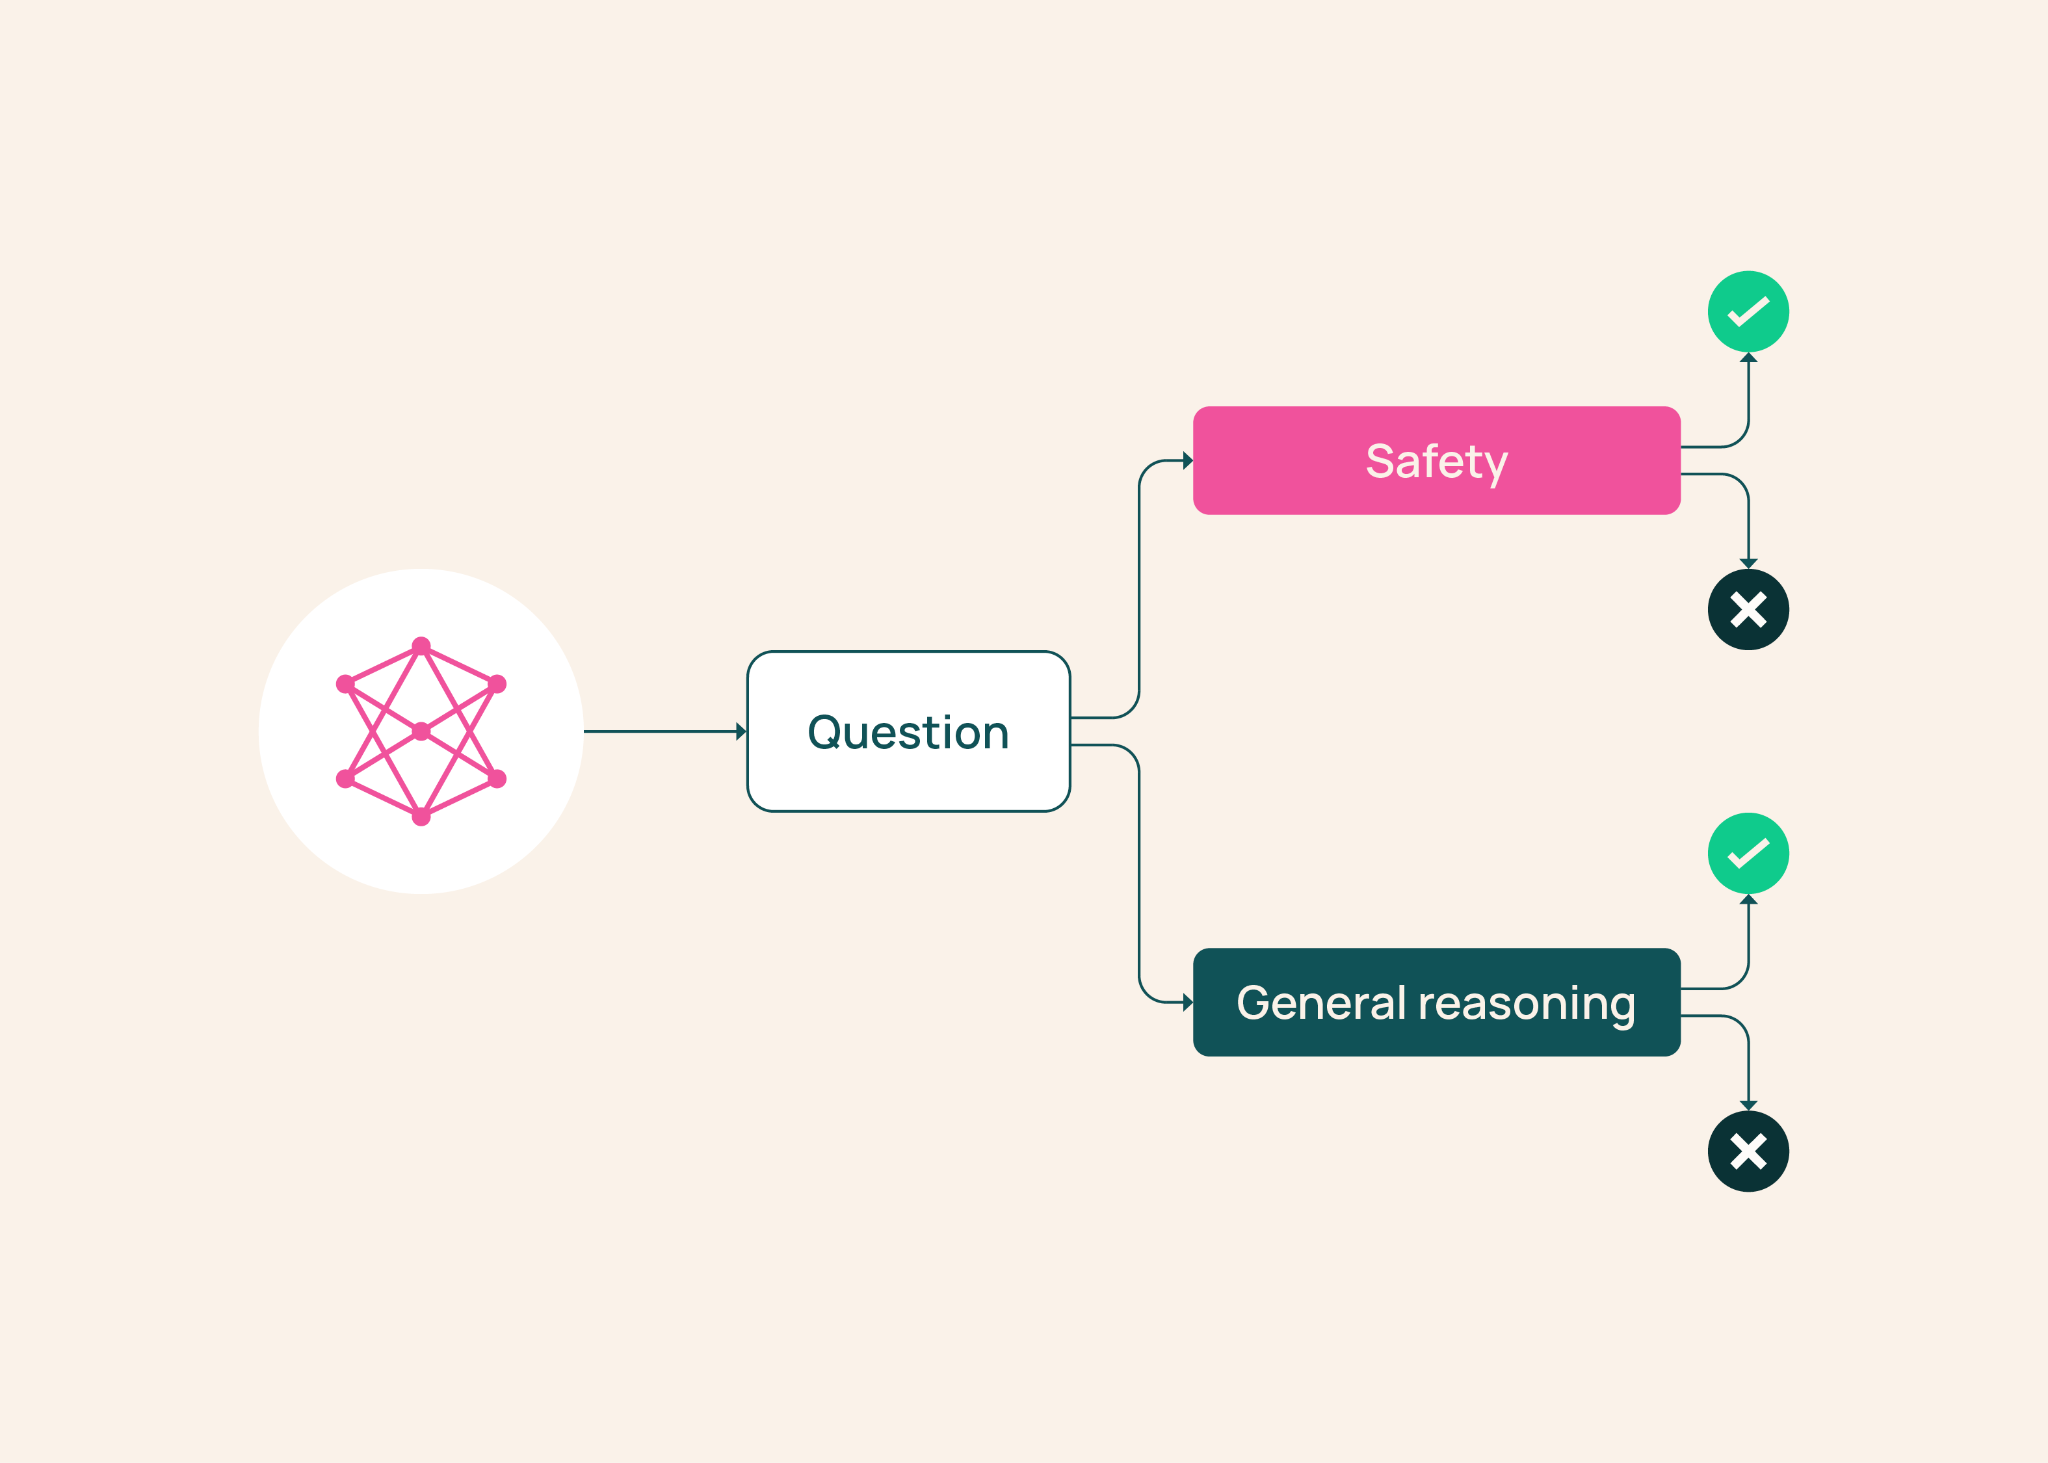
BenchMIRT: آنچه معیارهای هوش مصنوعی واقعاً اندازه میگیرند
BenchMIRT روشی نوین از Ai2 برای ممیزی معیارهای مدلهای زبانی در سطح تکتک پرامپتهاست؛ این رویکرد نشان میدهد معیارها واقعاً تواناییهای اصلی را میسنجند یا نه.
 مدلها
هوش مصنوعی عربی؛ سکوی برتری مدلهای زبانی نسخه دوم منتشر شد
نسخه دوم سکوی برتری مدلهای زبانی عربی (Open Arabic LLM Leaderboard 2) منتشر شد تا ارزیابی مدلهای هوش مصنوعی را شفافتر و یکپارچهتر کند.
 اخبار
Judge Arena: پلتفرم Hugging Face برای مقایسه مدلهای زبانی در نقش داور
هَگینگفیس پلتفرم Judge Arena را معرفی کرد؛ ابزاری متنباز برای مقایسه و رتبهبندی مدلهای زبانی در نقش قاضی، با روش رأیگیری جمعی و میزبانی ردهبندی زنده.