
 مدلها
رفع تعصب ارزیابی در Amazon Bedrock، گامی نو برای هوش مصنوعی
Amazon Web Services با پیادهسازی اصلاح تعصب در ارزیابی مدلها، پلتفرم Amazon Bedrock را برای توسعهدهندگان هوش مصنوعی قدرتمندتر میسازد. این اقدام باعث ارتقای کیفیت مدلهای عمومی و سفارشی میشود.
 اخبار
تقویت امنیت محیط آموزش هوش مصنوعی مرزی در سیستمهای پیشرفته
شرکت اوپنآیآی پروتکلهای امنیتی کاملتری برای آموزش و ارزیابی مدلهای هوش مصنوعی مرزی معرفی کرد تا ریسکهای بالقوه در زیرساختهای سرورهای کلان مدیریت و کاهش یابد.
 پژوهش
حوادث امنیتی هوش مصنوعی؛ همکاری OpenAI و Hugging Face برای ارزیابی مدلها
همکاری OpenAI و Hugging Face برای بررسی حادثه امنیتی در ارزیابی مدلهای هوش مصنوعی و ارائه درسهای کلیدی به مدافعان سایبری.
 پژوهش
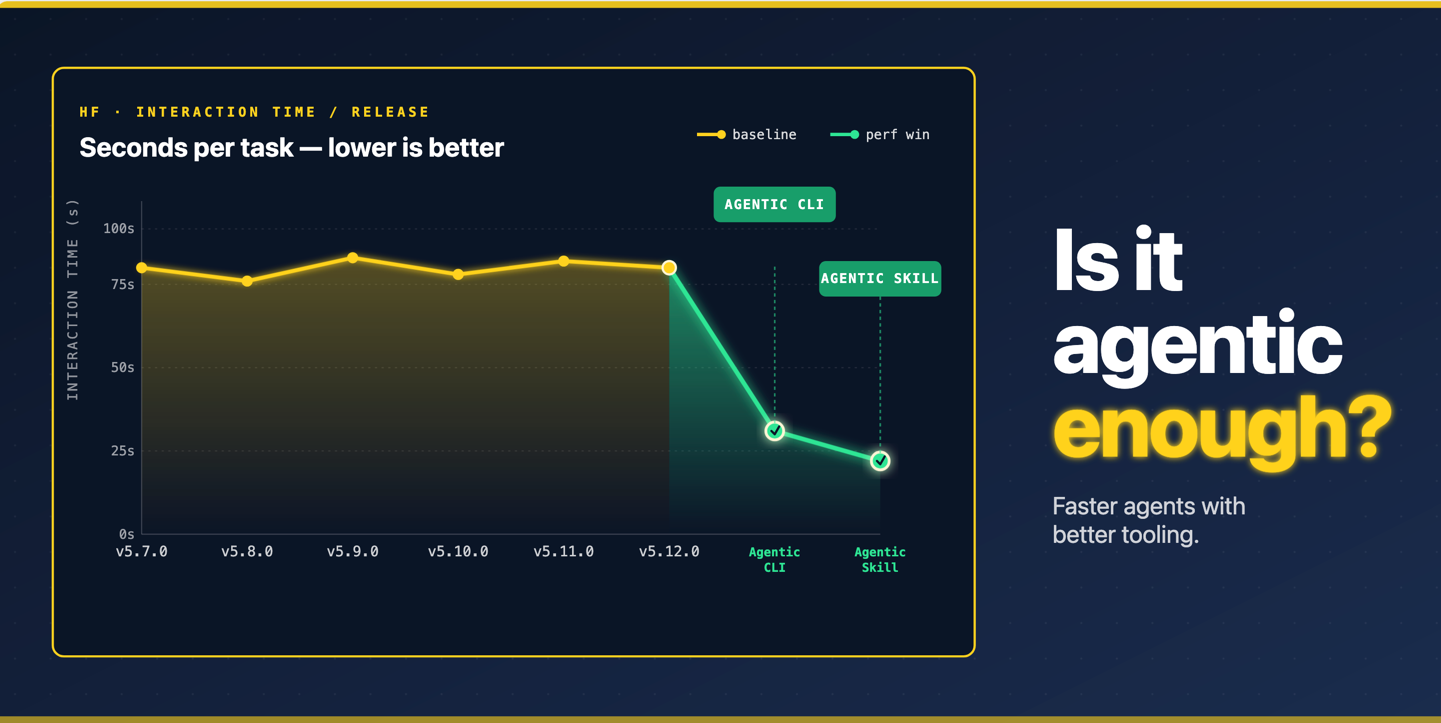
آیا مدل هوش مصنوعی شما عاملگراست؟ روش نوین ارزیابی Hugging Face
Hugging Face روش جدیدی برای ارزیابی مدلهای متنباز در کاربردهای عاملگرا معرفی کرده است؛ معیاری فراتر از پاسخ نهایی که کل فرآیند را میسنجد.
 پژوهش
هوش مصنوعی در عربی: روند نوین ارزیابی کیفیت مدلهای LLM – راهنمای QIMMA
معرفی QIMMA، لواردبورد پیشرفتهٔ عربی با پردازش کیفیت بیخطا، موجب دستکاری دقیقتر نتایج ارزیابی مدلهای زبانی عربی میشود.
 پژوهش
هوش مصنوعی: ارزیابیهای جامعه باعث تغییر لیستهای بیتی میشود
با معرفی Community Evals، Hugging Face به دنبال ایجاد شفافیت در ارزیابی مدلهای هوش مصنوعی است. لیستهای بیشالصداقه دور میشوند و نتایج با اعتبار معتبر میکنند.
 پژوهش
OpenAI: چگونه آزمایش طرف ثالث اکوسیستم ایمنی هوش مصنوعی را تقویت میکند
OpenAI با همکاری کارشناسان مستقل، آزمایشهای دورهای روی هوش مصنوعی را برای افزایش ایمنی، اعتبار و شفافیت در ارزیابی مدلها اجرا میکند؛ این کار اعتماد عمومی را تقویت میکند.
 پژوهش
هوش مصنوعی و ارزیابی کد: BigCodeArena با اجرای واقعی کدها نقش هیجانانگیز
پلتفرم BigCodeArena با اجرای کد برای ارزیابی مدلهای تولید کد، استاندارد جدیدی برای تحلیل عملکرد کدهای تولیدی توسط هوش مصنوعی معرفی میکند.
 پژوهش
هوش مصنوعی و GDPval: ارزیابی مدلهای OpenAI در ۴۴ شغل اقتصادی واقعی
OpenAI با معرفی GDPval، فریمورک ارزیابی مدلهای هوش مصنوعی را بر مبنای عملکرد در کارهای اقتصادی واقعی و ارزشافزوده به ۴۴ شغل مختلف ارائه کرد.
 پژوهش
هوش مصنوعی بدون خطر: راهنمای RiskRubric.ai برای ارزیابی استاندارد مدلها
RiskRubric.ai، استانداردی نوین برای ارزیابی ریسک مدلهای هوش مصنوعی، امنیت، حریم خصوصی و پایداری را در ارزیابی مدلها به یکپارچگی میآورد.