
 پژوهش
هوش مصنوعی: رازهای ساخت ربات گفتگوی کارآمد و کارا در عصر دیجیتال
این مقاله به بررسی تکنیکهای کلیدی ربات گفتگوی هوش مصنوعی میپردازد؛ مثل RLHF، IFT، CoT و Red team. راهکارهای باز و متن‑باز برای بهتر کردن آنها در عصر دیجیتال را بررسی میکنیم.
 پژوهش
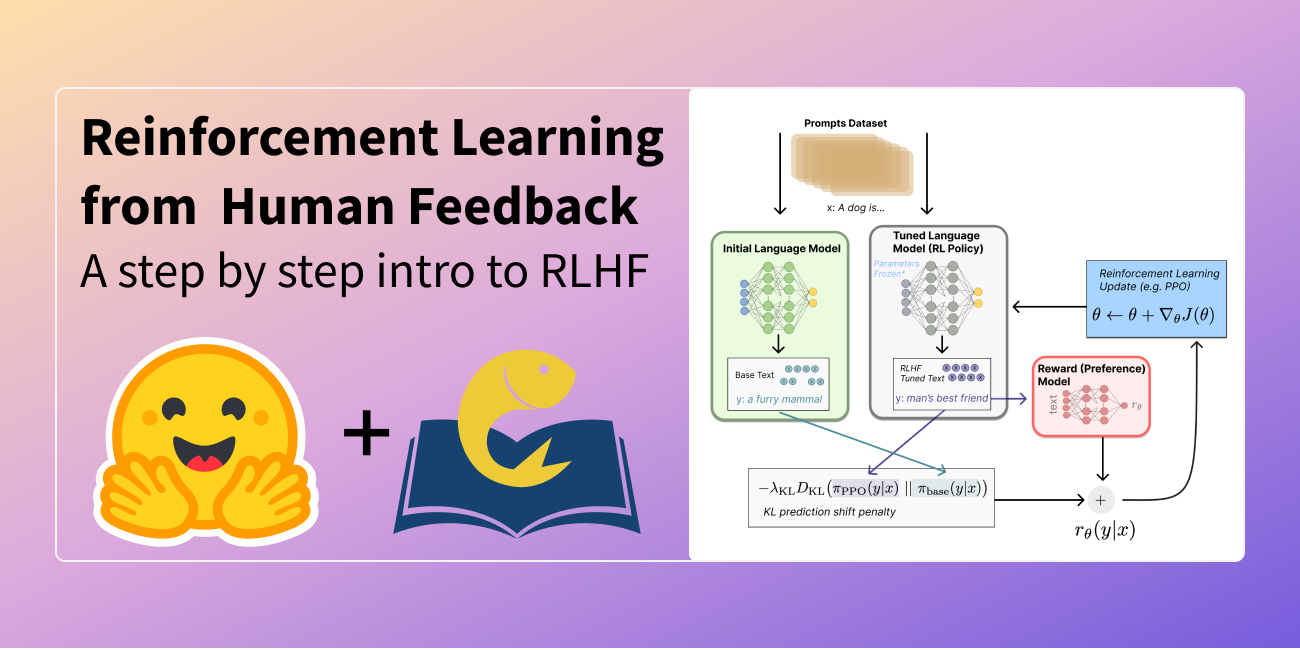
هوش مصنوعی با یادگیری تقویتی از بازخورد انسانی: رویکرد جدید شکافزن
مقالهای در شبکه هوش مصنوعی ارائه میدهد که چگونگی ترکیب یادگیری تقویتی با بازخورد انسانی برای بهبود مدلهای زبانی و افزایش شفافیت را نشان میدهد.
 پژوهش
هوش مصنوعی: محدودیت های شناسایی بیش از حد مدل پاداش در آموزش RLHF
قانون مقیاس در هوش مصنوعی نشان میدهد که بیشینهسازی مدلهای پاداش میتواند کارایی را کاهش دهد. این مقاله به بررسی چالشها و راهکارهای کاهش این ناهماهنگی میپردازد.
 مدلها
مقدمه عملی: آموزش مبتنی بر Transformer برای تصمیمگیری در هوش مصنوعی
در این مطلب بهصورت گام به گام با نحوهٔ آموزش اولین مدل Decision Transformer در محیط گوگل کولاب آشنا میشویم و چگونگی استفاده از آن در مسائل تصمیمگیری را بررسی میکنیم.
 پژوهش
هوش مصنوعی: راهنمای عملی Proximal Policy Optimization (PPO) در یادگیری تقویتی
دستورات کامل Proximal Policy Optimization (PPO) را معرفی میکنیم، مزایای آن در یادگیری تقویتی، و نحوه پیادهسازی توسط Hugging Face و منابع متنباز.
 پژوهش
هوش مصنوعی در عمل: Advantage Actor Critic (A2C) و کاربردهایش
مزیت A2C در هوش مصنوعی: یادگیری تقویتی با کاهش واریانس، بهبود عملکرد رباتیک در PyBullet، آموزش عملی، بهینهسازی مدل و کاهش هزینه اجرا و بازدهی بیشتر.
 پژوهش
هوش مصنوعی: معرفی گسترده و رایگان یادگیری تقویت عمیق در هسته و فریمورکهای متنباز
مقالهٔ هاجینگ فیس مروری جامع بر یادگیری تقویت عمیق است؛ مفاهیم پایه، چارچوب RL، سیاستها و ارزشها، و دورهٔ رایگان این حوزه را درآورده؛ راهنمایی برای همهگیران
 پژوهش
هوش مصنوعی در قهرمانان: معرفی Decision Transformers در Hugging Face
Hugging Face با ادغام Decision Transformer، اولین مدل یادگیری تقویتی آفلاین در کتابخانه Transformers را معرفی کرده و امکانات پژوهشی بیشتری را به دسترس همه ارائه میدهد.
 پژوهش
رقابتهای Procgen و MineRL در NeurIPS 2020؛ گامی برای هوش مصنوعی
OpenAI با همکاری AIcrowd، دانشگاه کارنگی ملون و DeepMind دو رقابت NeurIPS 2020 را با معیارهای Procgen و MineRL برگزار میکند.
 آموزش
منبع آموزشی جدید OpenAI برای یادگیری عمیق در حوزه هوش مصنوعی
OpenAI منبع رایگان Spinning Up in Deep RL را منتشر کرد؛ با مثالهای کدنویسی، تمرینها و مستندات آموزشی، یادگیری تقویتی عمیق را برای همه ممکن میسازد.