
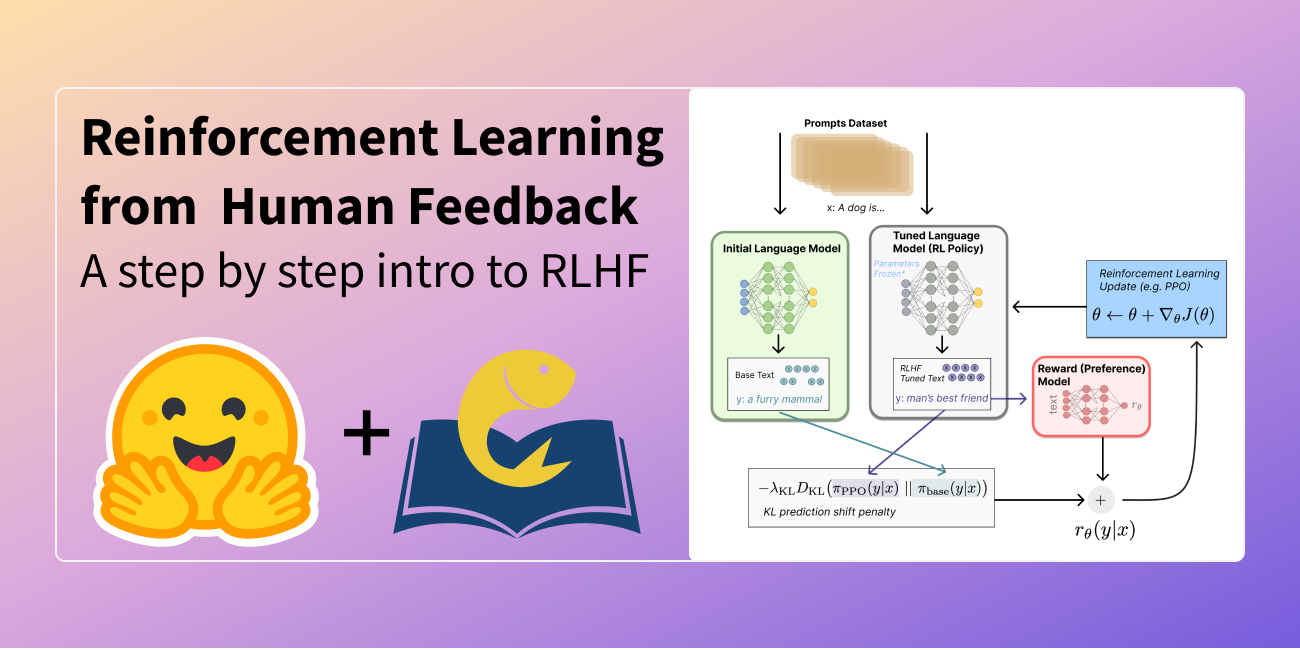
آشنایی با یادگیری تقویتی از بازخورد انسانی (RLHF)
در دهه گذشته، مدلهای زبانی قدرتمندی مانند GPT-4 بهطور چشمگیری پیشرفت کردهاند. اما ارزیابی کیفیت چنین متنهایی، همیشه یک چالش بوده است؛ کیفیت متن بهصورت ناپیوسته و وابسته به زمینهٔ کاربرد تعریف میشود. در این میان، یادگیری تقویتی از بازخورد انسانی (RLHF) بهعنوان یک پیادهسازی قابل توجه در این حوزه مطرح میشود.
- تعریف واضحی از «کسبوکار نمرهگذاری» برای کاربران انسانی
- پیشرفت در شناسایی و حفظ حقایق و دستاوردهای علمی در متن خروجی
- توزیع بازخورد مناسب برای هر استعمال و کاربردی
چالشهای امروزی در مدلهای زبانی و دورانی که RLHF وارد میشود
مدلهای زبانی معمولاً با استفاده از تابع هزینهٔ سادهای مثل خسارت کراس-انتروپی آموزش میبگیرند؛ این تابع قادر به طبقهبندی دقیق رفتار انسانی نیست. RLHF بهوسیلهٔ ساختن «مقایسهٔ مستقیم» (direct comparison) و شاخهسازی مدل بر اساس بازخورد واقعی، این محدودیت را برطرف میکند. این روش نهتنها بر تولید متنهای درستتر، بلکه بر موازین اخلاقی و بدیهی کاربران نیز تأثیر میگذارد.
راهکارهای عملی و ابزارهای متنباز برای پیادهسازی RLHF
Hugging Face در خود مجموعهٔ خود، مجموعهای از کتابخانهها و ابزارهای متنباز برای پیادهسازی RLHF را منتشر کرده است که شامل نمونهٔ کد، اسناد، و مدلهای آماده میشود. کاربران میتوانند بهسادگی یک مدل کامپایل کرده، بازخورد انسانی را بهصورت ردیاری اضافه کرده و مدل را بازآموزی کنند. همچنین یک بستهٔ GRC معتمد برای پایداریسازی و نمایشیابی برای تست آن وجود دارد.
در مجموع، RLHF ما را قادر میسازد تا مدلهای زبانی را با دقت و تطبیق با ترجیحات انسانی مصمم کنیم، که همانند تحول قابل توجهی است که در زمینهٔ هوش مصنوعی بهدنبال آن میباشیم.
پرسشهای پرتکرار
RLHF به چه صورت در مدلهای زبانی به کار گرفته میشود؟
RLHF با استفاده از بازخورد انسانی بهعنوان یک تابع پاداش در فرآیند یادگیری تقویتی عمل میکند؛ یعنی مدل نهایی بر اساس امتیازهای انسانی تنظیم و بهبود مییابد.
مزایای استفاده از RLHF در مقایسه با روشهای سنتی چیست؟
فضاهای مدلسازی RLHF بهصورت مستقیم بر کیفیت خروجی تأثیر میگذارد؛ بهدلیل داشتن شیوهٔ ارزشیابی انسانی، مدل خروجی در زمینههای واقعی (مقاله، کد، گفتار) بهتر عمل میکند.


