
 پژوهش
Granite 4.1: هوش مصنوعی IBM امکان پردازش 512k توکن در بلاکهای بزرگ
شرکت IBM با معرفی خانواده مدلهای بزرگ LLM ۴.۱ Granite، پردازش متن را با ۱۵ تریلیون توکن و امکان پردازش متون ۵۱۲ هزاریه و برای استفاده ابری افزایش میدهد.
 کسبوکار
OpenAI مدلهای هوش مصنوعی و Codex را به AWS میآورد: امنیت گسترده
OpenAI با ارائه مدلهای GPT، Codex و Managed Agents بر روی پلتفرم AWS، امکان ساخت راهحلهای هوش مصنوعی امن و مقیاسپذیر را برای سازمانها فراهم میکند.
 سختافزار
چگونه از Transformers.js در افزونه کروم برای هوش مصنوعی جدید استفاده کنیم
راهنمای گامبهگام برای استفاده از Transformers.js در افزونه کروم: چگونه مدلهای هوش مصنوعی را محلی بارگذاری کنید، کش را مدیریت کرده و با سرویسورک ارتباط برقرار کنید.
 پژوهش
هوش مصنوعی در عربی: روند نوین ارزیابی کیفیت مدلهای LLM – راهنمای QIMMA
معرفی QIMMA، لواردبورد پیشرفتهٔ عربی با پردازش کیفیت بیخطا، موجب دستکاری دقیقتر نتایج ارزیابی مدلهای زبانی عربی میشود.
 پژوهش
هوش مصنوعی: تهدید مخفی برای دموکراسی در لحظهٔ انتخابها
پیشرفت مدلهای زبان بزرگ و سیستمهای چندگانه، جوامع آنلاین را بهصورت مخفیانه سرنگون میکند؛ پژوهشگران هشدار میدهند حرکت جدیتر در انتخابات آینده نامحدود میشود.
 مدلها
MLX & Transformers: چگونه مدلهای زبان را به سرعت به MLX منتقل کنیم
در این مقاله به بررسی راهنمایی برای انتقال مدلهای زبان Transformers به سیستم MLX میپردازیم؛ از ابزار Skill تا تستهای مورد نیاز و نکات کلیدی
 محصولات
TRL v1.0 منتشر شد: تحولی در آموزش پسین مدلهای هوش مصنوعی
TRL v1.0 با پشتیبانی از بیش از ۷۵ روش آموزش پسین، به ابزاری پایدار برای تولید تبدیل شده است و طراحی آن برای حرکت با نیازهای میدان تکامل مییابد.
 اخبار
اُپنایآی سیاستهای ایمنی نوجوانان را برای توسعهدهندگان gpt-oss-safeguard منتشر کرد
اُپنایآی سیاستهای ایمنی نوجوانان مبتنی بر پرامپت را برای توسعهدهندگان هوش مصنوعی با gpt-oss-safeguard عرضه کرد تا ریسکهای سنی در مدلهای زبانی کاهش یابد.
 پژوهش
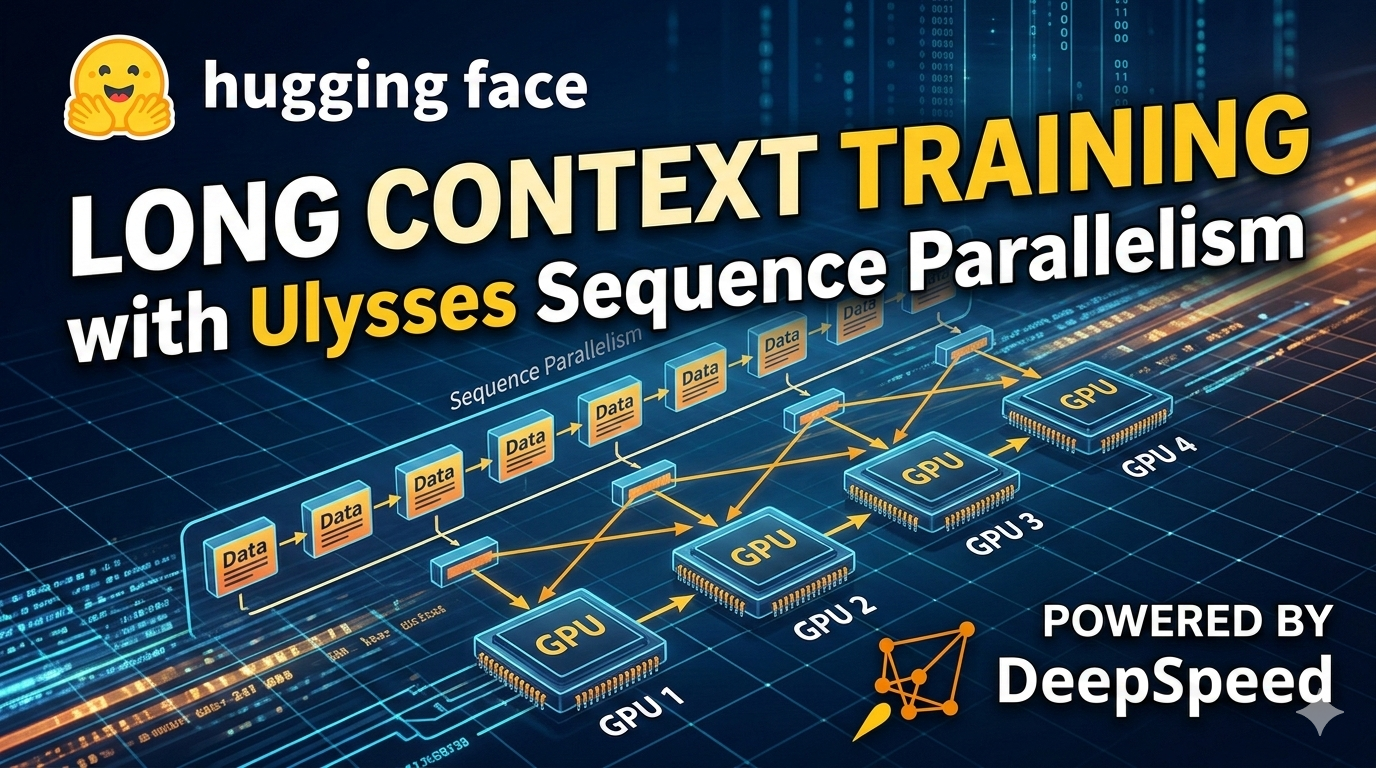
هوش مصنوعی با Ulysses: پردازش میلیونها توکن در یک مدل
Ulysses با استفاده از موازیسازی توالی، امکان آموزش مدلهای زبان با هزاران میلیون توکن را فراهم میکند و جایگزینی مناسب برای Ring Attention است.
 پژوهش
هوش مصنوعی در ترنسفورمرها: MoE (Mixture of Experts) و انقلاب در مدلها
مروری بر هندسه «Mixture of Experts» در ترنسفورمرها، چگونگی افزایش مقیاسپذیری مدلهای زبانی و نقش آن در آیندهی هوش مصنوعی. این مقاله به بررسی معماری MoE، بارگذاری وزن، و نتایج اجرای آن میپردازد.