
 مدلها
هوش مصنوعی OpenAI o3-mini: پیشرویی خفیف در قدرت پردازش مدلهای زبانی
OpenAI با معرفی مدل o3-mini، گامی کوچک اما چشمگیر در جهت ساخت مدلهای زبانی با کارایی بالا و مصرف کم برداشته است. این مقاله به بررسی ویژگیها و کاربردهای آن میپردازد.
 مدلها
جهش جدید هاگینگ فیس: مدلهای امبدینگ استاتیک ۴۰۰ برابر سریعتر با هوش مصنوعی
هاگینگ فیس با معرفی روشی نوین، مدلهای امبدینگ استاتیک را تا ۴۰۰ برابر سریعتر روی CPU آموزش داده است. این پیشرفت انقلابی، کاربردهای هوش مصنوعی را روی دستگاههای کمتوان گسترش میدهد.
 پژوهش
ردپای کربن هوش مصنوعی: تحلیل انتشار CO2 مدلهای زبان بزرگ
گزارش هاگینگ فیس از لیدربورد Open LLM، نگاهی عمیق به انتشار CO2 مدلهای زبان بزرگ در فرآیند استنتاج ارائه میدهد. آگاهی از تأثیر زیستمحیطی هوش مصنوعی رو به افزایش است.
 پژوهش
هوش مصنوعی در تولید متن سریعتر: Self‑Speculative Decoding
بهبود سریعسازی تولید متن با استفاده از Self‑Speculative Decoding، که ترکیبی از تحلیل زودهنگام و بازنگری در لایههای LLM است، میتواند سرعت و مصرف حافظه را به طور چشمگیری کاهش دهد.
 کسبوکار
هوش مصنوعی در دنیای زیبایی: چگونه Estée Lauder با ChatGPT Enterprise نوآوری را تسریع میکند
نقش هوش مصنوعی در Estée Lauder: با بهرهگیری از ChatGPT Enterprise، تحلیل دقیق دادههای مصرفکننده، شناسایی روندها و تسریع نوآوری در محصولات زیبایی را تجربه کنید.
 پژوهش
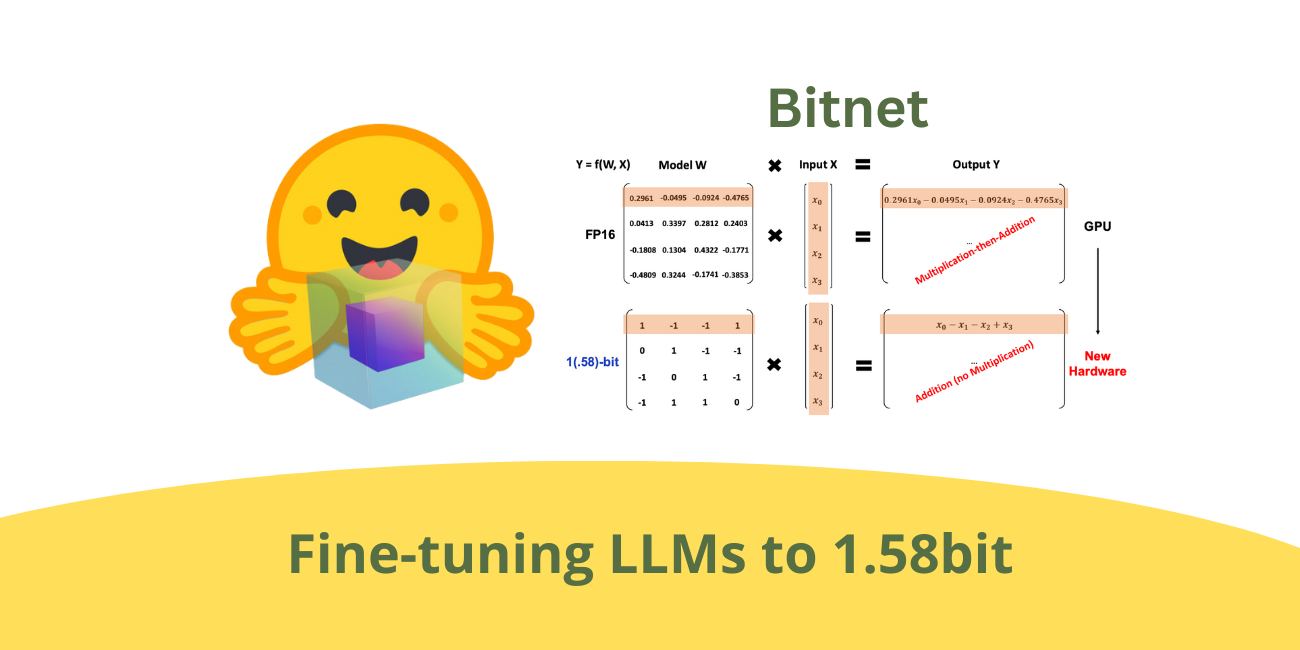
کوانتیزیشن افراطی هوش مصنوعی: بهینهسازی مدلهای زبانی به ۱.۵۸ بیت
تیم Hugging Face با ارائه فاینتیونینگ مدلهای زبانی در ۱.۵۸ بیت، روشی جدید برای کاهش شدید مصرف منابع و افزایش کارایی هوش مصنوعی در مقیاس گسترده معرفی کرد.
 پژوهش
بهینهسازی دیتاستهای روباتیک با رمزگذاری ویدئو: هوش مصنوعی بدون پیچیدگی
مدیریت دیتاست روباتیک با رمزگذاری ویدئو، هزینه ذخیرهسازی را تا 95٪ کاهش میدهد و سرعت پردازش را ارتقا میبخشد؛ این نوآوری در پژوهشهای هوش مصنوعی راهنمایی استاندارد میشود.
 مدلها
کوانتایز دیفیوژن ترنسفورمر با Quanto: کاهش مصرف حافظه در هوش مصنوعی
با معرفی ابزارهای Quanto و Diffusers، اجرا کردن مدلهای سنگین تولید تصویر با هوش مصنوعی بر روی سختافزارهای محدودتر بدون افت عملکرد محسوس اکنون امکانپذیر است.
 اخبار
پشتیبانی سریعتر Assisted Generation بر روی Intel Gaudi در هوش مصنوعی
شرکت Intel و هابانا پردازنده Gaudi را برای سرعتپردازی Assisted Generation طراحی کرده و هزینه و مصرف انرژی را بهطور چشمگیری کاهش میدهد.
 مدلها
هوش مصنوعی: کشف حافظه کوانتیزه برای تولید متن طولانی در مدلهای بزرگ
کاهش مصرف حافظه در تولید متن طولانی با کوانتیزه کردن KV Cache، راهحلی قابل تنظیم برای مدلهای بزرگ – معیارهای عملکرد و کیفیت بدون کاهش قابل توجهی در خروجی.