
 پژوهش
هوش مصنوعی GPT‑5: کارت سیستم جدید برای مدیریت گفتگوهای حساس
کارت سیستم GPT‑5 بهروزرسانیهای مهمی در مدیریت گفتگوهای حساس ارائه میکند، از جمله معیارهای جدید ارزیابی وابستگی عاطفی، سلامت روانی و مقاومت در برابر jailbreak.
 پژوهش
بدست آوردن بیطرفی سیاسی در مدلهای هوش مصنوعی روشهای جدید آزمایش OpenAI
OpenAI با معرفی روشهای جدید آزمایشی، به ارزیابی تعصب سیاسی در مدلهای زبانی بزرگ نزدیکتر میشود؛ هدف بهبود بیطرفی و کارایی.
 پژوهش
هوش مصنوعی و ارزیابی کد: BigCodeArena با اجرای واقعی کدها نقش هیجانانگیز
پلتفرم BigCodeArena با اجرای کد برای ارزیابی مدلهای تولید کد، استاندارد جدیدی برای تحلیل عملکرد کدهای تولیدی توسط هوش مصنوعی معرفی میکند.
 پژوهش
معرفی RTEB: استاندارد نوین ارزیابی بازیابی در هوش مصنوعی
RTEB، بنچمارک جدیدی برای ارزیابی دقیق واکشی بردارهای جاسازی، با استفاده از ترکیبی از دادههای عمومی و خصوصی، راهحلی شفاف و مشخص برای سنجش عملکرد مدلهای هوش مصنوعی در شرایط واقعی ارائه میدهد.
 پژوهش
هوش مصنوعی و GDPval: ارزیابی مدلهای OpenAI در ۴۴ شغل اقتصادی واقعی
OpenAI با معرفی GDPval، فریمورک ارزیابی مدلهای هوش مصنوعی را بر مبنای عملکرد در کارهای اقتصادی واقعی و ارزشافزوده به ۴۴ شغل مختلف ارائه کرد.
 پژوهش
Gaia2 و ARE: ابزار هوش مصنوعی برای ارزیابی و استفاده از عاملهای هوشمند
در سال ۲۰۲۵، هاجیفیس با پروژ Gaia2 و ARE چارچوب باز برای ارزیابی عاملهای هوش مصنوعی در وظایف واقعی معرفی کرد و بزرگی در تعامل انسان–هوش مصنوعی برداشت.
 پژوهش
هوش مصنوعی بدون خطر: راهنمای RiskRubric.ai برای ارزیابی استاندارد مدلها
RiskRubric.ai، استانداردی نوین برای ارزیابی ریسک مدلهای هوش مصنوعی، امنیت، حریم خصوصی و پایداری را در ارزیابی مدلها به یکپارچگی میآورد.
 پژوهش
هوش مصنوعی: چرا مدلهای زبانی گمراه میشوند و راهحلها
بررسی جدید OpenAI دربارهٔ علت هلیوکولیشن در مدلهای زبانی؛ نکات کلیدی برای ارتقاء اطمینان، صداقت و ایمنی هوش مصنوعی فاش میکند.
 اخبار
همکاری بین OpenAI و Anthropic در ارزیابی امنیت هوش مصنوعی
OpenAI و Anthropic همکاری کردند تا با ارزیابی مشترک مدلهای هوش مصنوعی، از جمله مسائل همترازگی، دستورات، ایوازش، و نفوذ، پیشرفتها و چالشهای جدید را کشف کنند.
 پژوهش
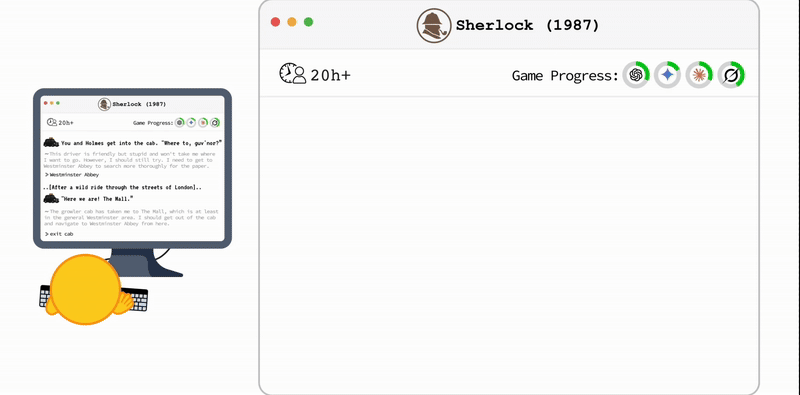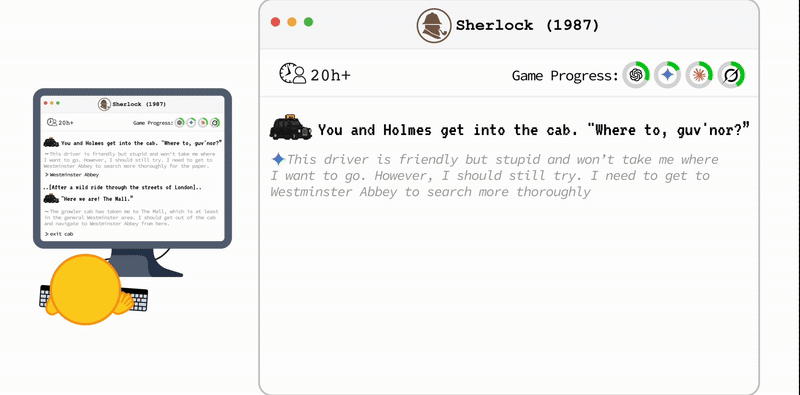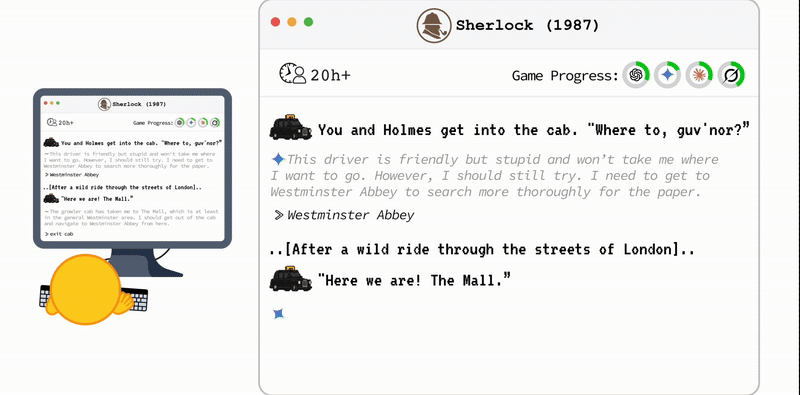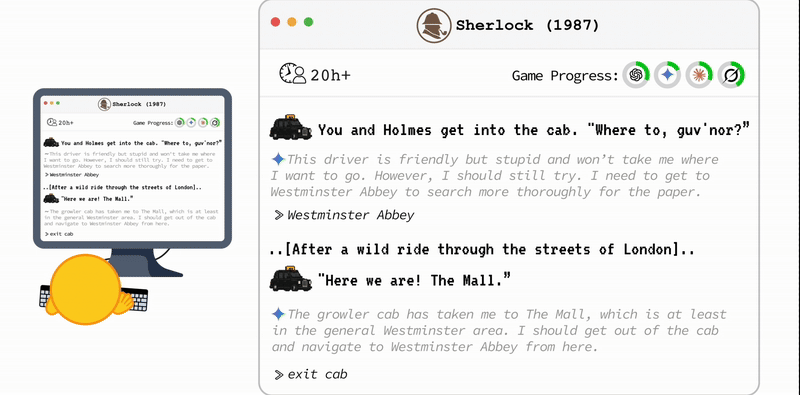
هوش مصنوعی در بازیهای ویدئویی متنی: عملکرد LLMs و چالشها
این مقاله به بررسی توانایی مدلهای زبان بزرگ در بازیهای متنی میپردازد، روشهای ارزیابی، چالشهای فنی و راهکارهای بهبود را بررسی میکند.