
 محصولات
روشن کردن سریع اپلیکیشنهای هوش مصنوعی با حالت ریلود گریادو
با رِیلود گرادیو، توسعهدهندگان میتوانند تغییرات کد را بدون ریستارت سرور، به طور لحظهای اعمال کنند؛ سرعت توسعه اپلیکیشن هوش مصنوعی را بهطور چشمگیری بالا میبرند.
 اخبار
گوگل کلود و Hugging Face: هزاران مدل زبان باز در Vertex AI نمایان میشوند
گوگل کلود و Hugging Face همکار شد که هزاران مدل زبانی باز را در Vertex AI و GKE عرضه کنند؛ برای توسعهدهندگان تولید اپلیکیشنهای هوش مصنوعی، بدون مدیریت سرور، مناسب است.
 پژوهش
هوش مصنوعی بر روی سرورهای Xeon: SetFit با سرعتشده توسط Intel
SetFit با بهرهگیری از Optimum Intel بر روی پردازندههای Xeon با سرعت بیسابقهای به قضاوتهای چند-خطی دست مییابد؛ مقاله این راهحل و روند بهینهسازی را بررسی میکند.
 اخبار
هوش مصنوعی بدون سرور: Deploy on Cloudflare Workers AI در Hugging Face
Hugging Face با همکاری Cloudflare اعلام کرد سرویس Deploy on Cloudflare Workers AI راهاندازی شد؛ این سرویس امکان اجرای مدلهای هوش مصنوعی بر روی GPUهای سرورلس را بدون نیاز به مدیریت سرور فراهم میکند.
 مدلها
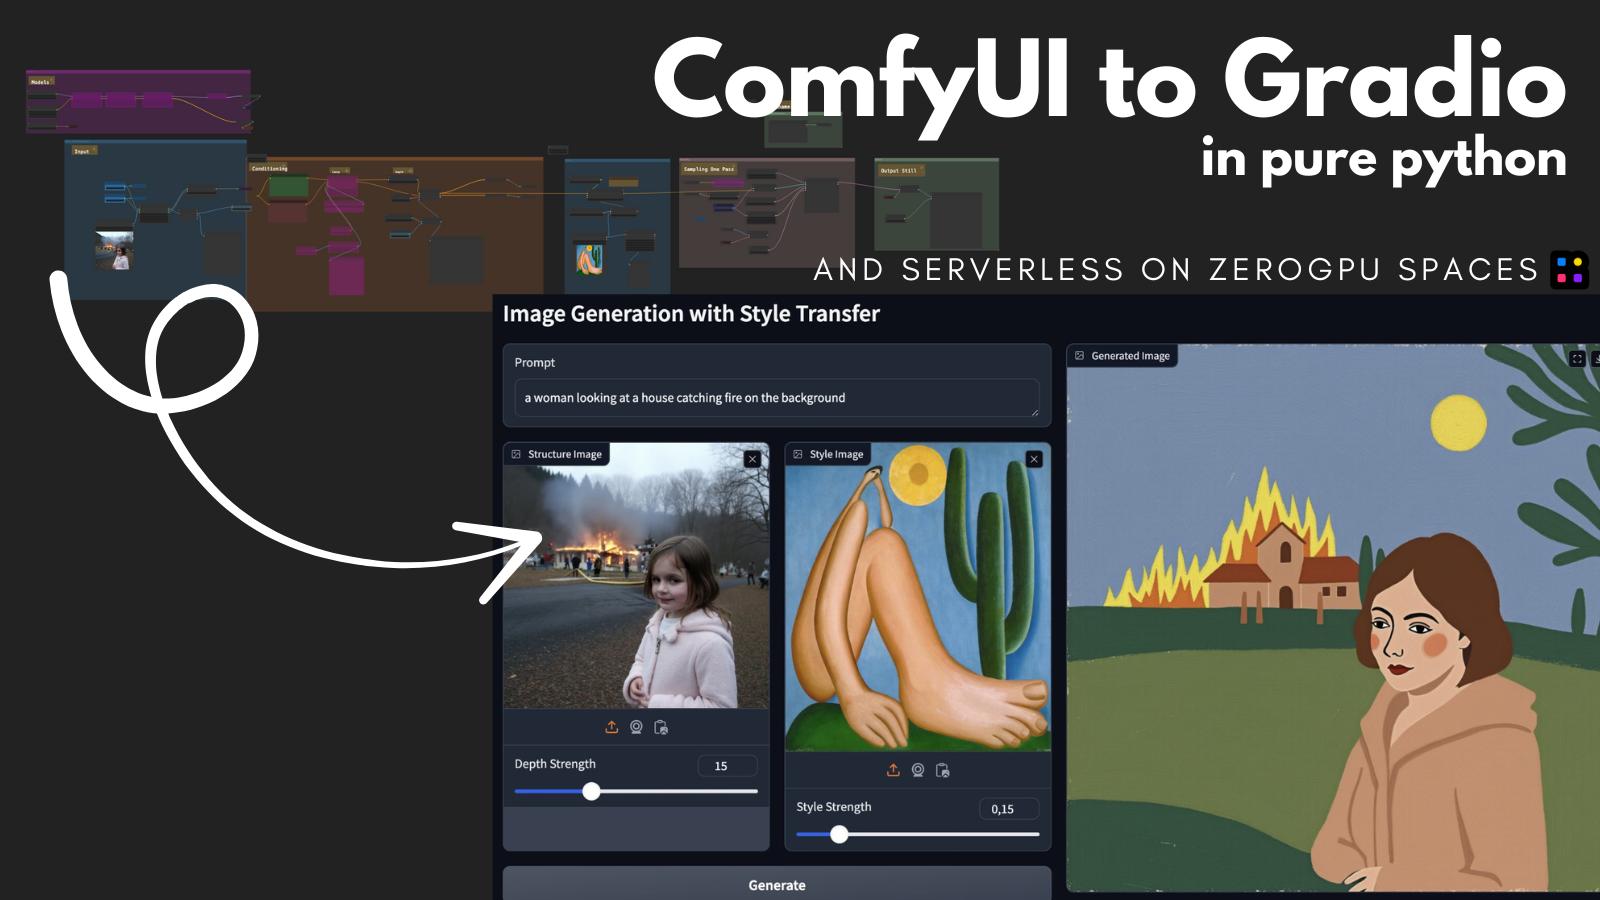
هوش مصنوعی در عمل: تبدیل ورکفلوهای ComfyUI به اپلیکیشن گراودری رایگان
در این مقاله، گامهای ساده تبدیل ورکفلو ComfyUI به گراودری و استقرار آزاد در Hugging Face ZeroGPU را بررسی میکنیم بهصورت ساده و بدون نیاز به سرور.
 سختافزار
هوش مصنوعی: سرعت جاندادانهای برای Llama 2 روی AWS Inferentia2
AWS Inferentia2 با همکاری Hugging Face و optimum‑neuron، Llama 2 را برای تولید متن به سرعتی بیسابقه بر روی سرورها میشکند. در این مقاله نقشه راه و نتایج آزمایشات را بررسی میکنیم.
 محصولات
Gradio Lite: اجرای بدون سرور در مرورگر با هوش مصنوعی—راهحلی سریع برای توسعه مدلها
Gradio Lite با استفاده از Pyodide به شما امکان میدهد نرمافزارهای هوش مصنوعی Gradio را بهصورت کاملاً سرورسور (Serverless) در مرورگر اجرا کنید. این تکنولوژی سرعت، حریمخصوصی و سهولت انتشار را بهبود میبخشد۔
 پژوهش
آژانگهای هوش مصنوعی را با JavaScript در Hugging Face به کار ببرید
نسخه جدید کتابخانه Agents.js را معرفی میکنیم؛ راهی نوین برای کنترل مدلهای زبانی بزرگ با استفاده از JavaScript و دسترسی به ابزارهای متنوع، چه در مرورگر و چه در سرور. مبحثی جذاب برای توسعهدهندگان و پژوهشگران هوش مصنوعی.
 مدلها
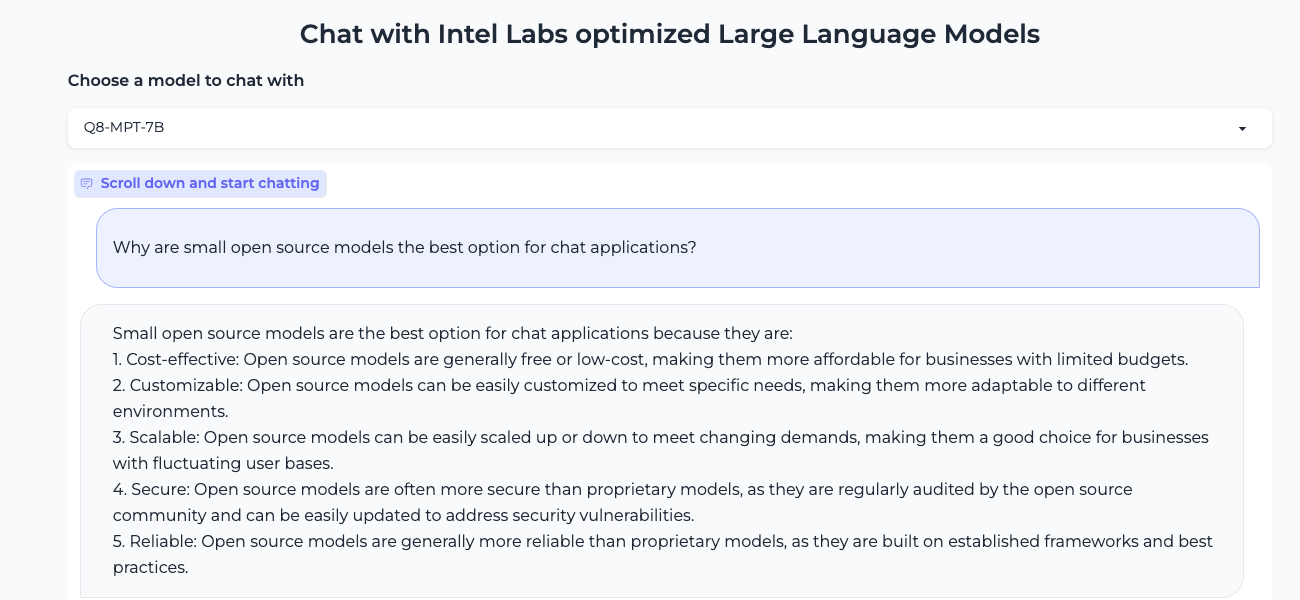
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.
 پژوهش
کاربرد هوش مصنوعی در یادگیری فدرال: راهنمای پیکربندی Hugging Face + Flower
در این مقاله، چگونگی پیادهسازی یادگیری فدرال با Hugging Face و Flower را بررسی میکنیم؛ نصب بسته، راهاندازی سرور، و نتایج بر روی دادههای IMDB.