
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 مدلها
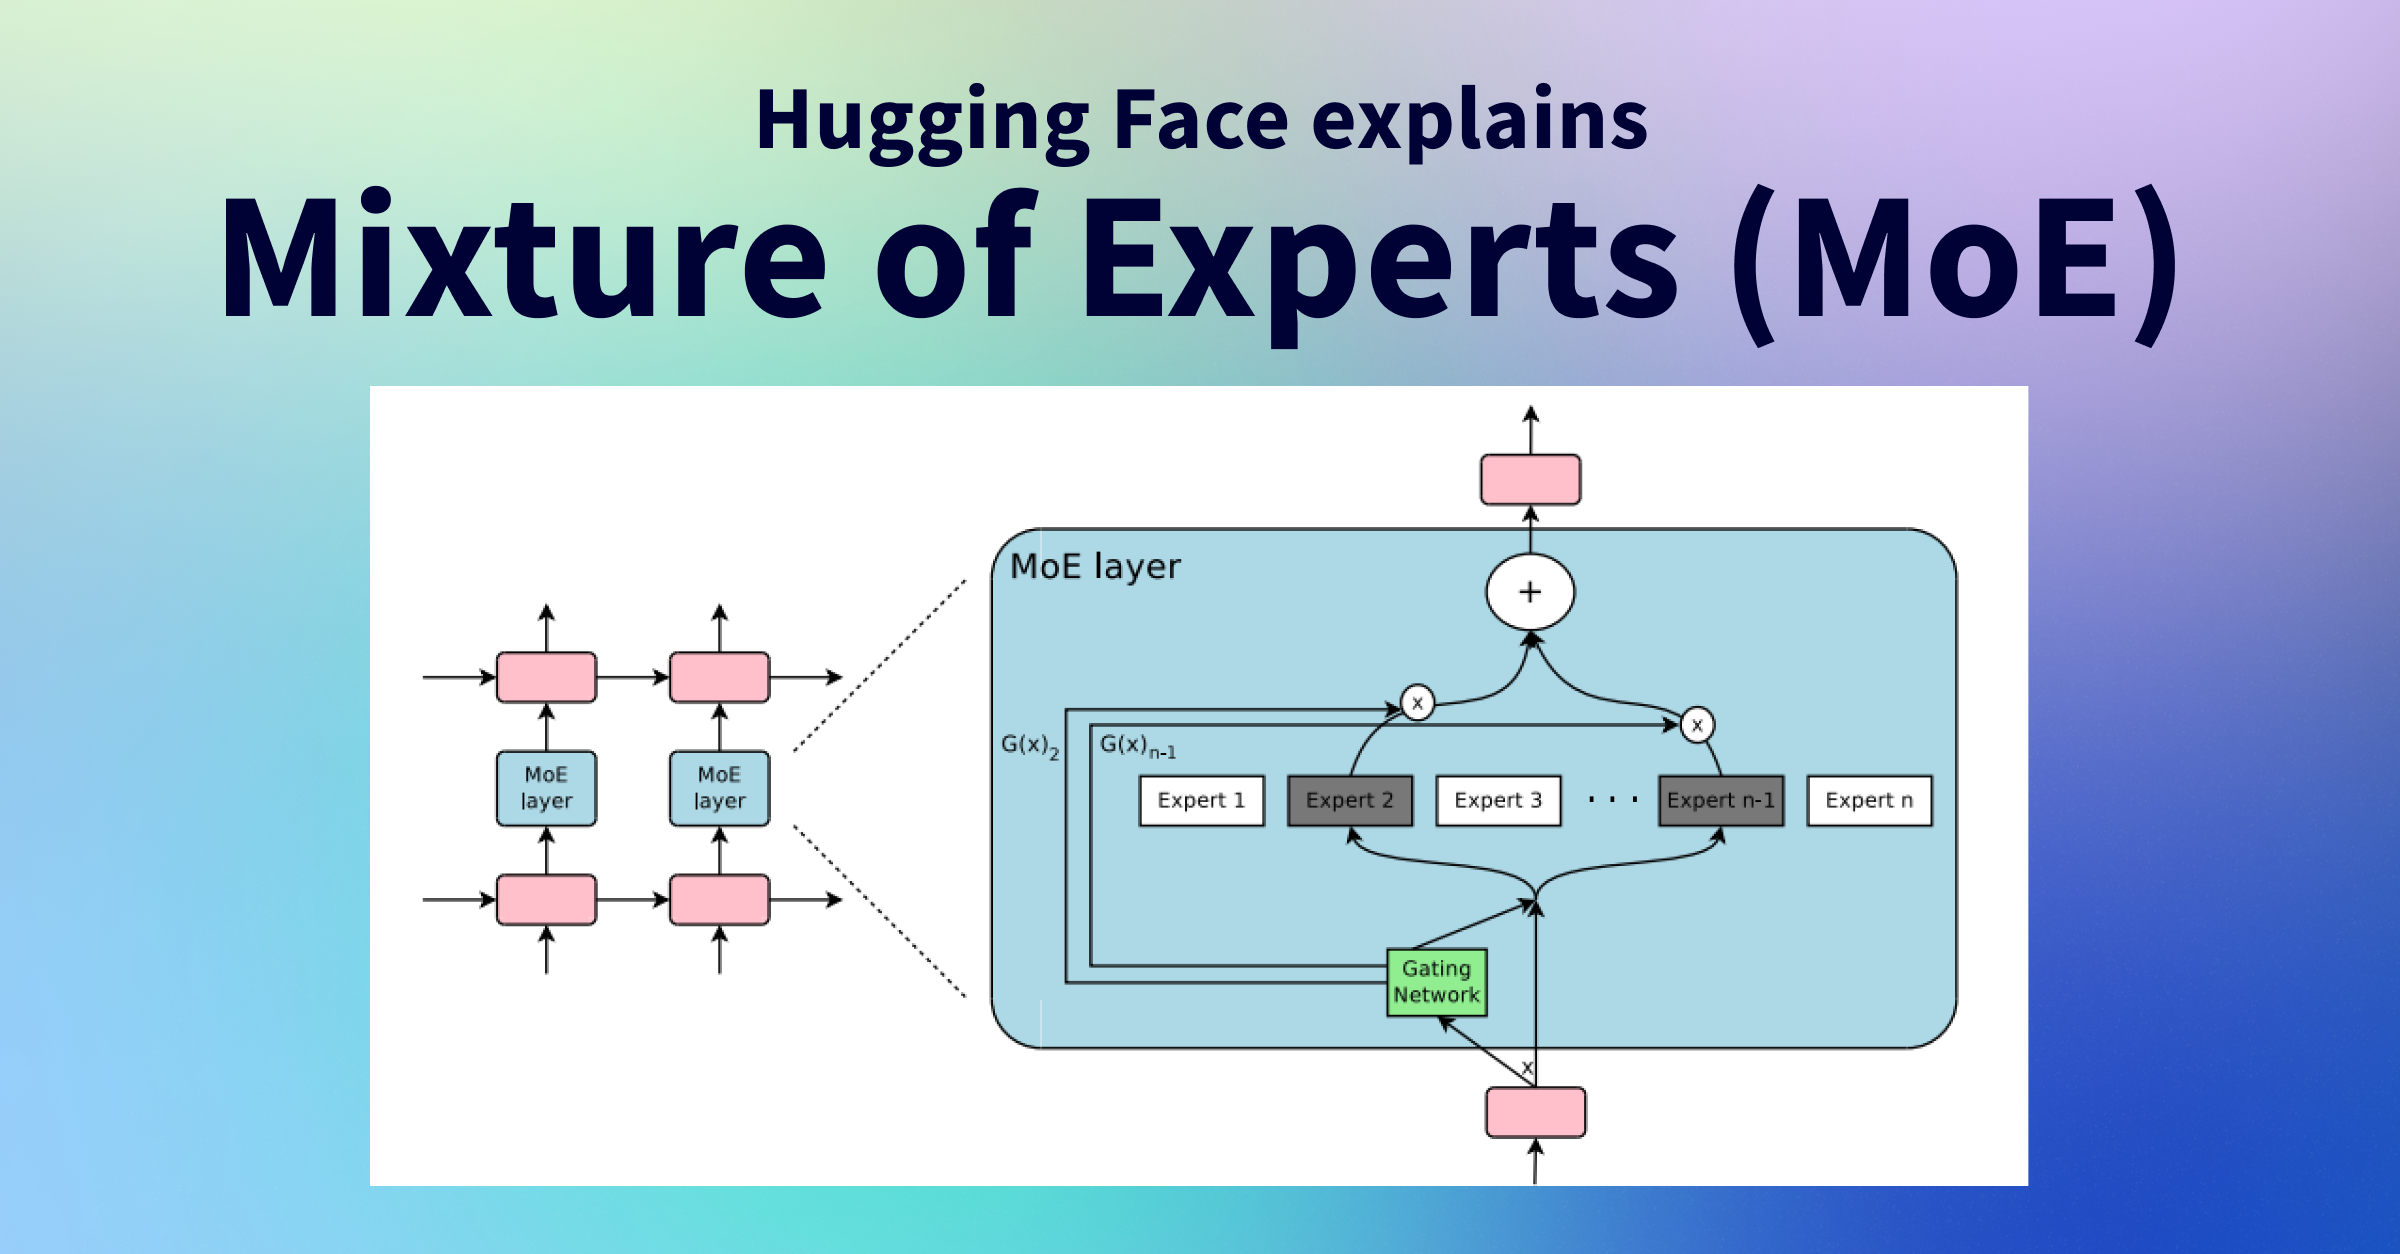
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 مدلها
پیشرفت هوش مصنوعی: تلاش برای بهینهسازی ساده SDXL جهت سرعت و حافظه
یادآورترین نکات بهینهسازی ساده SDXL، مدل پیشرفته تولید تصویر هوش مصنوعی، با تأکید بر سرعت، حافظه و کارایی در مقالهٔ تازه ما.
 پژوهش
هوش مصنوعی در عمل: روشهای بهینهسازی مدلهای زبان بزرگ
با بهرهگیری از تکنیکهای Flash Attention، حافظهی مبتنی بر کلید-مقدار و بهبود جاسازهای موقعیتی، مدلهای زبان بزرگ را میتوان در محیطهای تولیدی بهینهتر استفاده کرد.
 مدلها
بهینهسازی Bark با 🤗 Transformers: صدای واضح و سریعترین زمان
مطالعه جدید Hugging Face پردازش سریعتر و مصرف کمتر حافظه مدل Bark را با ابزارهای Transformers، Optimum و Accelerate توضیح میدهد؛ سهمرحله ساده برای عملکرد برتر.
 مدلها
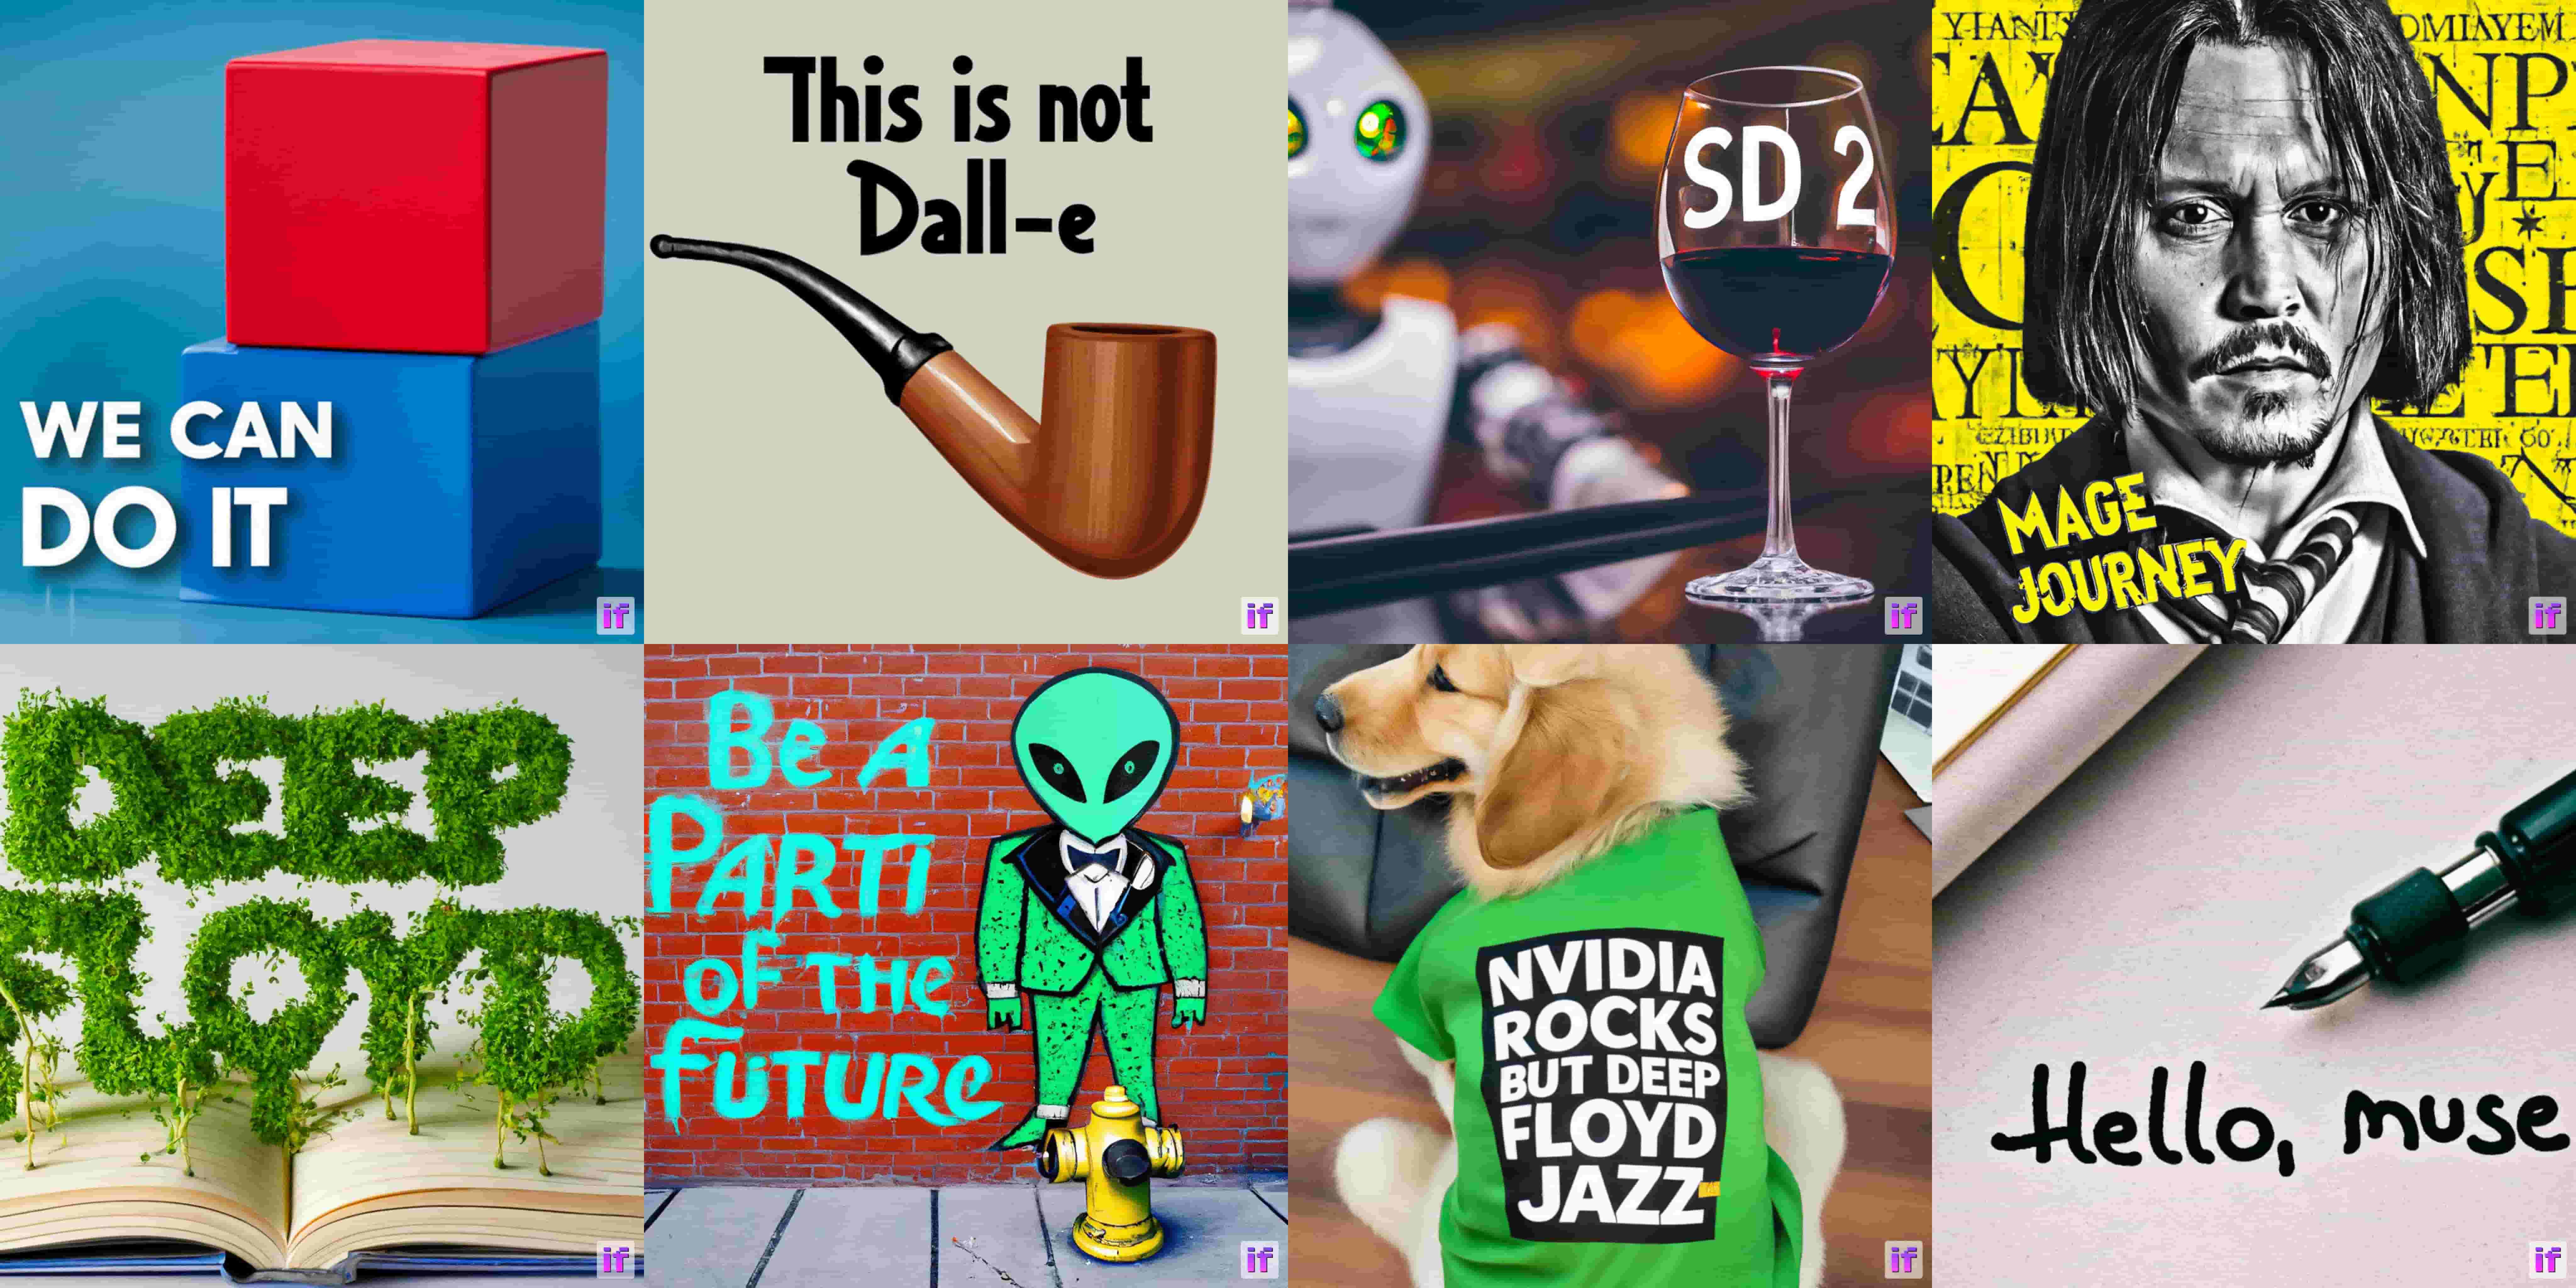
چگونه مدل IF متن به تصویر را در Google Colab رایگان اجرا کنیم؟
آموزشی گام به گام برای راهاندازی مدل IF، مدل متن‑به‑تصویر پیشرفته، با چارچوب diffusers در محیط رایگان Google Colab. نکات بهینهسازی حافظه و کدها.
 پژوهش
هوش مصنوعی: کشف جزئیات نظامهای پشتزمینه در OpenAI
مقالهای جامع در مورد معماریهای بکاند OpenAI است، که به نقش مهندسین سوپرکامپیوتر و تکنیکهای بهینهسازی در سکوهای توزیعشده میپردازد. نکات کلیدی در مدیریت حافظه، مسیریابی و مقیاسپذیری بررسی میشود.
 محصولات
همه چیز دربارهی شتابدهی مدلهای هوش مصنوعی با OpenVINO و 🤗 Optimum
بهدنبال بهبود سرعت مدلهای هوش مصنوعی؟ با یکپارچگی 🤗 Optimum Intel و OpenVINO، میتوانید مدلهای Transformers را در پردازندۀ Intel بهصورت سریع و کمیادگیری راهاندازی کنید.
 پژوهش
هوش مصنوعی در 8‑بیت: بهینهسازی ماتریسی برای ترنسفورمرهای بزرگ
مقاله حاضر به صورت سادهراهنمایی برای کاربرانی است که در بحث 8‑بیتی بازتاب کردن متن و کاهش مصرف حافظه در ترنسفورمرهای بزرگ علاقهمندند؛ مزایای سرعت و بهبود مصرف را بررسی میکنیم.
 پژوهش
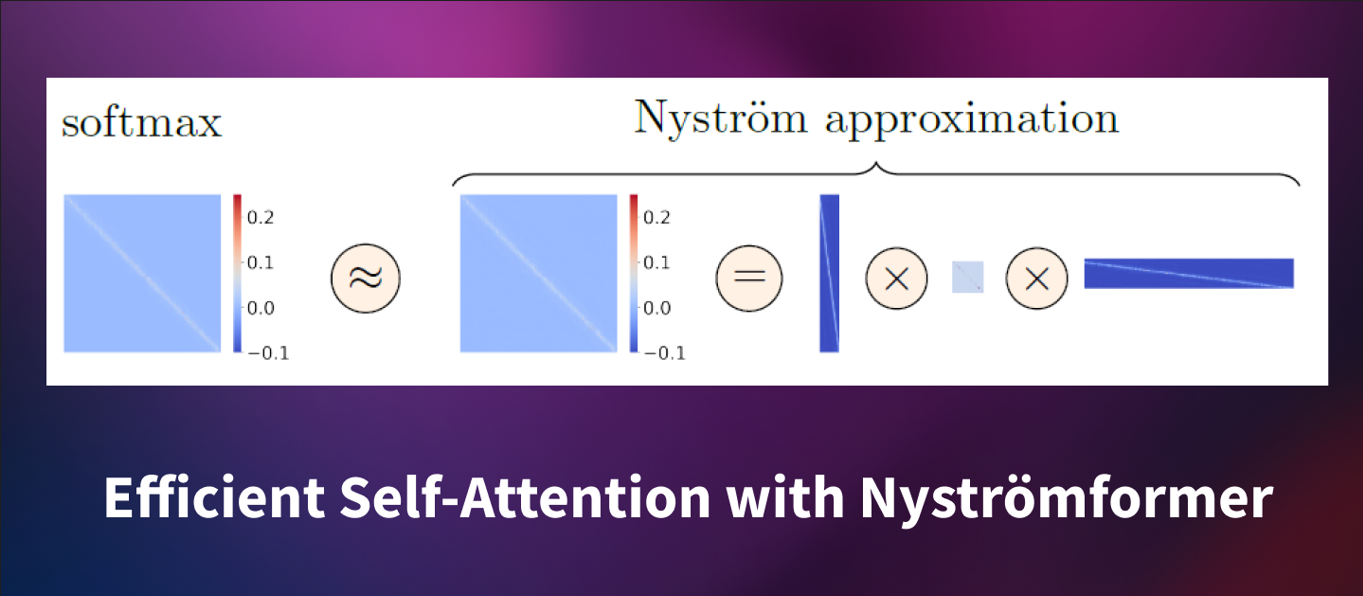
هوش مصنوعی: نیستروفرمری که زمان و حافظه ترنسفورمرها را کاهش میدهد
روش نیستروفرمری با بهرهگیری از تکنیک نیسترو، خود‑توجه در ترنسفورمرها را به صورت خطی ساختن میکند؛ کارایی آن در NLP و CV موثر است.