
 پژوهش
کشف قدرت یادگیری مداوم در هوش مصنوعی و نقش لیلیان وانگ
هوش مصنوعی با یادگیری مداوم، در پردازش زبان طبیعی و تصویر مدلهای نوین را ارتقا میدهد و نقش لیلیان وانگ در این انقلاب تاریخی بررسی میشود.
 پژوهش
پایگاه جامع دادههای صوتی در هوش مصنوعی: راهنمای کامل
کتابخانه 🤗 Datasets در Hugging Face نکات کلیدی برای بارگذاری، پردازش و استریم مجموعههای داده صوتی را ارائه میدهد؛ از جمله روشهای ساده پیشپردازش و کاربردهای مختلف این دادهها در حوزه هوش مصنوعی.
 پژوهش
هوش مصنوعی در جامعه اِلِکسیر: Bumblebee و مدلهای GPT‑2 تا Stable Diffusion
کتابخانهی Bumblebee در زبان اِلِکسیر، مدلهای هوش مصنوعی را از GPT‑2 تا Stable Diffusion به راحتی در برنامههای وب، پردازش داده و سیستمهای جاسازی شده قابل استفاده میکند. این ابتکار باعث پیشرفت کاربرمحور در حوزهی هوش مصنوعی میشود.
 پژوهش
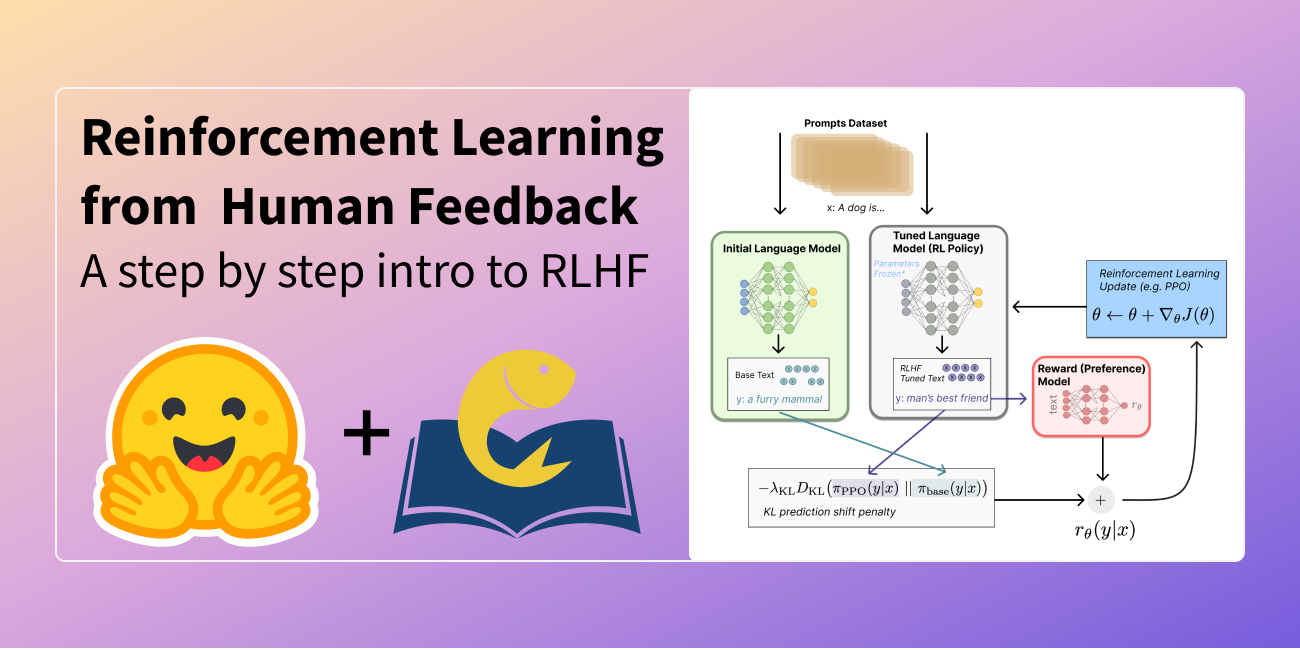
هوش مصنوعی با یادگیری تقویتی از بازخورد انسانی: رویکرد جدید شکافزن
مقالهای در شبکه هوش مصنوعی ارائه میدهد که چگونگی ترکیب یادگیری تقویتی با بازخورد انسانی برای بهبود مدلهای زبانی و افزایش شفافیت را نشان میدهد.
 پژوهش
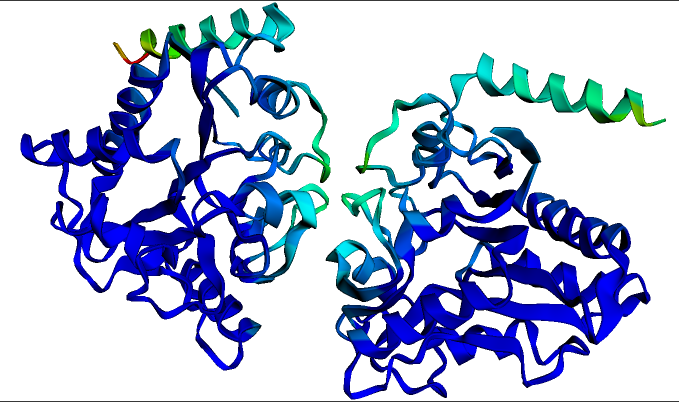
هوش مصنوعی در تحلیل پروتئین: تعمیم مدلهای زبانی بزرگ
این مقاله به بررسی چگونگی استفاده از مدلهای زبانی بزرگ مانند BERT و GPT در پیشبینی ساختار و عملکرد پروتئینها میپردازد و نقش یادگیری عمیق و دادههای باز در پیشرفت علم پزشکی را روشن میکند.
 مدلها
هوش مصنوعی ChatGPT: نوآوری در تعامل گفتگو و پاسخها
OpenAI با معرفی ChatGPT، مدل هوش مصنوعی قابل گفتگو را عرضه کرده؛ این سامانه میتواند سوالات پیگیر را پاسخ دهد، اشتباهات خود را بپذیرد و درخواستهای نامناسب را رد کند.
 مدلها
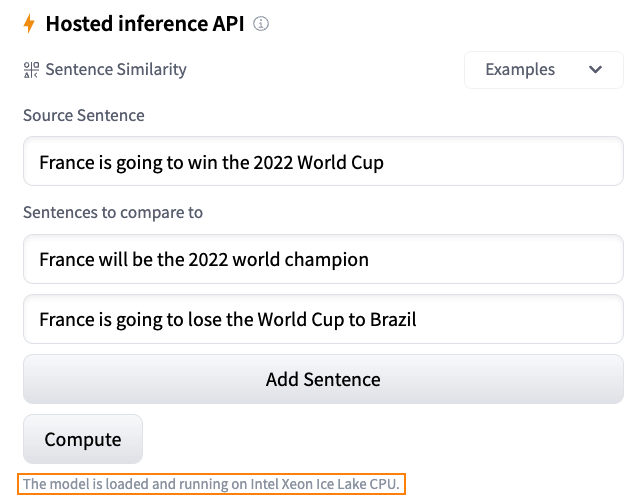
هوش مصنوعی در راهحلهای استنتاج: دیدگاههای Hugging Face و ادغام مدلها
این مقاله بهروز رسانیهای Hugging Face درباره راهحلهای استنتاج پیشرفته، ابزارها و قابلیتهای رایگان CPU، و ادغام مدلهای زبانی را بررسی میکند.
 پژوهش
هوش مصنوعی: با روش Contrastive Search، متنهای انسانی تولید کنیم
در این مقاله به بررسی روش Contrastive Search در تولید متن انسانی میپردازیم؛ کاربرد آن در مدلهای زبانی و دسترسی از طریق Hugging Face را به صورت کامل میفهمید.
 آموزش
چگونه Whisper را برای شناسایی صدا چندزبانه تنظیم کنیم؟
در این مقاله، گام به گام روش تنظیم دقیق مدل Whisper در Google Colab را معرفی میکنیم تا برای هر دیتاست چندزبانه ASR عملکردی بالا داشته باشید.
 پژوهش
هوش مصنوعی در برابر سوگیری: چگونه کتابخانهی 🤗 Evaluate سوگیری مدلهای زبانی را بررسی میکند
کتابخانهی🤗 Evaluate از Hugging Face بر پایه معیارهای جدید، امکان سنجش سوگیری مدلهای زبانی را فراهم کرده است؛ به سوی هوش مصنوعی بدون تبعیض پیش میرود.