
 سیاست و قانون
هوش مصنوعی ایمن: راهکارهای حکومتریزی سیستمهای عاملای
OpenAI با انتشار دستورالعملهای جامع، چکیدهای از روشهای چندگانه برای نظارت، شفافسازی و مدیریت ریسک سیستمهای هوش مصنوعی با عاملیت ارائه کرد و راهنمایی برای نوپاها.
 پژوهش
OpenAI با ۱۰۰ میلیتبلون بر سر سوپرهارمونی هوش مصنوعی، گرنتهای سریع را راهاندازی کرد
OpenAI با اعلام جایزههای سریع ۱۰۰ میلیون دلاری سوپرهارمونی، به پژوهشگران امکان میدهد نسبت به امنیت سیستمهای هوش مصنوعی بهسرعت پیش ببرند تحقیقات کنند.
 محصولات
هوش مصنوعی در بازنگری بازدیدهای پاتریوتیک: Summer Health تکمیل میکند
Summer Health با بهرهگیری از فناوری هوش مصنوعی OpenAI، دقیقترین یادداشتهای بیماری کودکان را تولید میکند و بازدیدهای پرستاری را بهینه میسازد. آنالیزهای فوری و یادداشتنویسی خودکار ضمن حفظ حریم خصوصی فراهم میکند.
 پژوهش
هوش مصنوعی: از مجمع ضعیف به تقویت قاطع برای تطبیق بهتر مدلها
این پژوهش جدید به بررسی چگونگی استفاده از ویژگیهای تعمیمپذیری یادگیری عمیق میپردازد تا مدلهای قدرتمند را با راهنماییهای نرمگیرندهی کمقدرت هدایت کند.
 اخبار
همکاری OpenAI و Axel Springer: هوش مصنوعی در رسانههای کمکی
OpenAI با Axel Springer توافقی را برای تعمیق استفاده مفید از هوش مصنوعی در روزنامهنگاری امضا کرده است؛ اولین شرکای رسانهای در این حوزه، گامی مهم در تحول رسانهها.
 مدلها
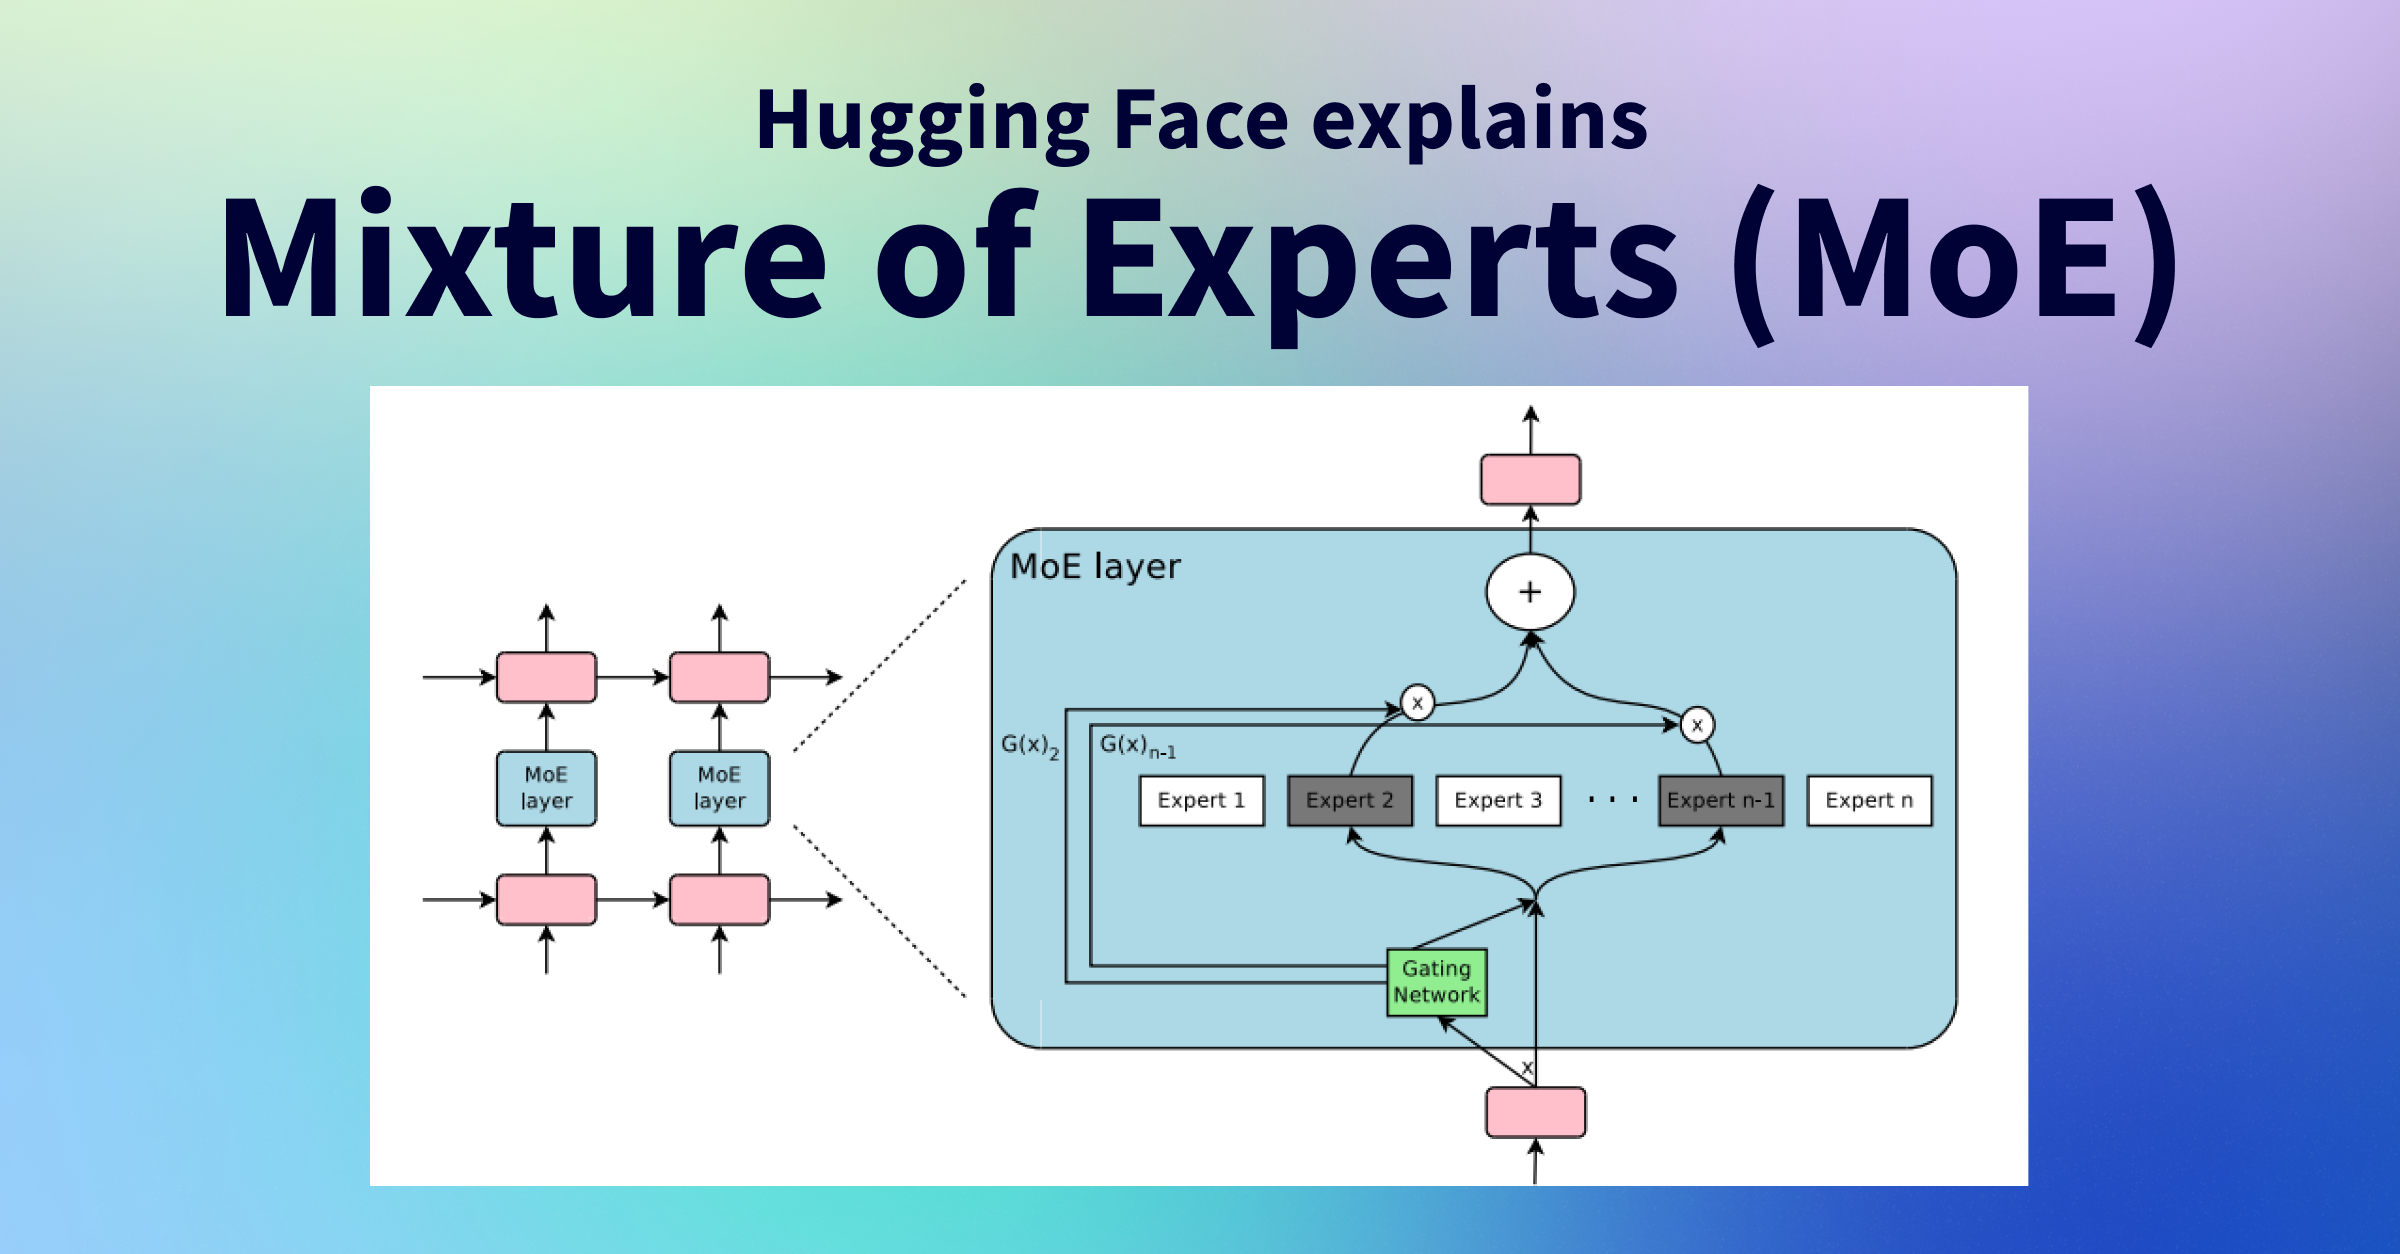
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 مدلها
هوش مصنوعی در Mixtral: مدل 8×7B مبتنی بر Mixture of Experts
مدل Mixtral با 8 expert در قالب Mixture of Experts، سریعتر از 12B و ثمرهدار 4× نسبت به 7B است؛ در دسترس بهصورت متنباز برای پژوهشگران هوش مصنوعی.
 پژوهش
هوش مصنوعی: SetFitABSA راهحلی خلاق برای تحلیل احساسات بر محور ویژگی
SetFitABSA، یک مدل کمنشانداد (few-shot) مبتنی بر SetFit، برای تحلیل دقیق احساسات پیرامون ویژگیهای خاص در متن، با سرعت و دقت بالا در دسترس است.
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.