
 اخبار
همکاری OpenAI و Axel Springer: هوش مصنوعی در رسانههای کمکی
OpenAI با Axel Springer توافقی را برای تعمیق استفاده مفید از هوش مصنوعی در روزنامهنگاری امضا کرده است؛ اولین شرکای رسانهای در این حوزه، گامی مهم در تحول رسانهها.
 مدلها
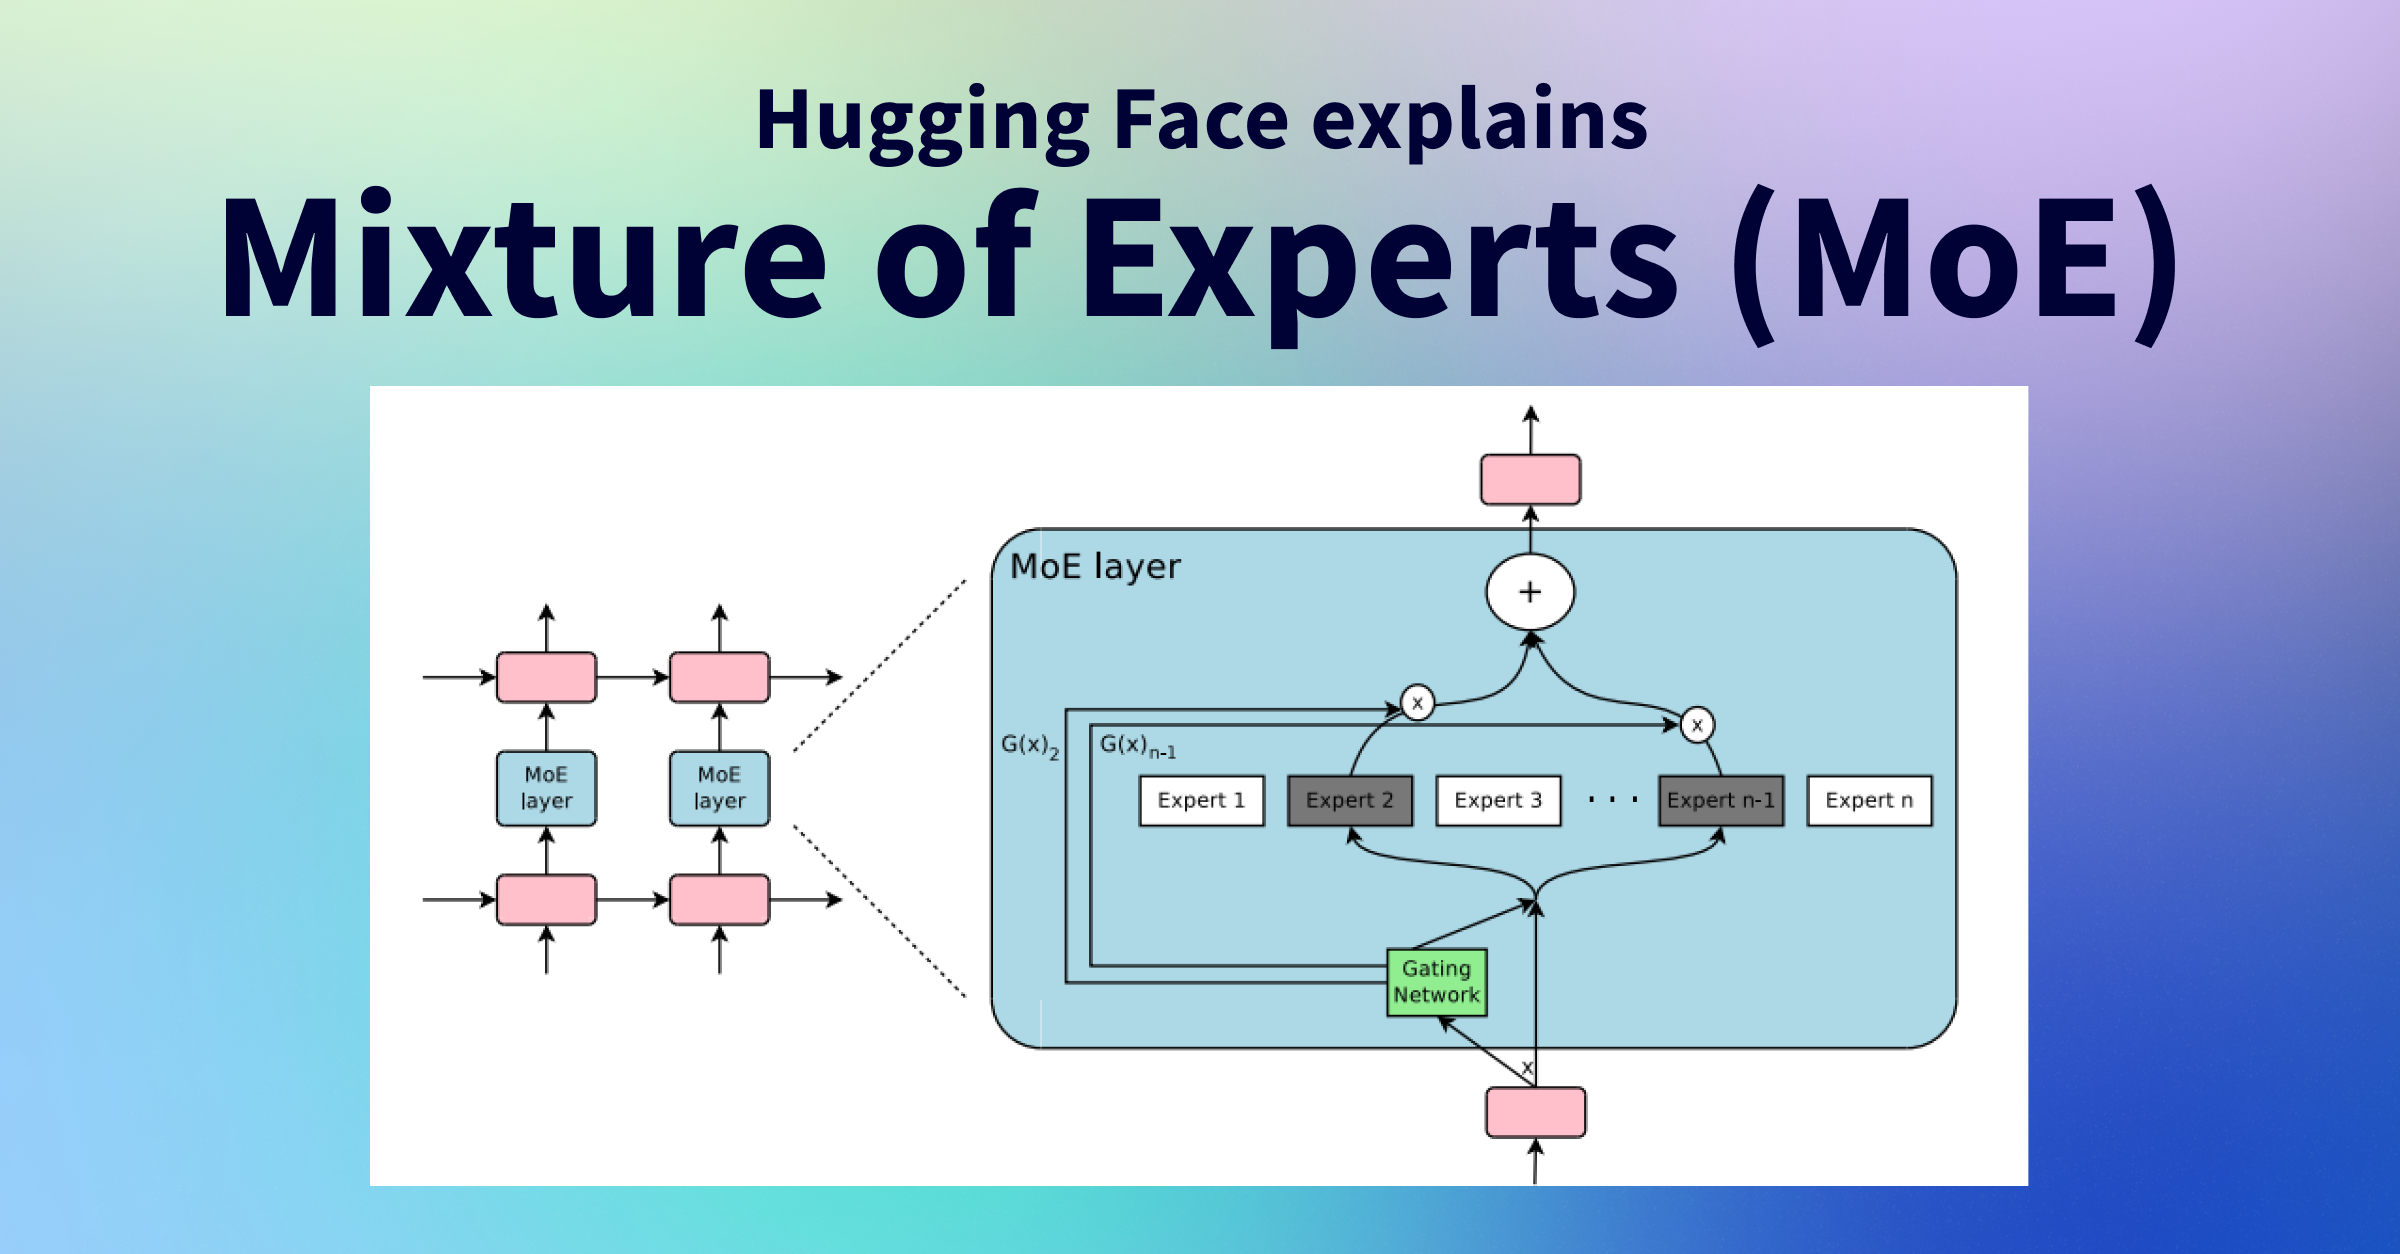
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 مدلها
هوش مصنوعی در Mixtral: مدل 8×7B مبتنی بر Mixture of Experts
مدل Mixtral با 8 expert در قالب Mixture of Experts، سریعتر از 12B و ثمرهدار 4× نسبت به 7B است؛ در دسترس بهصورت متنباز برای پژوهشگران هوش مصنوعی.
 پژوهش
هوش مصنوعی: SetFitABSA راهحلی خلاق برای تحلیل احساسات بر محور ویژگی
SetFitABSA، یک مدل کمنشانداد (few-shot) مبتنی بر SetFit، برای تحلیل دقیق احساسات پیرامون ویژگیهای خاص در متن، با سرعت و دقت بالا در دسترس است.
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 سختافزار
AMD و 🤗: تسریع LLMها بهصورت Out-of-the-Box با کارت گرافیک AMD
خبر جدید اینستیتوت هوش مصنوعی 🤗 و AMD، امکان اجرای سریع مدلهای زبانی بر کارتهای گرافیک MI300 را بدون نیاز به تغییر در کد، فراهم میکند.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 کسبوکار
سام آلتمن بهعنوان مدیرعامل OpenAI برمیگردد: هیئت جدید
خبر عجیب و هیجانانگیز در دنیای هوش مصنوعی. سام آلتمن بازگشت مدیر عامل OpenAI که با مدیرکل Mira Murati و رئیس Greg Brockman، سازمان جدیدی را تشکیل داده.
 اخبار
OpenAI پذیرش تغییر رهبری: گام مهندسی در آینده هوش مصنوعی
OpenAI اعلان میکند که رهبری شرکت از طریق فرآیند انتخابی رسمی تغییر میکند، نقطهی عطفی در مسیر پیشرفت هوش مصنوعی.