
 مدلها
هوش مصنوعی با GPT‑4o mini: کارایی بالا در هزینه کمتر
OpenAI با معرفی GPT‑4o mini، نسخهای کمهزینه و با قدرت مشابه مدلهای پیشین ارائه داد. این مدل امکان پردازش هوشمند را در هزینهای گزافکاهش میدهد.
 پژوهش
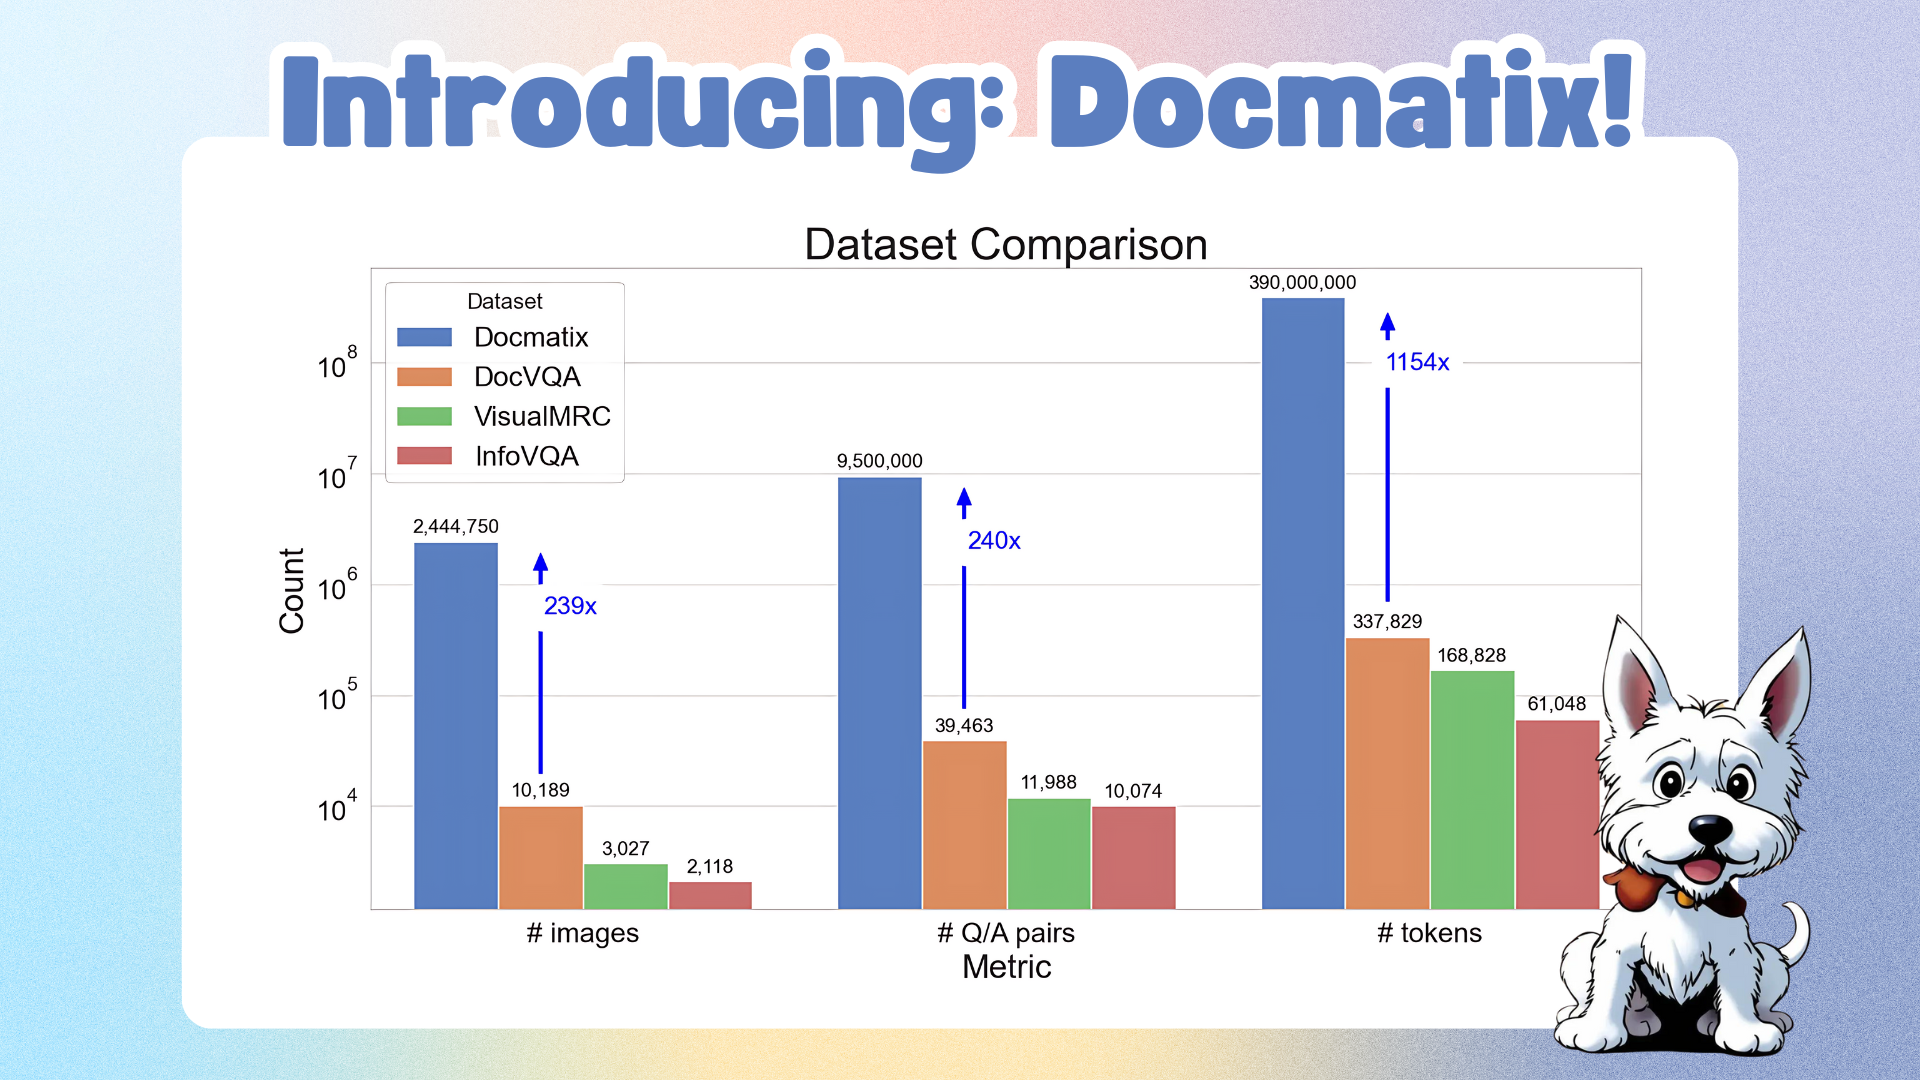
هوش مصنوعی: دیتاست Docmatix، ۲۴۰برابر بزرگتر از DocVQA برای پاسخگویی به سوالات تصویری در مستندات
در حالی که دیتاست DocVQA با ۱۰٬۰۰۰ تصویر کمبود داشت، Hugging Face دیتاستی تحت عنوان Docmatix را معرفی کرد؛ ۲.۴ میلیون تصویر و ۹.۵ میلیونپایهپاسخ برای پیشبینیهای عکس‑متن در مستندات PDF.
 پژوهش
بهینهسازی ترجیح برای مدلهای دید-زبان: گام جدیدی در هوش مصنوعی
پیشنیازهای جدیدی برای مدلهای دید-زبان، از طریق بهینهسازی ترجیح و کتابخانه TRL که در هگینگی فیس معرفی شده، امکان آموزش دقیقتر و مقرونبهصرفهتر را فراهم میکند.
 پژوهش
دستیار هوش مصنوعی Presidio: شناسایی خودکار اطلاعات خصوصی در دیتاستها
در این مقاله، چالشهای PII در دیتاستهای یادگیری ماشین را بررسی میکنیم و کارکرد Presidio، ابزار شناسایی خودکار اطلاعات خصوصی در Hugging Face Hub را معرفی میکنیم.
 سختافزار
گوگل TPU به هافِینگ فِیج معرفی شد: سرعت و مقیاسپذیری هوش مصنوعی نوین
هفتتویهای هافِینگ فِیج به بهرهگیری از TPUs گوگل Cloud پرداخته و امکانات جدیدی برای گسترش مدلهای هوش مصنوعی فراهم میکند؛ توضیحات کامل در این خبر.
 پژوهش
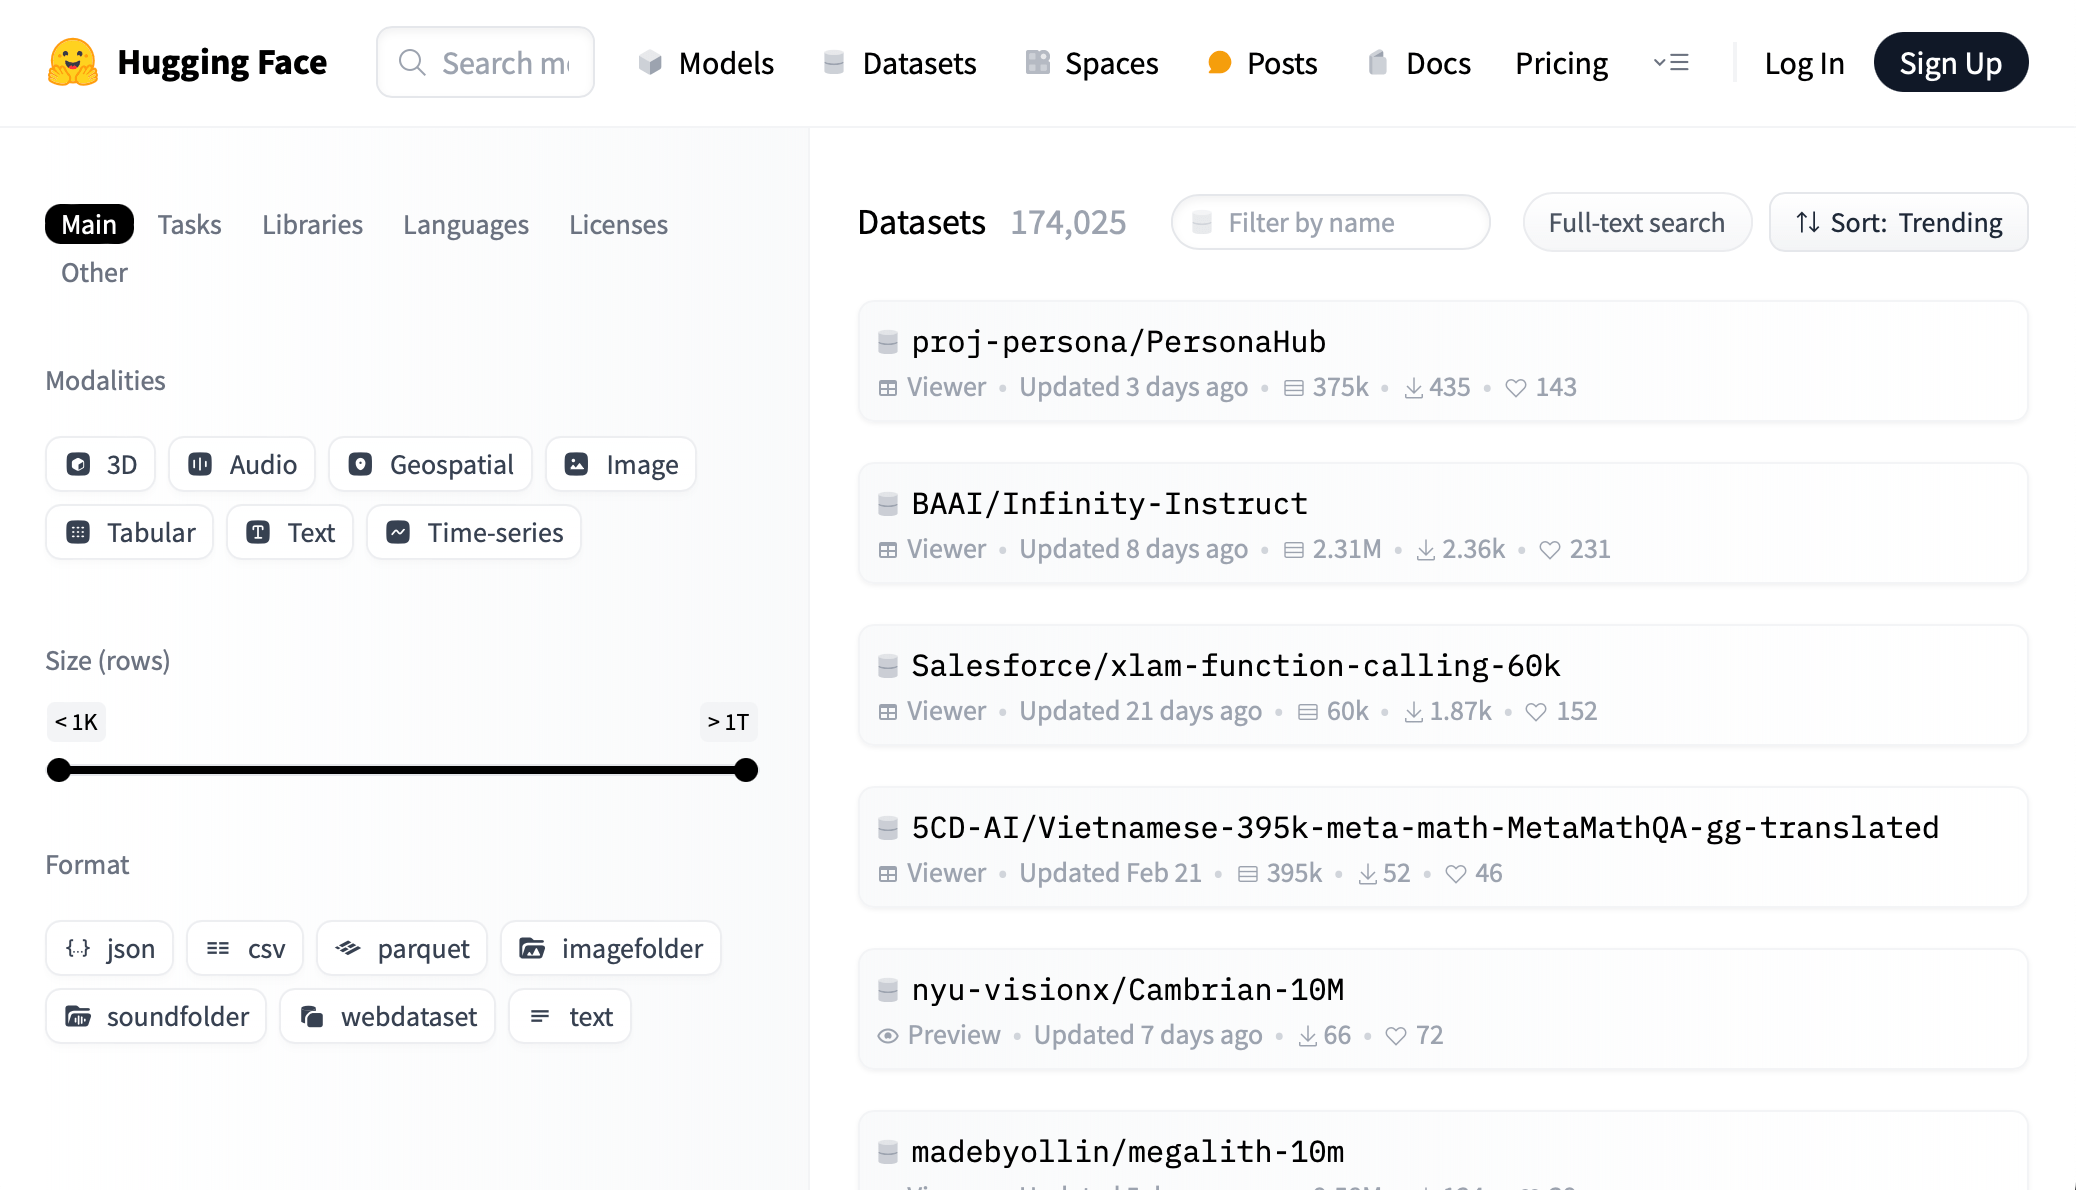
هفینگفیس معرفی میکند فیلترهای جستجوی هوش مصنوعی: مودالیتی، اندازه و فرمت دیتاست
هفینگفیس با افزودن فیلترهای مودالیتی، اندازه، فرمت و کتابخانه، جستجوی دیتاست را برای پژوهشگران و توسعهدهندگان هوش مصنوعی سادهتر کرده است. این ابزار جدید امکان انتخاب دقیق تر دیتا را فراهم میآورد.
 مدلها
گوگل معرفی میکند Gemma 2: آخرین مدل هوش مصنوعی متنباز
با معرفی Gemma 2، گوگل اولین مدل زبان متنباز نسل جدیدش را باز کرده و با امکانات پیشرفتهای نظیر sliding window attention و knowledge distillation، متنسازی را به سطح بالاتری برده است.
 پژوهش
هوش مصنوعی در ثبت اختراع: XLSCOUT ارائه کرد ParaEmbed 2.0 با ۲۳٪ افزایش دقت
XLSCOUT با همکاری Hugging Face معرفی ParaEmbed 2.0، مدل پیشرفتهای برای استخراج و همراستاسازی متون ثبت اختراع، با دقت ۲۳٪ بالاتر. این پیشرفت به عنوان گام مهمی در دیجیتالیسازی مالکیت فکری مطرح میشود.
 پژوهش
هوش مصنوعی: مدلهای سازگاری نسل جدید، تولید داده با کیفیت در یک مرحله بدون رقیب
OpenAI با معرفی تکنیکهای جدیدی برای آموزش مدلهای سازگاری، مسیر نوینی در تولید دادههای هوش مصنوعی ارائه میدهد؛ این مدلها در یک گام، با کیفیت بالا، بدون نیاز به آموزش رقابتی عمل میکنند.
 پژوهش
هوش مصنوعی در درمان سرطان: میهمان GPT-4o در Color Health
Color Health و OpenAI اپلیکیشن “Cancer Copilot” را معرفی میکنند؛ با GPT‑4o تشخیصهای کموجود را میشناسد و طرح درمانی شخصیسازیشده ارائه میدهد.