
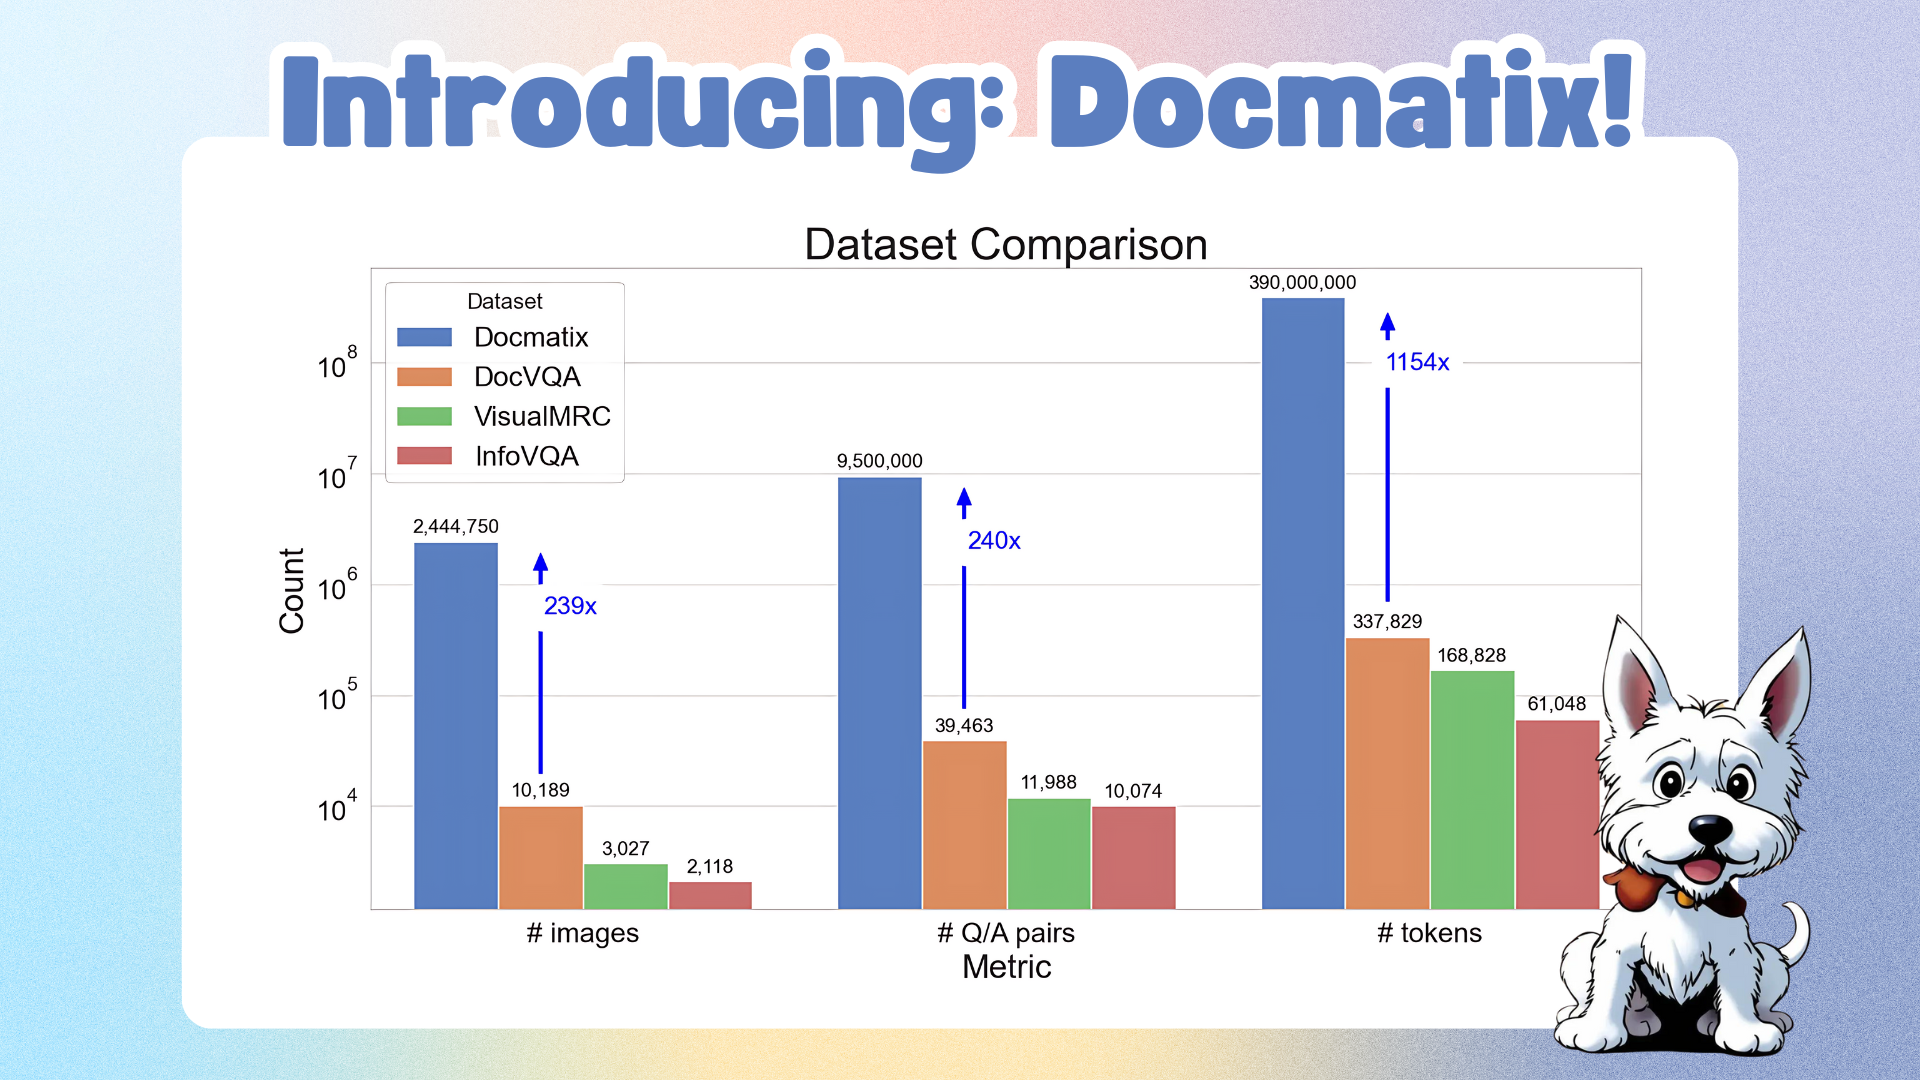
مقدمه بر دیتاست Docmatix
در سال ۲۰۲۴، انجمن “هگزینگ فیس” با هدف گسترش هوش مصنوعی باز و دیتاستهای بزرگ، به معرفی دیتاستی پرداخته که بهطور چشمگیر قابلیتهای پاسخگویی به سؤالات تصویری در مستندات را بالا برده است. این دیتاست تحت نام Docmatix شناخته میشود.
قابلیتها و مقایسه با دیتاسهای پیشین
Docmatix شامل ۲.۴ میلیون تصویر استخراجشده از ۱.۳ میلیون سند PDF و ۹.۵ میلیون جفت سوال–پاسخ است؛ این حجم تقریبا ۲۴۰ برابر دیتاست DocVQA که در گذشته تنها ۱۰٬۰۰۰ تصویر و ۳۹٬۰۰۰ جفت سوال–پاسخ داشت دست به دست میآورد. بهدلیل این بازارزانی، کیفیت و جامعیت مدلهای مبتنی بر تصاویر متن به طور قابل توجهی افزایش مییابد.
چگونه Docmatix میتواند مدلهای VLM را بهبود بخشد
- افزایش ۲۰٪ در عملکرد مدل Florence‑2 بر روی وظیفه DocVQA پیشبینی سوالات تصویری
- دستگاه پشتیبانی از PDFها برای استخراج و پردازش متن در طول زمان به صورت زنده
- بهکارگیری خردهسرویسهای ذخیرهسازی و پردازش در ابعاد بزرگ برای پژوهشگران و شرکتهای نوپا
Docmatix نه تنها در حوزه مستندسازی پیشرفته بررایش، بلکه در تمام زمینههایی که یادگیری ماشین و دید کامپیوتری برای استخراج دانش از مستندات مورداستفاده قرار میگیرند، نقش اساسی ایفا میکند. این دیتاست با انتشار آزاد، امکان ایجاد مدلهای یادگیرشی قویتر و مستقیماً در دسترس جامعه پژوهشی و صنعتی را فراهم میآورد.
پرسشهای پرتکرار
Docmatix در چه قالبی قابل استفاده است؟
دادهها در قالب JSON با تصاویر در فرمت PNG و فایلهای PDF نهایی، شامل فایلهای جفت سؤال–پاسخ ذخیره میشوند؛ این قالب به راحتی توسط فریمورکهای PyTorch و TensorFlow قابل خواندن است.
اين دیتاست چه تاثير بر مدلهای نفوذی مانند Idefics2 خواهد داشت؟
تقریباً ۲۰٪ افزایش دقت در تستهای DocVQA با استفاده از Docmatix نشان میدهد که حجم بالای دادههای تصویری برای بهینهسازی مدلهای VLM، به ویژه در کارهای مستندسازی، بسیار مؤثر است. این بهبود در اینترنت خاموش و آموزش ریتمیک میتواند سرعت توسعه الگوریتمهای نوظهور را تسریع کند.


