
 مدلها
هوش مصنوعی در دنیای واقعی: جدول ردهبندی مدلها برای کاربردهای شرکتی
هفتمان مه جدید، جدول ردهبندی ارزیابی عملکرد مدلهای زبانی در سناریوهای واقعی شرکتی را از سوی هیوگینگ فیند معرفی کرده؛ بخشهای مالی، قانون، خدمات مشتری و شناسایی حساسیت را پوشش میدهد.
 پژوهش
هوش مصنوعی در سطح بالاتر: لیستبندی حاکی از حواسپرتیها و راهحلها
بررسی کامل لیستبندی حواسپرتی مدلهای زبان بزرگ در هاجیینگ فیس، راهکارها، تأثیرات بر اعتمادسازی و چگونگی برقراری استانداردهای شفافیت در هوش مصنوعی
 پژوهش
هوش مصنوعی امن: لیور برد DecodingTrust و چالشهای جدید هوش مصنوعی
در آخرین پژوهش هابِیگنِگ فِیچ، لیور برد DecodingTrust بررسی جامع امنیت مدلهای بزرگ زبان (LLM) را معرفی میکند؛ نیاز به راهکارهای امنیتی برای هوش مصنوعی را برجسته میکند.
 پژوهش
هوش مصنوعی باز: زبانهای مدل باز به عنوان عاملان هوشمند LangChain
مقاله تازه در زمینه مدلهای زبانی متنباز و تبدیل آنها به عاملان هوشمند LangChain را بررسی میکند؛ با نکات نوآورانه در توسعه و بهرهبرداری!
 پژوهش
هوش مصنوعی: بهبود مدلهای زبانی با روشهای بهینهسازی ترجیحات مستقیم
در آخرین پژوهش از هاگفیس، روشهای بهینهسازی ترجیحات مستقیم میتوانند مدلهای زبانی را بدون استفاده از یادگیری تقویتی همگرا کنند. نتایج نشان میدهد IPO مشابه DPO و بهتر از KTO است.
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 پژوهش
هوش مصنوعی باز: چرا سال ۲۰۲۳ سال انقلابی در LLMها بود بهصورت کامل
در سال ۲۰۲۳، دنیای مدلهای زبانی بزرگ (LLM) بهدنبال بیسابقهای فرو رفت؛ بازسازی کود، داده، و همکاریهای جامعه باعث فروپاشی موانع دسترسی و پیشرفت سریع در هوش مصنوعی شد.
 مدلها
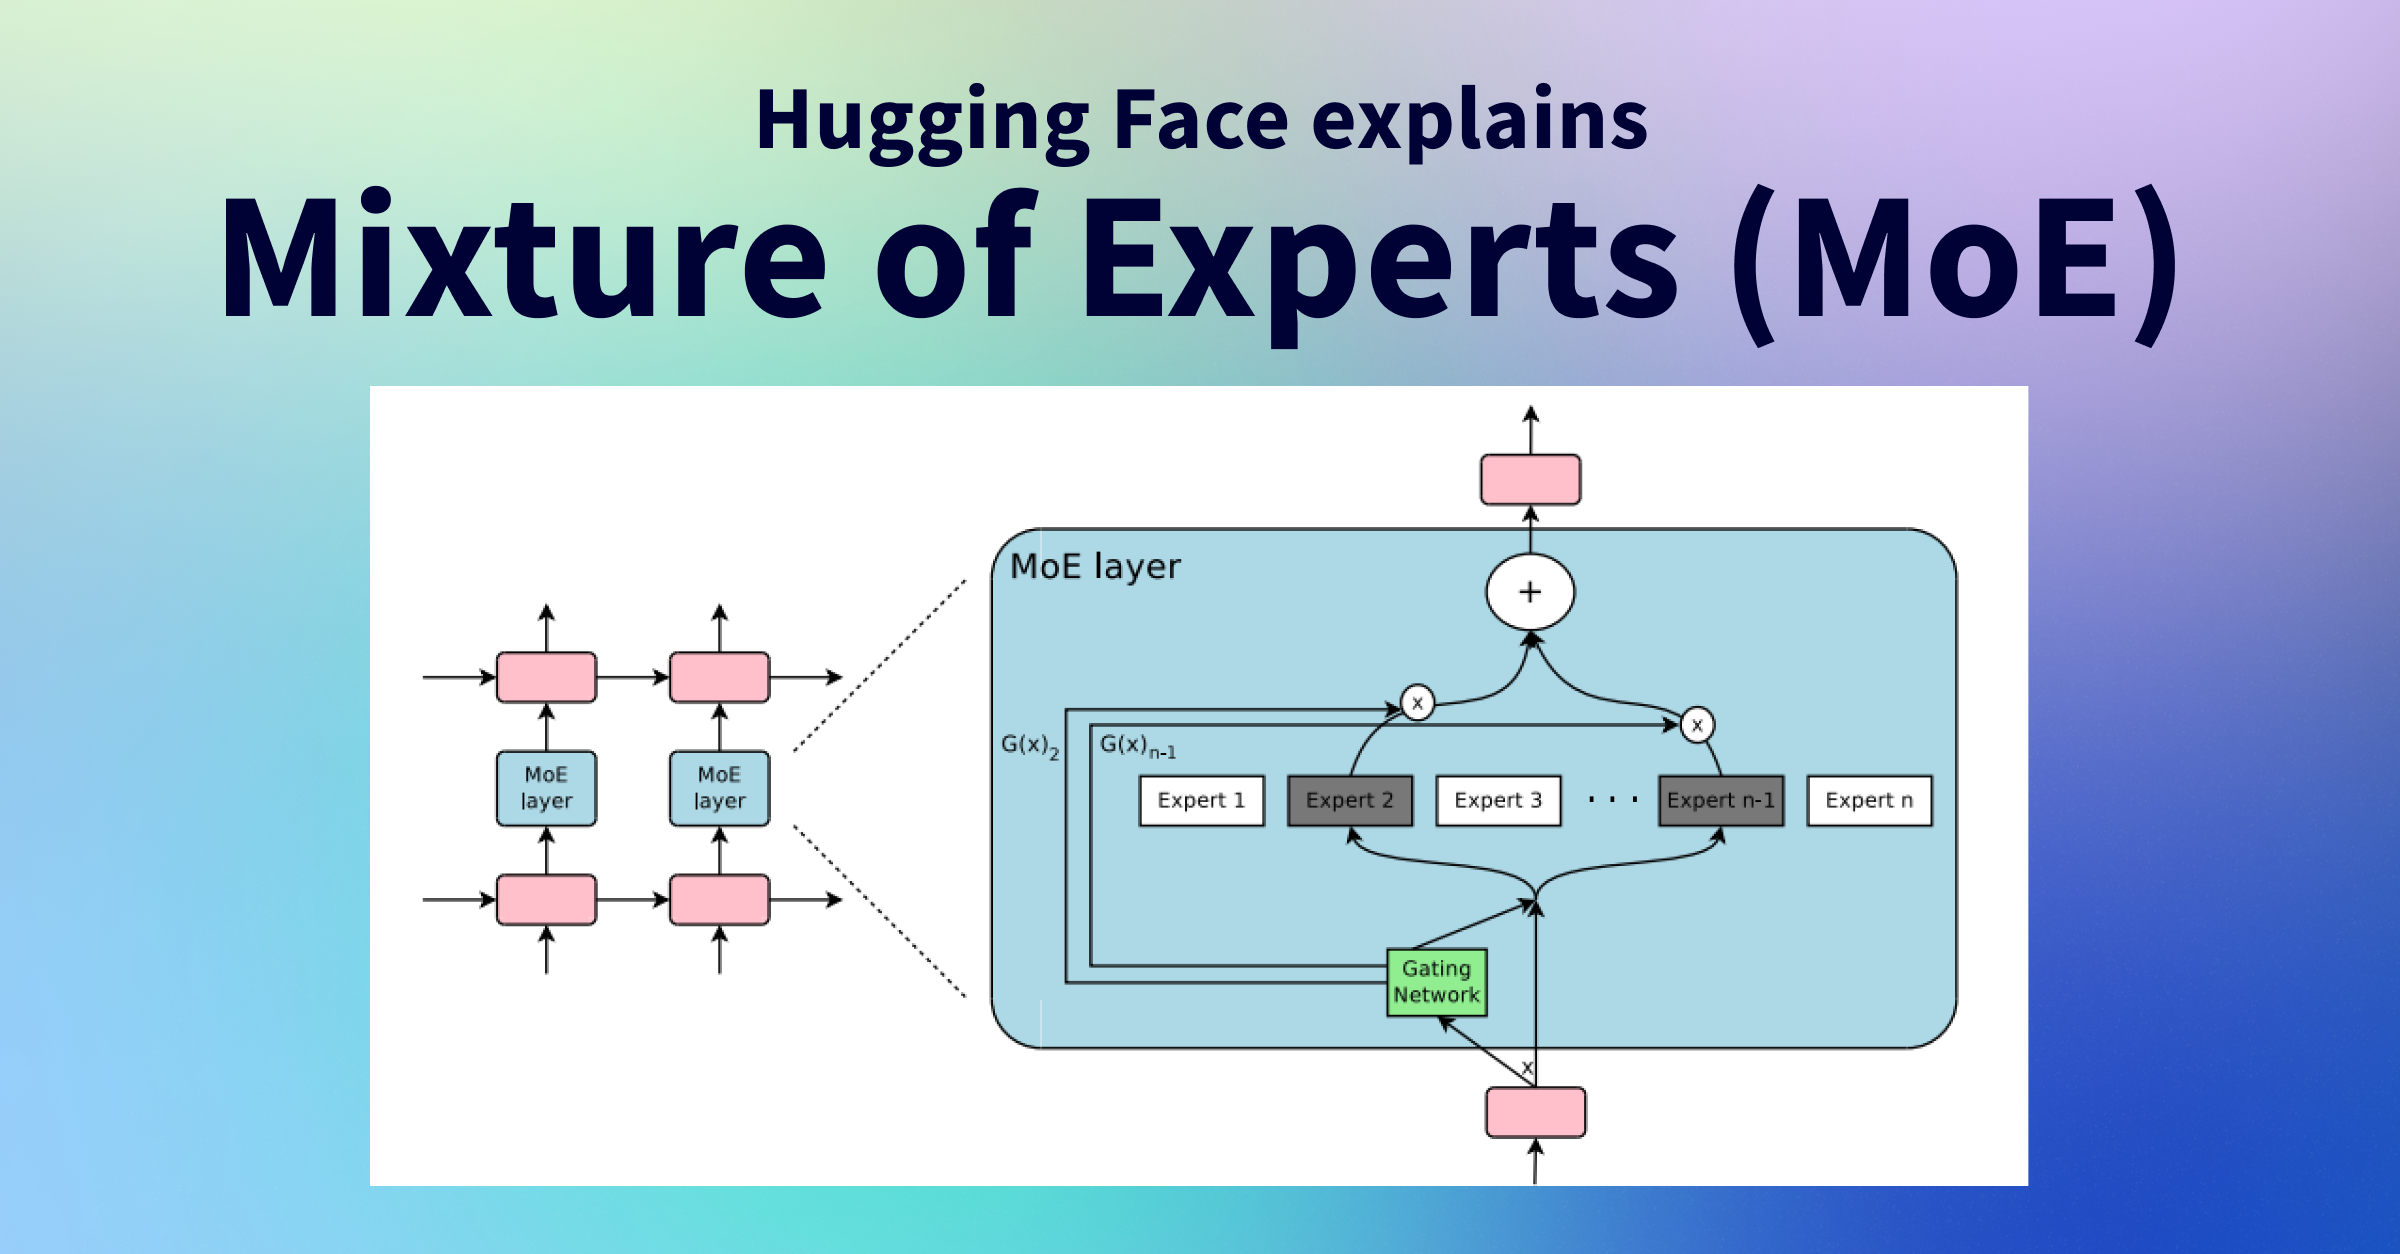
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 سختافزار
AMD و 🤗: تسریع LLMها بهصورت Out-of-the-Box با کارت گرافیک AMD
خبر جدید اینستیتوت هوش مصنوعی 🤗 و AMD، امکان اجرای سریع مدلهای زبانی بر کارتهای گرافیک MI300 را بدون نیاز به تغییر در کد، فراهم میکند.