
 اخبار
هوش مصنوعی در AWS: عرضه عمومی Text Generation Inference برای Inferentia2
هاگینگ فیس از در دسترس بودن عمومی Text Generation Inference روی AWS Inferentia2 و SageMaker خبر داد؛ راهکاری جدید برای استقرار مدلهای زبانی بزرگ بدون نیاز به GPU.
 مدلها
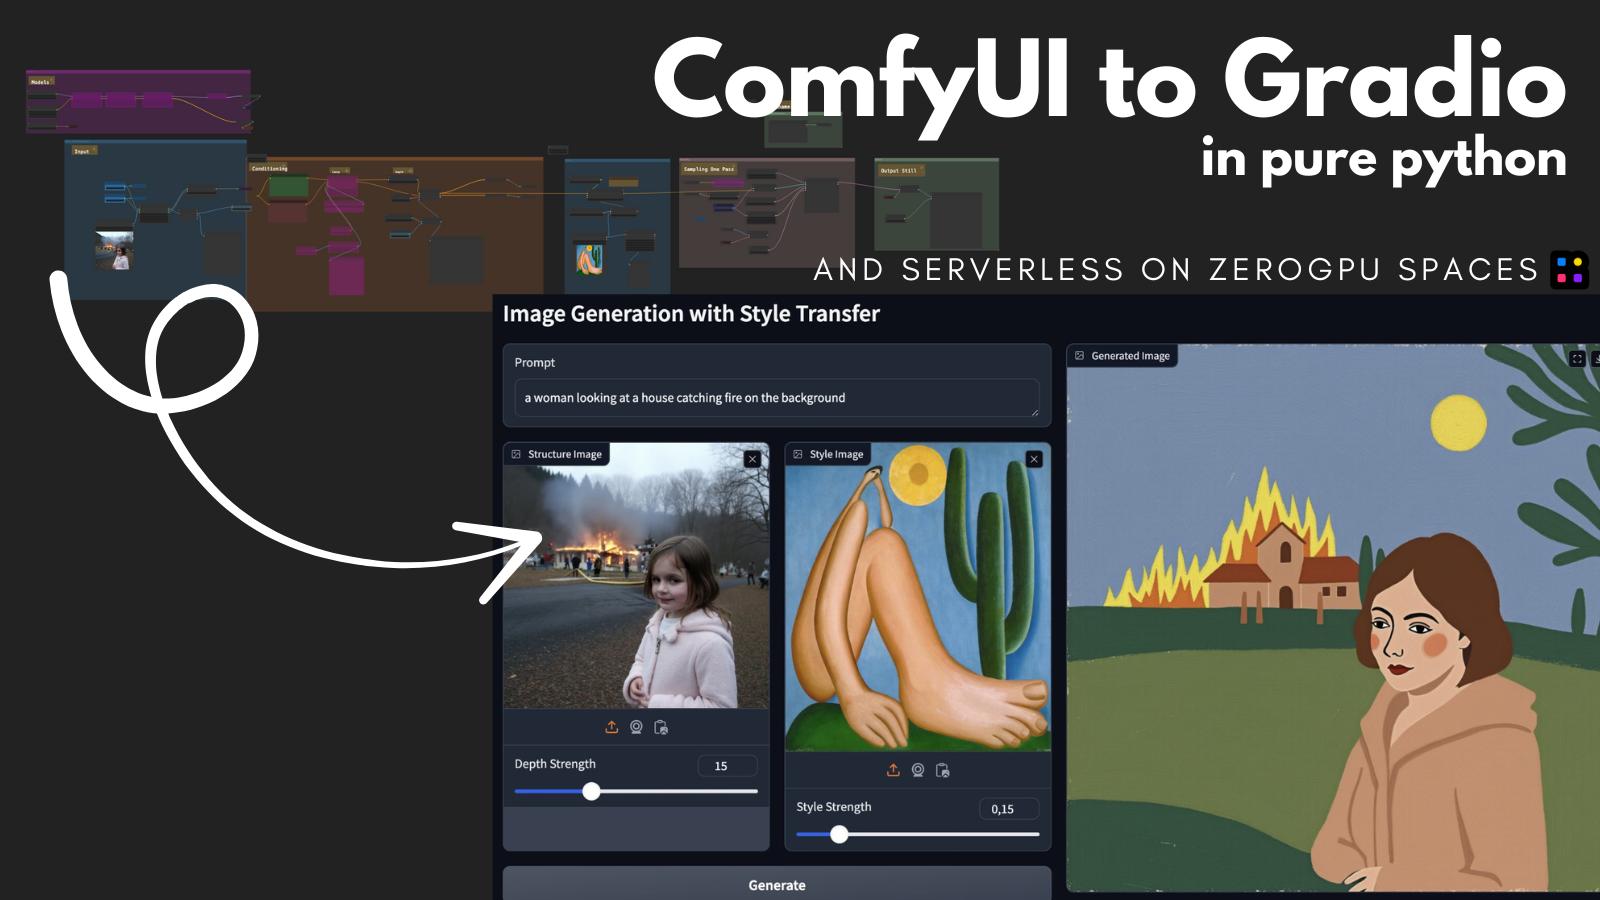
هوش مصنوعی در عمل: تبدیل ورکفلوهای ComfyUI به اپلیکیشن گراودری رایگان
در این مقاله، گامهای ساده تبدیل ورکفلو ComfyUI به گراودری و استقرار آزاد در Hugging Face ZeroGPU را بررسی میکنیم بهصورت ساده و بدون نیاز به سرور.
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 سختافزار
AMD و 🤗: تسریع LLMها بهصورت Out-of-the-Box با کارت گرافیک AMD
خبر جدید اینستیتوت هوش مصنوعی 🤗 و AMD، امکان اجرای سریع مدلهای زبانی بر کارتهای گرافیک MI300 را بدون نیاز به تغییر در کد، فراهم میکند.
 پژوهش
هوش مصنوعی در عمل: روشهای بهینهسازی مدلهای زبان بزرگ
با بهرهگیری از تکنیکهای Flash Attention، حافظهی مبتنی بر کلید-مقدار و بهبود جاسازهای موقعیتی، مدلهای زبان بزرگ را میتوان در محیطهای تولیدی بهینهتر استفاده کرد.
 سختافزار
همکاری Hugging Face و AMD برای تسریع مدلهای پیشرفته برای پلتفرمهای CPU و GPU
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 مدلها
بهینهسازی هوش مصنوعی Stable Diffusion برای CPUهای اینتل با NNCF و Optimum
بهینهسازی Stable Diffusion با NNCF و Optimum روی CPUهای اینتل، راهکاری نوین برای تولید تصویر با هوش مصنوعی بدون نیاز به GPU و با حفظ کیفیت است.
 مدلها
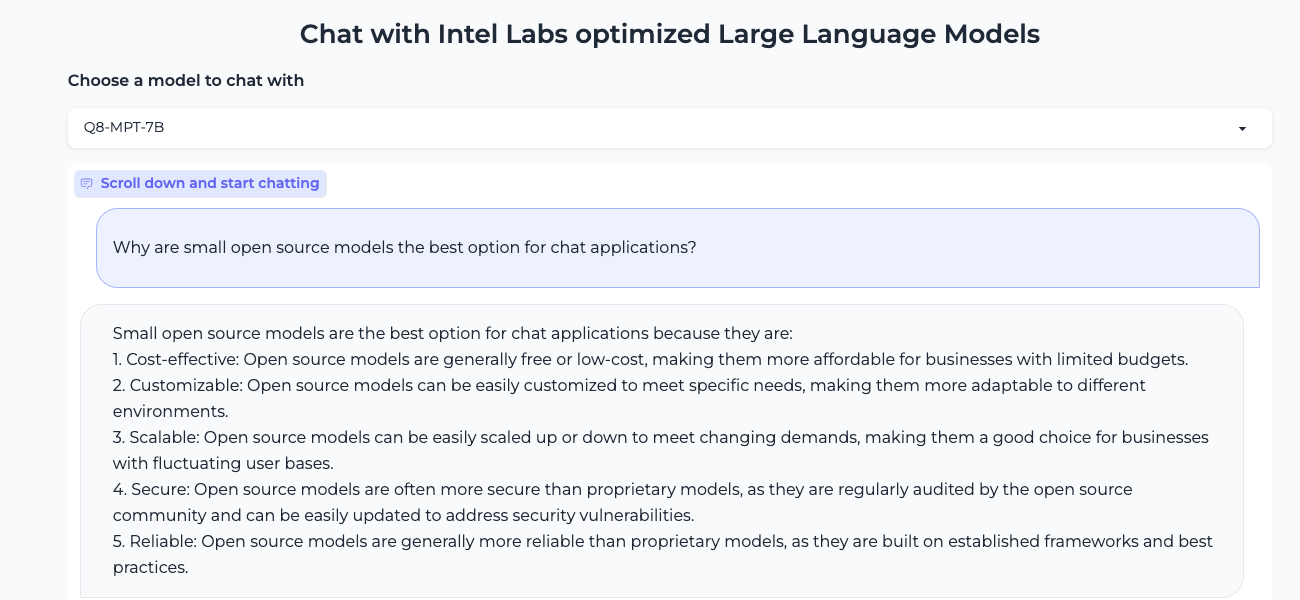
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.