
 پژوهش
لیست برداری هوش مصنوعی: ورود LLMهای ژاپنی به هافینگ فیس
این مقاله لیستبرداری Open Japanese LLM در هافینگ فیس را معرفی کرده؛ از ۲۰+ مجموعه داده و چالشهای ژاپنی در کنار ابزارهای پیادهسازی را جمعآوری کردهاند.
 پژوهش
هوش مصنوعی در کسبوکار: ۱۰۰+ پروژه موفق و بهترین راهبردهای پیادهسازی
در این مقاله، به بررسی ۱۰۰+ پروژه کمرنگ در صنعت فناوری، نقاط قوت و چالشهای پیادهسازی هوش مصنوعی در سازمانها پرداخته و راهکارهای عملی را معرفی میکنیم.
 پژوهش
دستیار هوش مصنوعی Presidio: شناسایی خودکار اطلاعات خصوصی در دیتاستها
در این مقاله، چالشهای PII در دیتاستهای یادگیری ماشین را بررسی میکنیم و کارکرد Presidio، ابزار شناسایی خودکار اطلاعات خصوصی در Hugging Face Hub را معرفی میکنیم.
 پژوهش
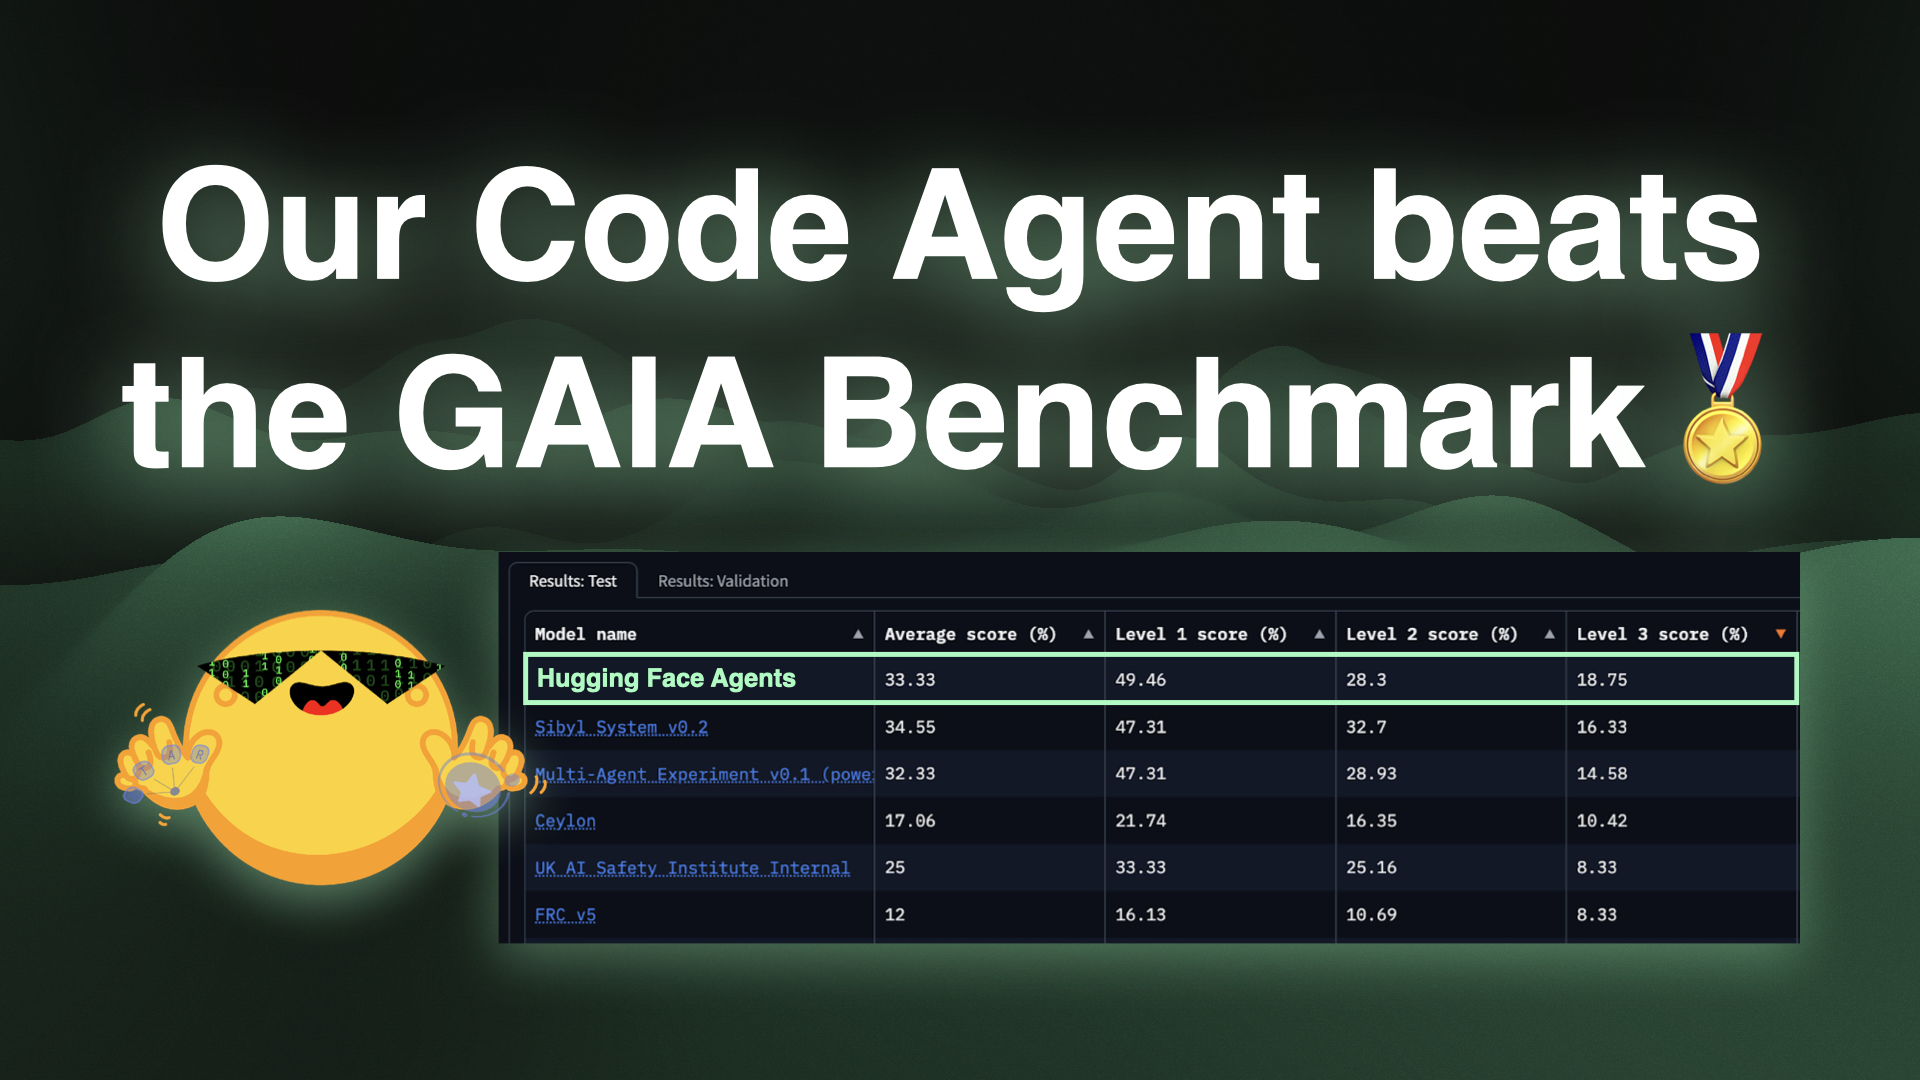
هوش مصنوعی مبتنی بر کد: رقیب GAIA را شکست داد و آینده را بازکرد
کود-عامل هیپینگ فیس، با بهرهگیری از معماری Transformer و کتابخانه smolagents، بر چالش GAIA بعنوان تمامسریترین معیارهای هوش مصنوعی ایستاد و اولین جایزه را به دست آورد. این دستاورد به سوی توسعهٔ هوش نمایی هوشمندانه افتاد.
 پژوهش
اطلاعات بهتر است وقتی با هم ترکیب شود: نگاه و چشمانداز هوش مصنوعی
به بررسی تاریخی و آیندهنگرانهٔ ادغام داده در هوش مصنوعی میپردازیم؛ چه چالشها و فرصتهایی برای پژوهش و توسعه مدلهای Hugging Face وجود دارد؟
 پژوهش
هوش مصنوعی صدای شخصی: چالشها و فرصتهای Voice Engine
OpenAI با پیشنمایش Voice Engine، مدلی برای ساخت صدای سفارشی، چالشها و فرصتهای فناوری صوتی را بررسی کرده است.
 پژوهش
واترمارکینگ هوش مصنوعی: ابزارها و تکنیکهای تشخیص محتوای تولیدشده
در این مقاله به بررسی روشهای واترمارکینگ یا نشانهگذاری محتوای تولیدشده توسط هوش مصنوعی میپردازیم؛ از تصاویر و متن تا صدا و چالشهای پیش رو.
 پژوهش
هوش مصنوعی امن: لیور برد DecodingTrust و چالشهای جدید هوش مصنوعی
در آخرین پژوهش هابِیگنِگ فِیچ، لیور برد DecodingTrust بررسی جامع امنیت مدلهای بزرگ زبان (LLM) را معرفی میکند؛ نیاز به راهکارهای امنیتی برای هوش مصنوعی را برجسته میکند.
 مدلها
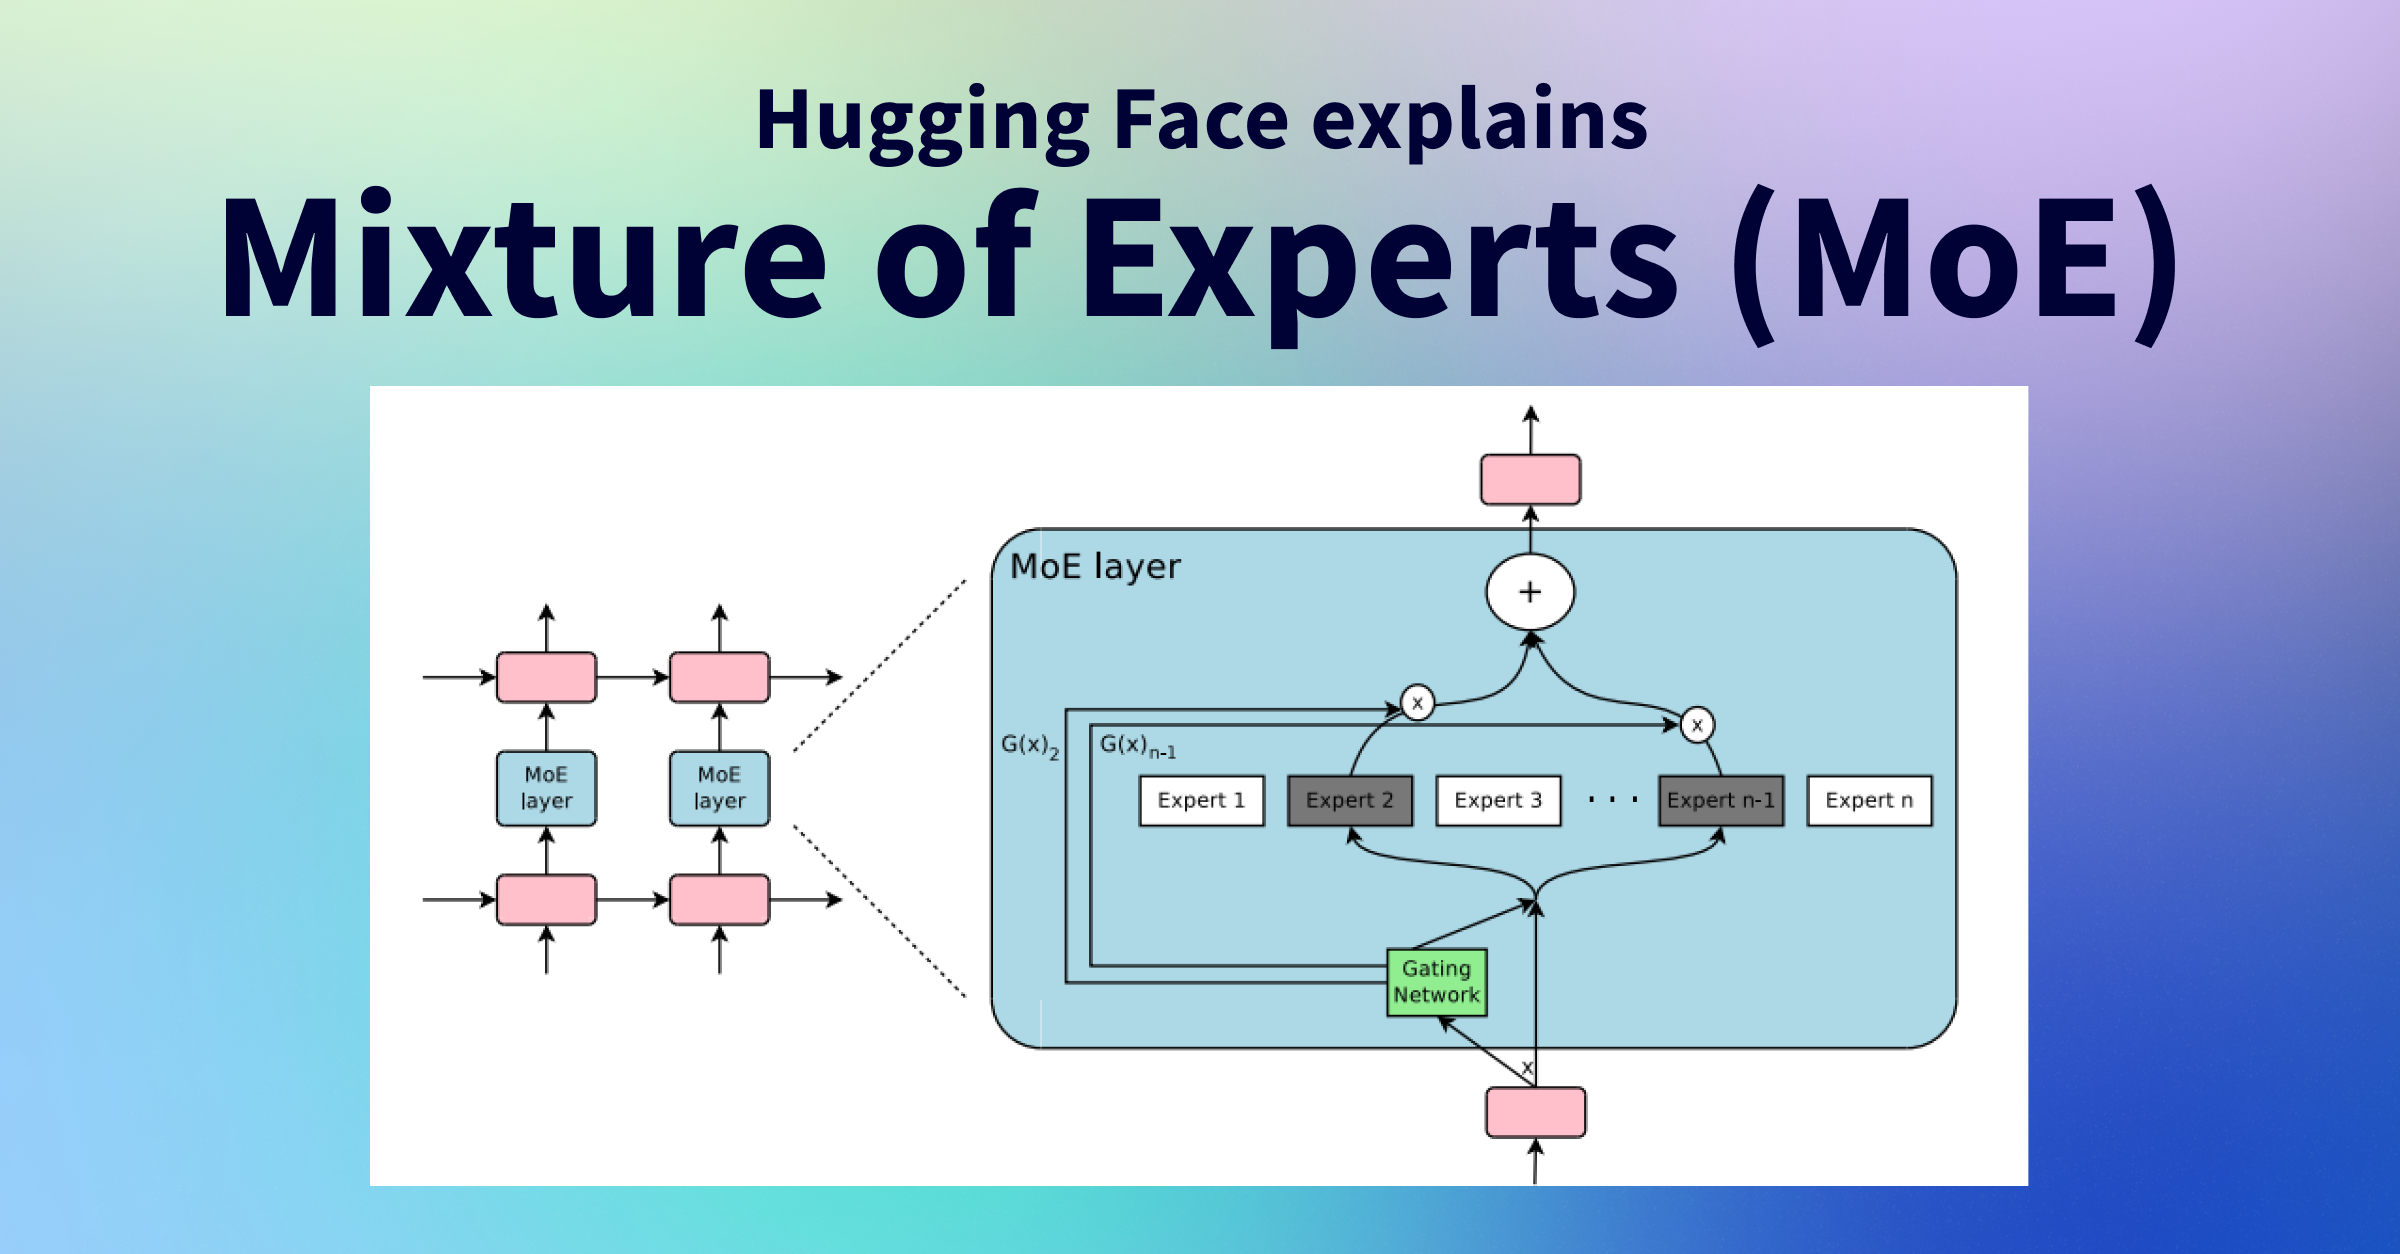
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.