
 پژوهش
هوش مصنوعی: گسترش الگوریتم گریدینت سیاست با PyTorch بر روی پلتفرم Hugging Face
در این مقاله به بررسی کاربرد Policy Gradient در PyTorch میپردازیم، این مسیر یادگیری تقویتی را در چارچوب تجاری و متن باز Hugging Face معرفی میکنیم و نکات عملی و کلیدی را برای توسعهگران بیان میکنیم.
 پژوهش
هوش مصنوعی و یادگیری تقویتی: DQN برای بازی Space Invaders در Hugging Face
در این مطلب، بهدست آوردن بازی مبدل پرش در Space Invaders با استفاده از الگوریتم Deep Q‑Learning (DQN) پرداخته شده و نحوه پیادهسازی در Hugging Face توضیح داده میشود.
 آموزش
کلاس عملی Q‑لرننج در هوش مصنوعی: مراحل، مثال و مفاهیم کلیدی
آموزش جامع Q‑لرننج، یکی از الگوریتمهای قدرتمند یادگیری تقویتی در هوش مصنوعی؛ با توضیح نکات کلیدی، تفاوتهای سیاستهای on‑policy و off‑policy، و یک مثال واقعی.
 پژوهش
هوش مصنوعی و یادگیری تقویتی: مقدمهای بر Q‑Learning در Hugging Face
بهروزترین مقالهٔ معرفی Q‑Learning در کلاس یادگیری تقویتی هوش مصنوعی توسط Hugging Face را بخوانید و مفاهیم کارآیی، بلمان و فرایندهای مونتکارلو را تسلط پیدا کنید.
 پژوهش
هوش مصنوعی در قهرمانان: معرفی Decision Transformers در Hugging Face
Hugging Face با ادغام Decision Transformer، اولین مدل یادگیری تقویتی آفلاین در کتابخانه Transformers را معرفی کرده و امکانات پژوهشی بیشتری را به دسترس همه ارائه میدهد.
 محصولات
Stable‑Baselines3 وارد هاب هگینگ فیس شد: گامی نو در حوزه هوش مصنوعی و یادگیری تقویتی
وارد شدن Stable‑Baselines3 به هاب هگینگ فیس، دسترسی آسانتر به مدلهای تقویتی و اشتراکگذاری منابع باز را برای طراحان AI فراهم میکند.
 پژوهش
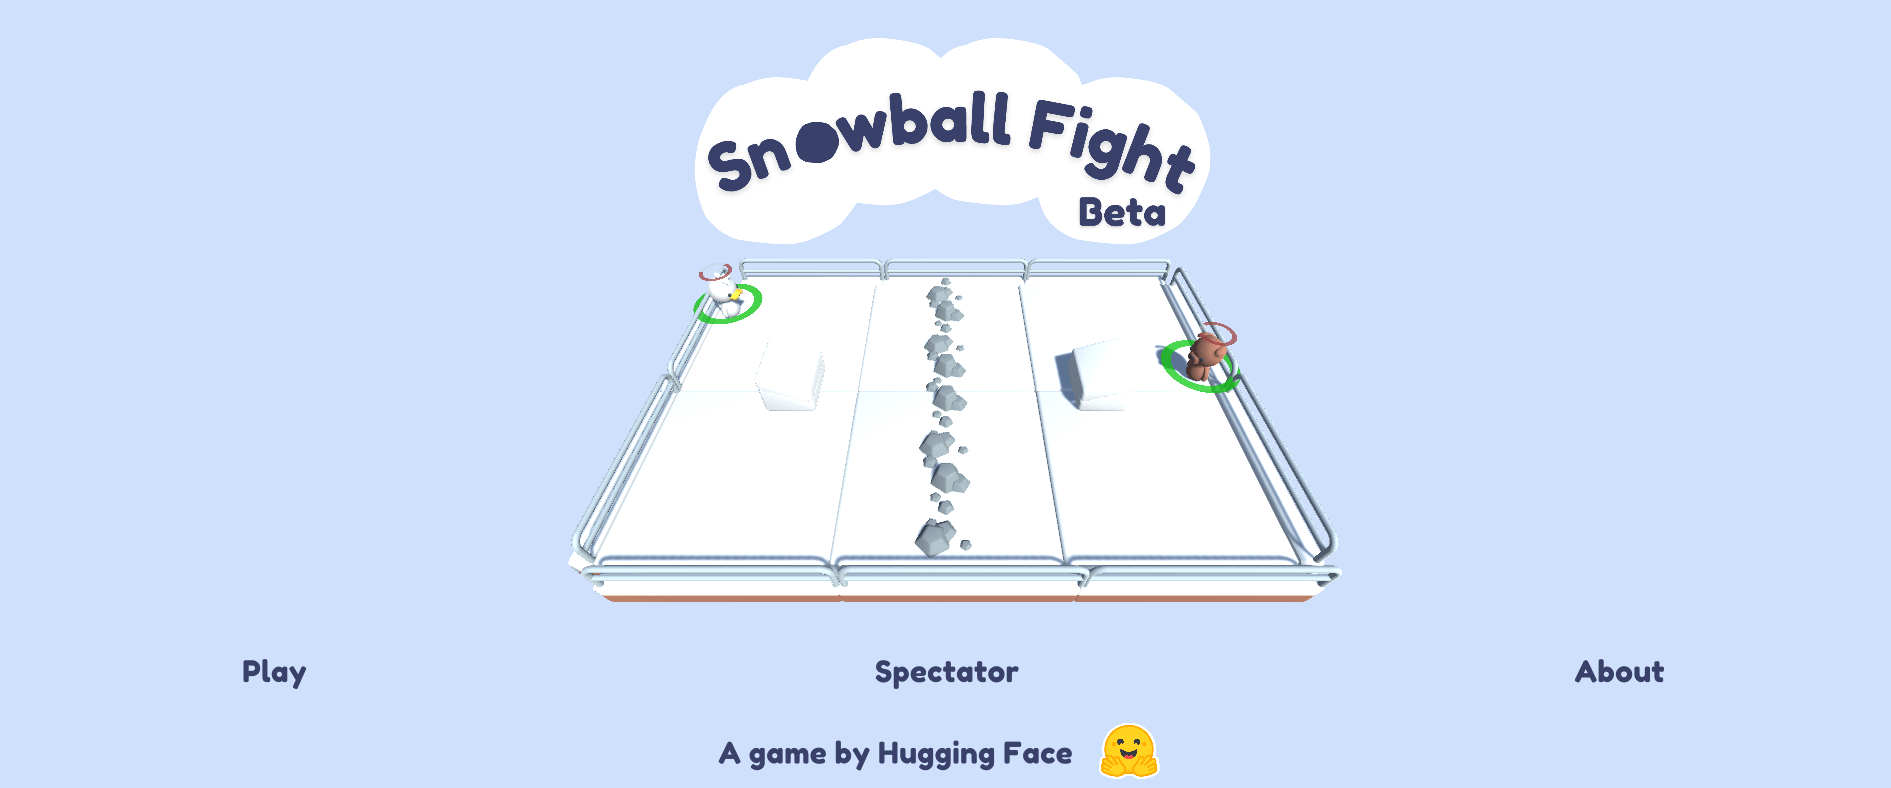
جنگ برفکیک: اولین محیط ML‑Agents برای یادگیری تقویتی در Unity
Hugging Face محیطی در Unity تحت نام Snowball Fight را معرفی کرده که با استفاده از ML‑Agents، امکان آزمایش مدلهای یادگیری تقویتی در یک بازی ساده است.
 پژوهش
آموزش مدلهای هوش مصنوعی برای خلاصهسازی بهتر با بازخورد انسانی
OpenAI با استفاده از یادگیری تقویتی از بازخورد انسانی، مدلهای زبانی را برای خلاصهسازی دقیقتر و باکیفیتتر آموزش داده است. این روش نتایج بهتری دارد.
 پژوهش
رقابتهای Procgen و MineRL در NeurIPS 2020؛ گامی برای هوش مصنوعی
OpenAI با همکاری AIcrowd، دانشگاه کارنگی ملون و DeepMind دو رقابت NeurIPS 2020 را با معیارهای Procgen و MineRL برگزار میکند.
 پژوهش
نبرد هوش مصنوعی با انسان در دوتا ۲؛ از یادگیری تقویتی تا قهرمانی
در وبلاگ هما، نگاهی میاندازیم به دستاورد بزرگ OpenAI در بازی دوتا ۲ با استفاده از یادگیری تقویتی عمیق و بررسی تأثیر آن بر آینده هوش مصنوعی و بازیهای ویدیویی.