
 پژوهش
هوش مصنوعی در زبان چک: BenCzechMark و آزمون دقیق مدلهای LLM
بنچکمارک اولین مجموعه ارزیابی جامع برای مدلهای بزرگ زبان (LLM) در زبان چک را معرفی میکند. با ۵۰ کار و ۹ حوزه، عملکرد زبانپردازی را اینچنین بررسی میکند.
 پژوهش
معیار SWE-bench Verified: ارزیابی دقیق هوش مصنوعی برای مشکلات واقعی نرمافزار
OpenAI با معرفی سازماندهی SWE-bench Verified، یک زیرمجموعه ارزیابی مجاز از ابزارهای هوش مصنوعی برای حل مشکلات واقعی نرمافزار ارائه میدهد.
 پژوهش
هوش مصنوعی: چگونه تولید خروجی ساختاریافته انتظارهای پایدار را برانگیزد
تجربههای جدید حاکی از حساسیت ارزیابی مدلهای زبانی به فرمتهای مدخل است. روش ساختاردهی خروجی در Hugging Face، ثبات را بهبود میبخشد.
 اخبار
جدول تازه سنجش هوش مصنوعی در پزشکی؛ ارزیابی مدلهای زبانی بالینی
هوگینگ فیس با انتشار جدول ردهبندی باز Medical-LLM، معیاری تازه برای ارزیابی مدلهای زبانی در حوزه سلامت ارائه کرده تا عملکرد هوش مصنوعی در کارهای بالینی شفافتر شود.
 پژوهش
ConTextual: معیاری تازه برای سنجش هوش مصنوعی چندوجهی در صحنههای متنی
آشنایی با ConTextual، معیار جدید Hugging Face برای ارزیابی مدلهای چندوجهی در درک همزمان متن و تصویر؛ گامی به سوی هوش مصنوعی باز و دموکراتیک.
 اخبار
TTS Arena: میدان رقابت مدلهای هوش مصنوعی تبدیل متن به گفتار
با معرفی TTS Arena، اکنون میتوانید مدلهای تبدیل متن به گفتار را بهراحتی مقایسه کرده و به کیفیت آنها رأی دهید. نتایج در لیدربورد رسمی نمایش داده میشود.
 پژوهش
رهبر جدید ارزیابی هوش مصنوعی کرهای با شفافیت کامل معرفی شد
پروژه Open Ko-LLM با همکاری آپ استیج و هافینگ فیس، اکوسیستم ارزیابی مدلهای زبانی کرهای را متحول کرد؛ رقابت منصفانه و شفافیت در این رهبر تضمین شده است.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 پژوهش
بررسی تعصب در مدلهای تولید تصویر از متن؛ چالشها و راهکارها
تعصب در مدلهای تولید تصویر از متن یکی از چالشهای جدی هوش مصنوعی است؛ در این مقاله منابع، روشهای شناسایی و راهکارهای مقابله با آن را بررسی میکنیم.
 اخبار
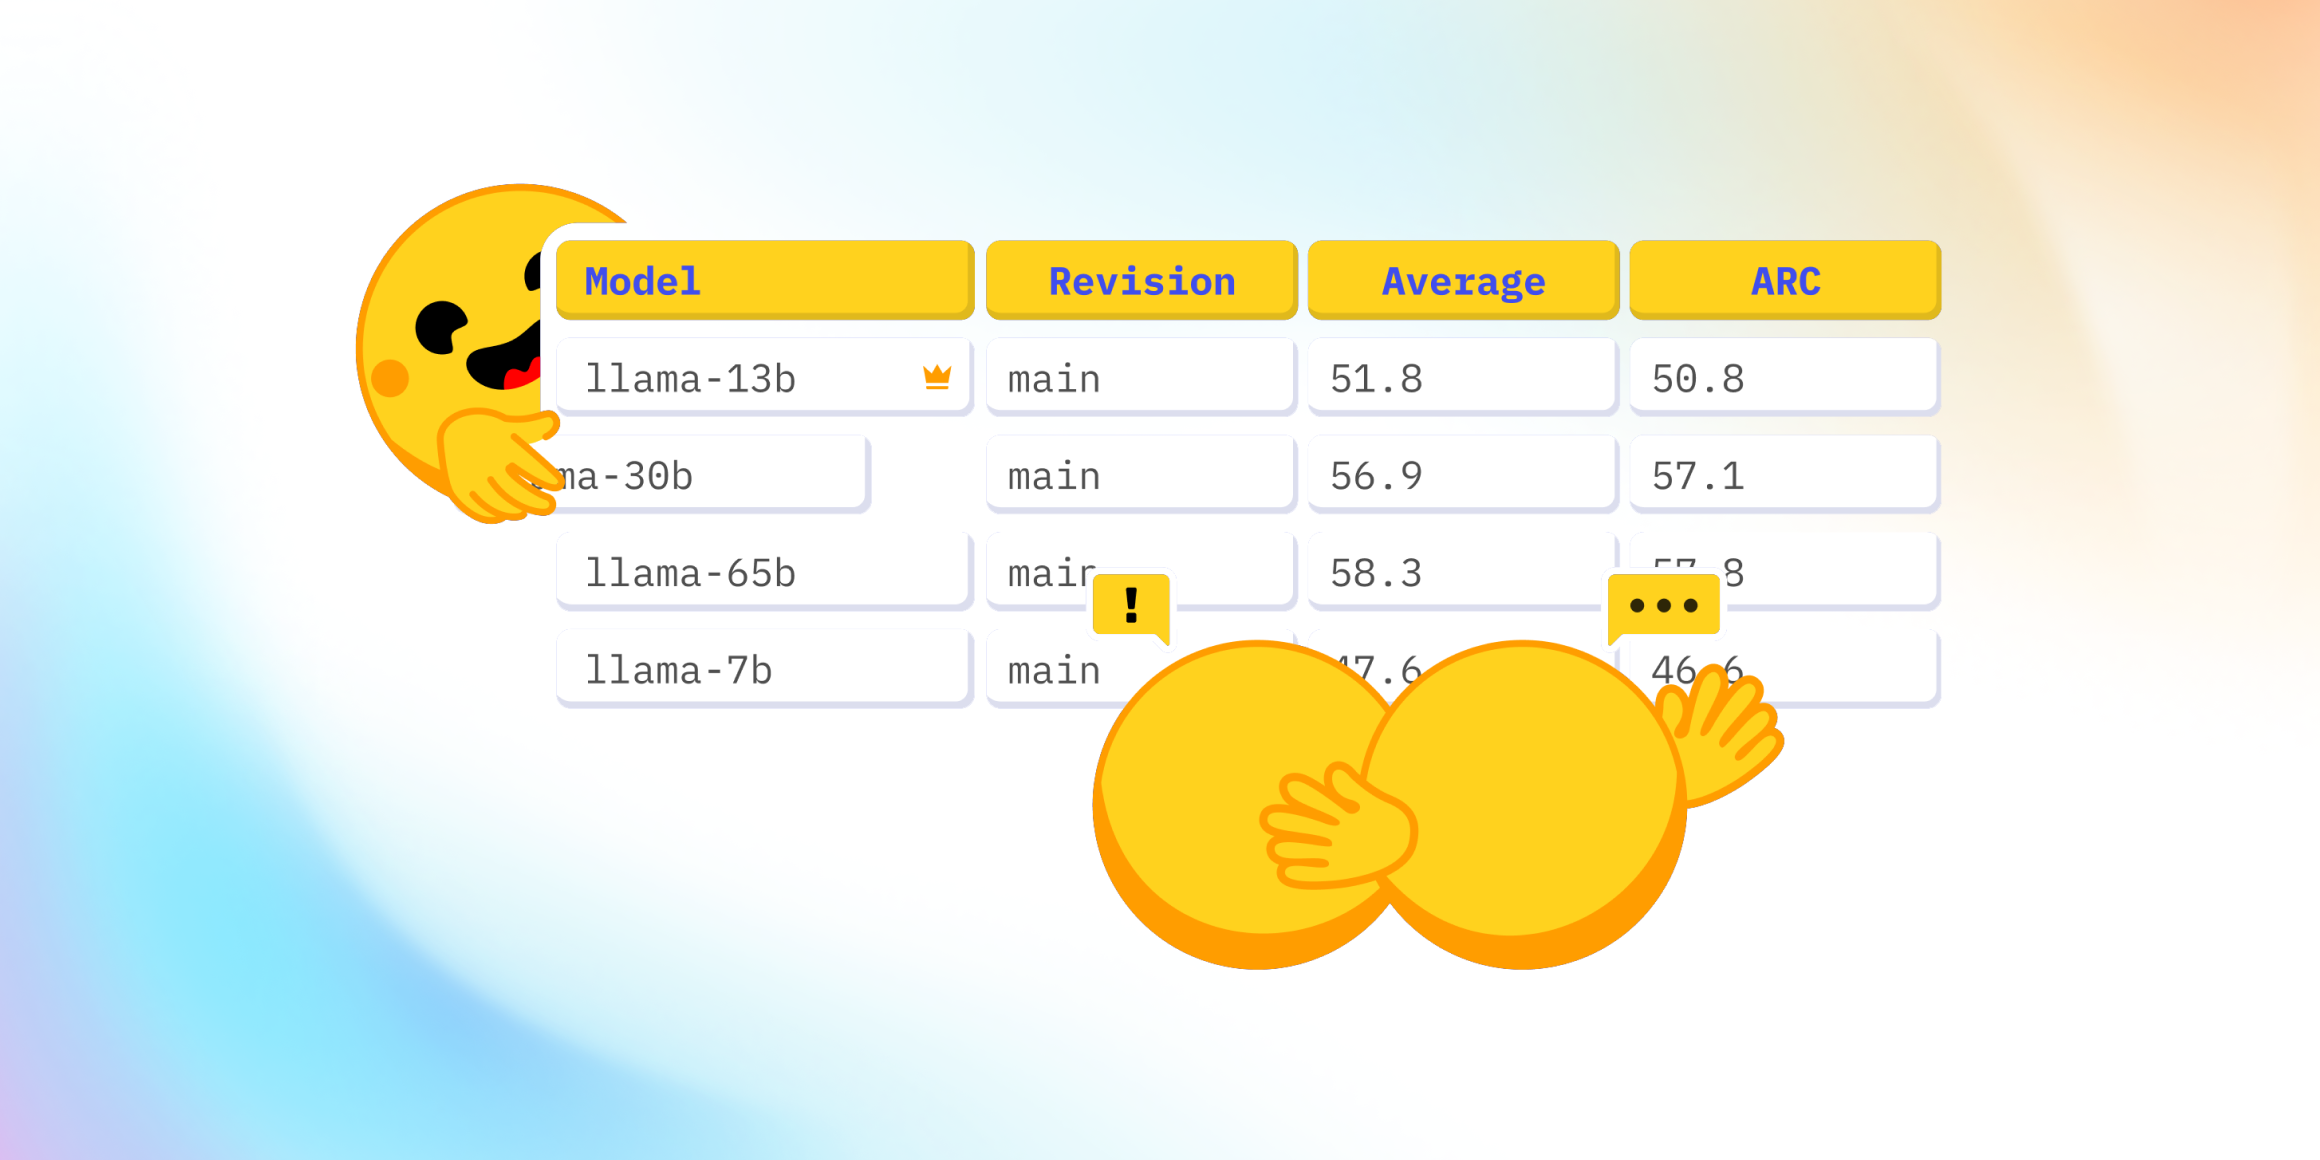
ابهامات در جدول ردهبندی مدلهای هوش مصنوعی هوگینگ فیس: چالش MMLU
هوگینگ فیس ابهامات اخیر در نتایج ارزیابی MMLU مدل LLaMA در جدول ردهبندی مدلهای زبان بزرگ آزاد خود را بررسی میکند. این ناهماهنگی بین امتیازات منتشر شده و نتایج ردهبندی، بحثهایی را در جامعه AI برانگیخته است.