اهمیت شفافیت در ارزیابی مدلهای زبان بزرگ آزاد
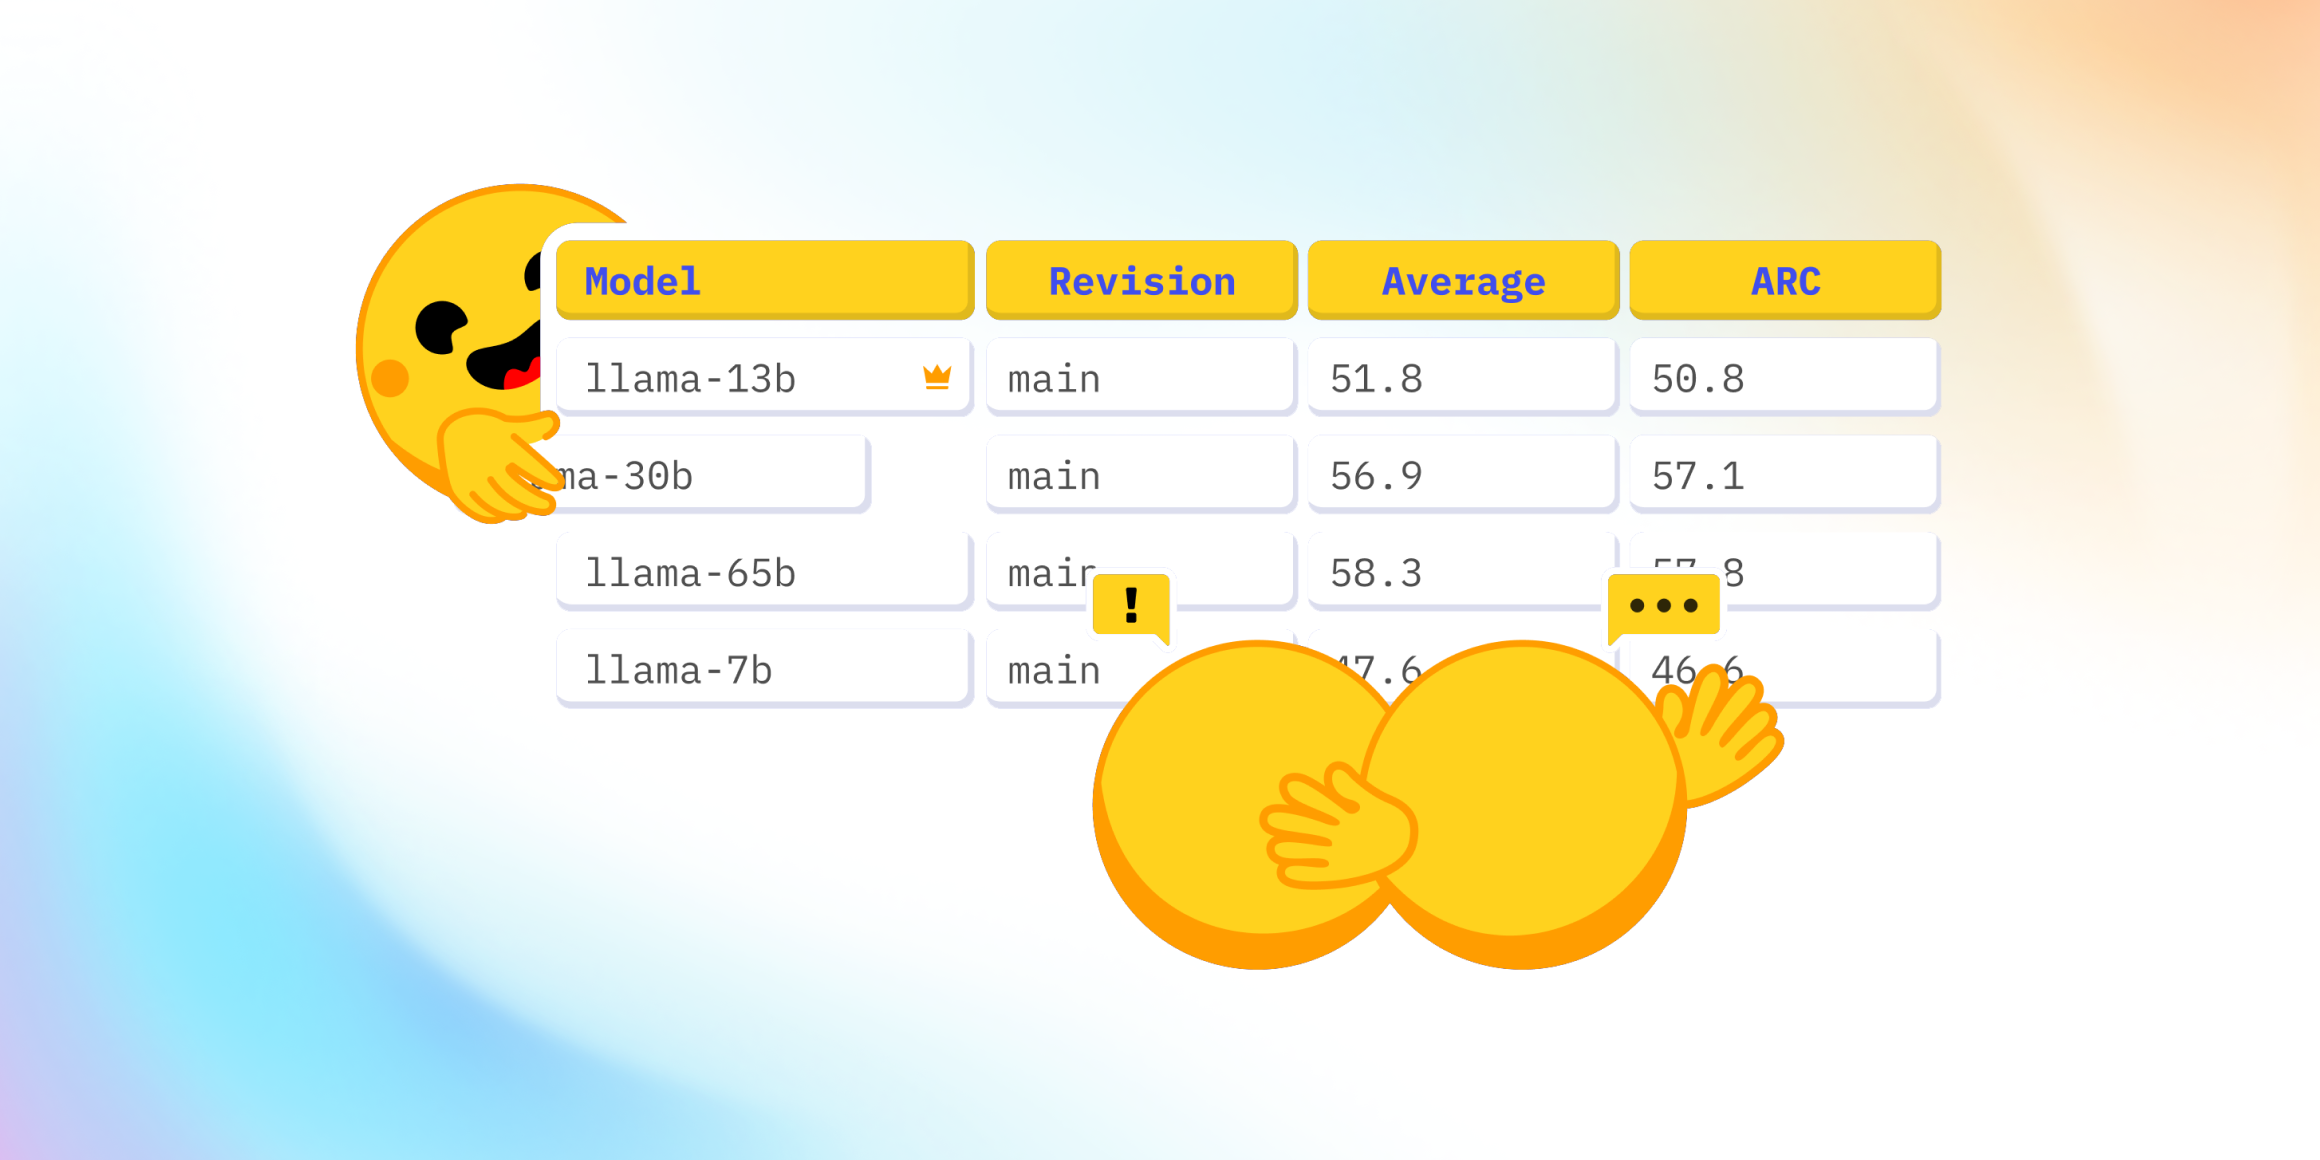
در دنیای پویای هوش مصنوعی، پلتفرمهایی مانند هوگینگ فیس (Hugging Face) نقش محوری در پیشرفت و دموکراتیکسازی AI از طریق رویکردهای متنباز و علم آزاد ایفا میکنند. جدول ردهبندی مدلهای زبان بزرگ آزاد (Open LLM Leaderboard) این پلتفرم، ابزاری حیاتی برای توسعهدهندگان و محققان است تا عملکرد مدلهای مختلف را مقایسه و ارزیابی کنند. این جدول به جامعه کمک میکند تا بهترین مدلها را برای کاربردهای مختلف شناسایی کند و به پیشرفت جمعی کمک شایانی مینماید.
اخیراً، بحثهایی در جامعه هوش مصنوعی پیرامون یکی از چهار ارزیابی اصلی نمایش داده شده در این جدول ردهبندی، یعنی بنچمارک MMLU (Massive Multitask Language Understanding)، مطرح شد. این چالشها حول محور ناهماهنگی در امتیازات مدل LLaMA متمرکز بودند که منجر به بررسی دقیق و متعهدانه از سوی تیم هوگینگ فیس شد.
چالش MMLU و مدل LLaMA: یک ناهماهنگی غیرمنتظره
MMLU یک بنچمارک شناخته شده برای سنجش توانایی مدلهای زبان در درک و پاسخگویی به طیف وسیعی از وظایف چندگانه است. این معیار، نشاندهندهٔ قابلیتهای مدل در حوزههای متنوعی از دانش انسانی است و از این رو، نقش مهمی در ارزیابی جامع مدلهای زبان ایفا میکند. جامعه هوش مصنوعی با شگفتی متوجه شد که امتیازات ارزیابی MMLU برای مدل LLaMA، که در آن زمان در صدر جدول ردهبندی قرار داشت، به طور قابل توجهی پایینتر از اعدادی بود که در مقاله اصلی و منتشر شدهٔ LLaMA گزارش شده بودند.
این تفاوت، سوالاتی را دربارهٔ دقت روشهای ارزیابی و شفافیت نتایج مطرح کرد. تیم هوگینگ فیس با جدیت تصمیم گرفت تا به این «سوراخ خرگوش» (اصطلاحی برای کاوش عمیق در یک مشکل) شیرجه بزند تا دلیل این ناهماهنگی را درک کند و راهی برای حل آن بیابد. این اقدام نشاندهندهٔ تعهد آنها به حفظ اعتماد جامعه و اطمینان از اعتبار دادههای ارائه شده است.
تعهد هوگینگ فیس به شفافیت و راهحلها
هدف اصلی هوگینگ فیس همواره پیشبرد و دموکراتیکسازی هوش مصنوعی از طریق کدباز و علم آزاد بوده است. بروز چنین مشکلاتی، فرصتی را برای بهبود و تقویت زیرساختهای ارزیابی فراهم میآورد. تیم هوگینگ فیس با تعهد کامل به شفافیت و دقت، در حال بررسی ریشهای این مشکل است. این بررسی شامل موارد زیر میشود:
- بازبینی دقیق فرآیندهای ارزیابی MMLU برای مدل LLaMA.
- مقایسه پارامترهای اجرای آزمون در پلتفرم هوگینگ فیس با تنظیمات گزارش شده در مقاله اصلی LLaMA.
- بررسی احتمال وجود تفاوتها در مجموعهدادههای مورد استفاده یا نسخههای مدل.
- توسعه و پیادهسازی مکانیزمهای جدید برای افزایش شفافیت در نحوه اجرای ارزیابیها.
- همکاری با جامعه برای دریافت بازخورد و اطمینان از صحت نتایج در آینده.
حل این مسئله نه تنها اعتبار جدول ردهبندی را افزایش میدهد، بلکه اعتماد جامعه هوش مصنوعی را به ابزارهای ارزیابی مستقل و متنباز تقویت میکند. این رویکرد، در نهایت به نفع کل اکوسیستم هوش مصنوعی خواهد بود و مسیر را برای نوآوریهای آتی هموارتر میسازد.
پرسشهای پرتکرار
مشکل اصلی در جدول ردهبندی هوگینگ فیس چه بود؟
مشکل اصلی ناهماهنگی در امتیازات بنچمارک MMLU برای مدل LLaMA بود؛ جایی که امتیازات در جدول ردهبندی به طور قابل توجهی پایینتر از مقادیر گزارش شده در مقاله اصلی LLaMA بودند.
هوگینگ فیس برای حل این ناهماهنگی چه اقداماتی انجام میدهد؟
هوگینگ فیس متعهد به بررسی عمیق و ریشهای مشکل است. این شامل بازبینی فرآیندهای ارزیابی، مقایسه پارامترهای اجرا، بررسی تفاوتهای احتمالی در دادهها یا نسخههای مدل، و افزایش شفافیت در نحوه اجرای آزمونها برای بازگرداندن اعتماد جامعه است.