
 پژوهش
پیادهسازی RLHF با PPO: بازتولید کد OpenAI و نکات کلیدی
این مقاله به تفصیل جزئیات پیادهسازی یادگیری تقویتی با بازخورد انسانی (RLHF) در چارچوب PPO را بررسی میکند و از بازتولید کدهای OpenAI بهره میگیرد.
 پژوهش
هوش مصنوعی با نظارت بر فرآیند استدلال، ریاضیات را بهتر حل میکند
OpenAI با روش «نظارت بر فرآیند» به جای پاداشدهی به پاسخ نهایی، مدلی آموزش داده که در حل مسائل ریاضی به دقت بیسابقهای رسیده و قابلیت همراستایی با انسان را بهبود میبخشد.
 پژوهش
هوش مصنوعی با StackLLaMA: آموزش عملی دستنشان برای آموزش LLaMA با RLHF
مقالهی StackLLaMA را برای آموزش LLaMA با RLHF دستهبندی میکند؛ مراحل ساده، چالشها، و راهحلهای عملی، نمونهای برای ارتقاء و دموکراتیزهسازی AI.
 پژوهش
هوش مصنوعی: آموزش فاینتیونینگ 20B مدل با RLHF روی کارت گرافیک 24GB
در این مقاله، به بررسی آموزش فاینتیونینگ 20B مدل زبانی با یادگیری تقویتی (RLHF) روی کارت گرافیک 24GB پرداختهایم و نکات کلیدی را در راهحلهای متنباز پوشش میدهیم.
 پژوهش
هوش مصنوعی در رقابت: معرفی AI vs. AI بر روی Hugging Face
AI vs. AI یک پلتفورم متنباز است که رقابتهای هوش مصنوعی چند عامل را در فضای هنجفای هفش میزبانی میکند. مدلها بر اساس عملکرد در مسابقات رتبهبندی میشوند.
 پژوهش
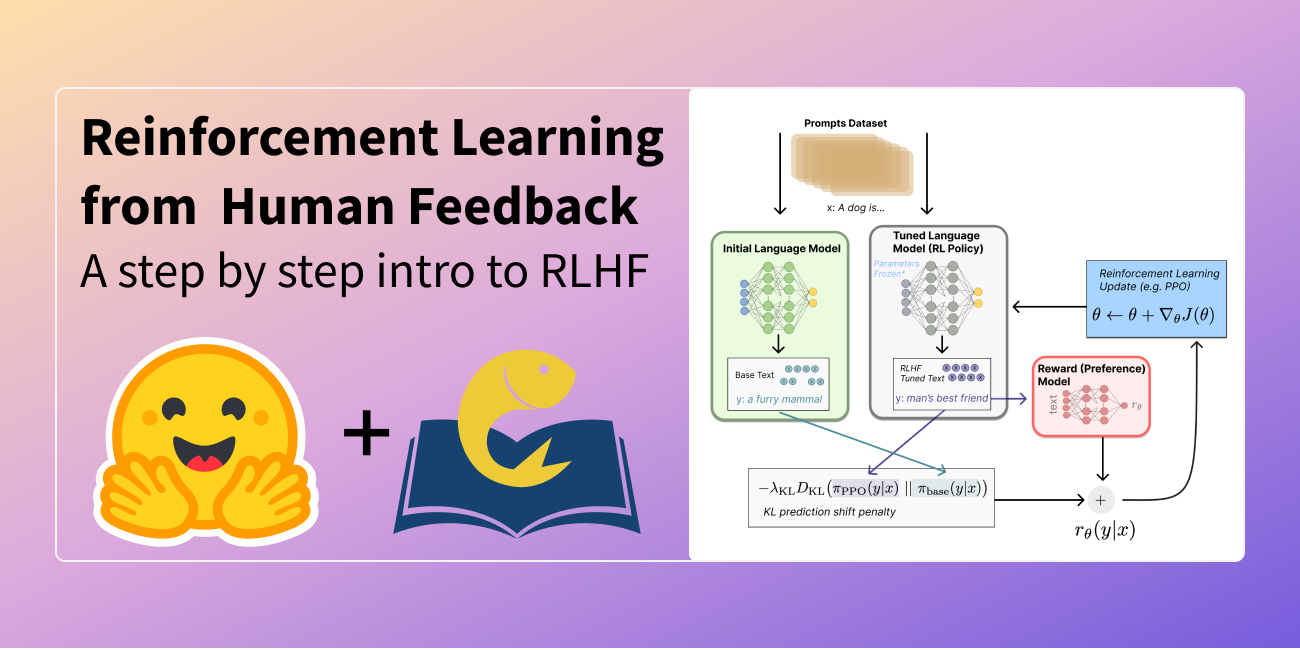
هوش مصنوعی با یادگیری تقویتی از بازخورد انسانی: رویکرد جدید شکافزن
مقالهای در شبکه هوش مصنوعی ارائه میدهد که چگونگی ترکیب یادگیری تقویتی با بازخورد انسانی برای بهبود مدلهای زبانی و افزایش شفافیت را نشان میدهد.
 پژوهش
هوش مصنوعی: محدودیت های شناسایی بیش از حد مدل پاداش در آموزش RLHF
قانون مقیاس در هوش مصنوعی نشان میدهد که بیشینهسازی مدلهای پاداش میتواند کارایی را کاهش دهد. این مقاله به بررسی چالشها و راهکارهای کاهش این ناهماهنگی میپردازد.
 مدلها
مقدمه عملی: آموزش مبتنی بر Transformer برای تصمیمگیری در هوش مصنوعی
در این مطلب بهصورت گام به گام با نحوهٔ آموزش اولین مدل Decision Transformer در محیط گوگل کولاب آشنا میشویم و چگونگی استفاده از آن در مسائل تصمیمگیری را بررسی میکنیم.
 پژوهش
هوش مصنوعی: راهنمای عملی Proximal Policy Optimization (PPO) در یادگیری تقویتی
دستورات کامل Proximal Policy Optimization (PPO) را معرفی میکنیم، مزایای آن در یادگیری تقویتی، و نحوه پیادهسازی توسط Hugging Face و منابع متنباز.
 پژوهش
هوش مصنوعی در عمل: Advantage Actor Critic (A2C) و کاربردهایش
مزیت A2C در هوش مصنوعی: یادگیری تقویتی با کاهش واریانس، بهبود عملکرد رباتیک در PyBullet، آموزش عملی، بهینهسازی مدل و کاهش هزینه اجرا و بازدهی بیشتر.