
 اخبار
هوش مصنوعی در شتاب TGI بر روی Intel Gaudi: راهنمای جامع
TGI (Text Generation Inference) با یکپارچگی نوین در پردازندههای Intel Gaudi، سرعت و کارایی مدلهای بزرگ زبان را به طور چشمگیری بهبود میبخشد و اجرای مدلهای LLM را در زمان کمتری ممکن میسازد؛ راهنمای جامع برای پیادهسازی و بهرهبرداری.
 پژوهش
معیار عملکرد مدل زبان در پردازندههای نسل پنجم زئون در GCP
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 سختافزار
AMD EPYC نسل پنجم: دو برابر سرعت LLM و شتاب AI با Zen5
AMD نسل پنجم EPYC را به بازار معرفی کرد؛ با معماری Zen5 و حداکثر 192 هسته، سرعت اجرای مدلهای زبانی دو برابر میشود و شتاب AI در سرورها افزایش مییابد.
 اخبار
پشتیبانی سریعتر Assisted Generation بر روی Intel Gaudi در هوش مصنوعی
شرکت Intel و هابانا پردازنده Gaudi را برای سرعتپردازی Assisted Generation طراحی کرده و هزینه و مصرف انرژی را بهطور چشمگیری کاهش میدهد.
 اخبار
هوش مصنوعی در سرورهای AMD Instinct MI300: یک گام بزرگ از سوی Hugging Face
Hugging Face با همکاری AMD از پردازندههای گرافیکی Instinct MI300 برای اجرای مدلهای هوش مصنوعی بهره میبرد. بدون تغییر کد، در محیطهای محلی یا سرورهای ابری مانند Azure ND MI300x V5 کاملاً عملیاتی است.
 پژوهش
هوش مصنوعی بر روی سرورهای Xeon: SetFit با سرعتشده توسط Intel
SetFit با بهرهگیری از Optimum Intel بر روی پردازندههای Xeon با سرعت بیسابقهای به قضاوتهای چند-خطی دست مییابد؛ مقاله این راهحل و روند بهینهسازی را بررسی میکند.
 سختافزار
اجرای هوش مصنوعی مولد روی لپتاپ: چتبات Phi-2 با پردازنده متئور لیک اینتل
هاگینگ فیس و اینتل اجرای مدل هوش مصنوعی Phi-2 را روی لپتاپهای مجهز به پردازنده متئور لیک ممکن کردهاند؛ گامی برای استنتاج محلی مدلهای زبانی بزرگ.
 مدلها
بهینهسازی مدلهای جاسازی هوش مصنوعی روی CPU با Optimum Intel و fastRAG
روش جدید بهینهسازی مدلهای جاسازی (Embedding) با ابزار Optimum Intel و fastRAG برای اجرای سریع و کمهزینه روی پردازنده مرکزی، بدون افت کیفیت.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 پژوهش
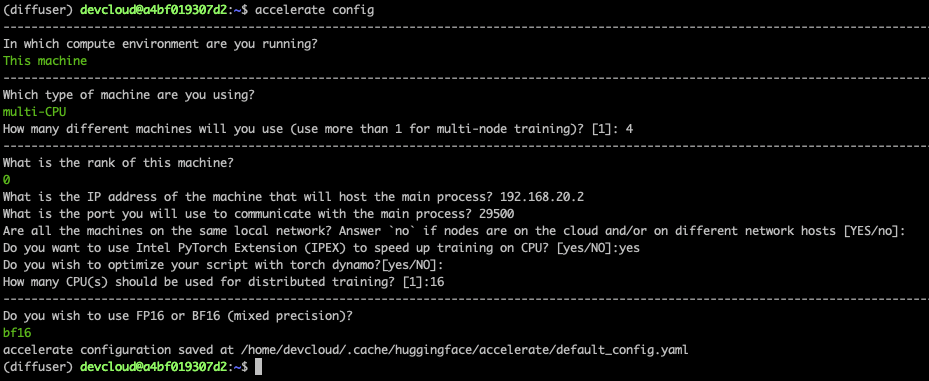
فاین‑تینینگ Stable Diffusion بر روی پردازندههای اینتل: انقلاب هوش مصنوعی
فاین‑تینینگ Stable Diffusion بر روی پردازندههای اینتل با فناوری AMX امکانپذیر شد؛ تولید تصاویر واقعی در کسبوکار را سریعتر بسیار هم میکند.