
 پژوهش
کِمینا‑پروور: هوش مصنوعی «Test‑Time RL» در جستجوی اثباتهای رسمی
مدل برجستهی کِمینا‑پروور با استفاده از جستجوی RL در زمان آزمون، پیشرویهای جدیدی در حل مسئلهی خودکار ریاضیات و منطق معرفی میکند. مزایا، روش و کاربردهای آن را بخوانید.
 مدلها
هوشمصنوعی در ابری: ادغام Microsoft و Hugging Face برای دسترسی آسان مدلهای متن، صدا و تصویر
Microsoft و Hugging Face همکاری خود را گسترش دادهاند تا بهسرعت و بهصورت امن مدلهای متن، صدا و تصویر را بر روی پلتفرم Azure پایدارآزمایی کند. در این همکاری 10,000+ مدل باز در دسترس قرار میگیرد.
 پژوهش
OpenAI نخبگان غیرانتفاعی را معرفی میکند: چهار مستشار جدید در خدمت هوش مصنوعی
OpenAI به تازگی چهار مستشار کانونی غیرانتفاعی جدید را معرفی کرد که نقش مهمی در برنامههای خیریه و توسعهی هوش مصنوعی برای منافع عمومی ایفا خواهند کرد.
 پژوهش
نقشههای هوشمندتر با GPT‑4o: بهینهسازی چشمپوشی در تعبیه دادهها
OpenAI با مدل GPT‑4o Vision و تنظیم دقیق، نقش چشمپوشی تفصیلی در نقشهسازی را بازتعریف کرده و امکان ایجاد نقشههای هوشمند، دقیق و فهمپذیرتر را فراهم میکند.
 اخبار
هوش مصنوعی در سرورهای AMD Instinct MI300: یک گام بزرگ از سوی Hugging Face
Hugging Face با همکاری AMD از پردازندههای گرافیکی Instinct MI300 برای اجرای مدلهای هوش مصنوعی بهره میبرد. بدون تغییر کد، در محیطهای محلی یا سرورهای ابری مانند Azure ND MI300x V5 کاملاً عملیاتی است.
 پژوهش
PatchTSMixer: مدل سبک زمانبندی در هوش مصنوعی با MLP‑Mixer
PatchTSMixer مدل زمانسنجی سبک، مبتنی بر MLP‑Mixer، توسط IBM Research و Hugging Face عرضه شد؛ امکان پیشبینی یکسویه سریع در دیتاستهای برق و صنعت.
 پژوهش
کشف مزایا و معایب کوانتیزهسازی مدلهای هوش مصنوعی در Transformers
متن به بررسی مزایا و معایب دو روش کوانتیزهسازی، BitsAndBytes و AutoGPTQ، در کتابخانه Transformers میپردازد و راهنمایی برای انتخاب مناسب ارائه میدهد.
 پژوهش
هوشمصنوعی و پردازش سریع: ۵۰٪ کاهش تاخیر با SageMaker و Hugging Face
Fetch با ترکیب Amazon SageMaker و Hugging Face توانست تاخیر پردازش یادگیری ماشین خود را ۵۰٪ کاهش دهد و دقت اسکن رسیدها را به طور چشمگیری بالا ببرد.
 سیاست و قانون
قانون هوش مصنوعی اتحادیه اروپا: مسیر منبع باز به سوی شفافیت
قانون هوش مصنوعی اتحادیه اروپا با تأکید بر توسعهٔ باز، فراتر از محدودیتهای فنی، راهکارهای شفافیت، مسئولیت و دسترسی به دادهها را معرفی میکند.
 سختافزار
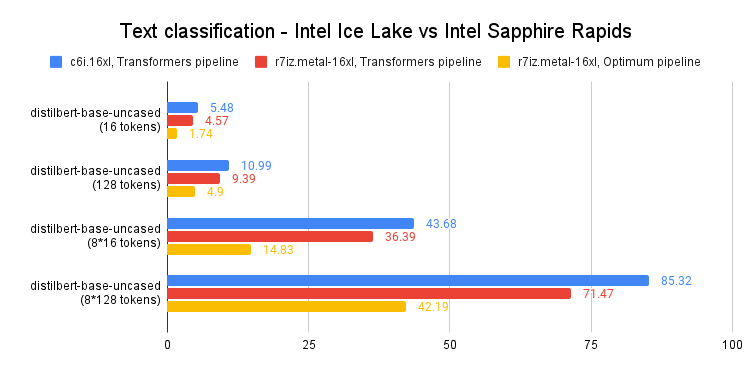
سرعت inference PyTorch با پردازندهٔ Intel Sapphire Rapids برتر
در این مقاله، سرعت inference مدلهای NLP بر پایه PyTorch را در سرورهای Intel Sapphire Rapids و Ice Lake میسنجیم و نکات عملی برای بهرهبرداری را بررسی میکنیم.