
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 محصولات
هوش مصنوعی: Optimum‑NVIDIA بر روی پردازندههای NVIDIA عملکرد 28× سریعتر ارائه میدهد
Optimum‑NVIDIA، کتابخانهای ساده از هاب هگینگ فیس، عملکرد مدلهای زبان بزرگ را روی GPUهای NVIDIA تا 28 برابر سرعت میدهد و از فرمت FP8 بهره میبرد.
 سختافزار
هوش مصنوعی: سرعت جاندادانهای برای Llama 2 روی AWS Inferentia2
AWS Inferentia2 با همکاری Hugging Face و optimum‑neuron، Llama 2 را برای تولید متن به سرعتی بیسابقه بر روی سرورها میشکند. در این مقاله نقشه راه و نتایج آزمایشات را بررسی میکنیم.
 مدلها
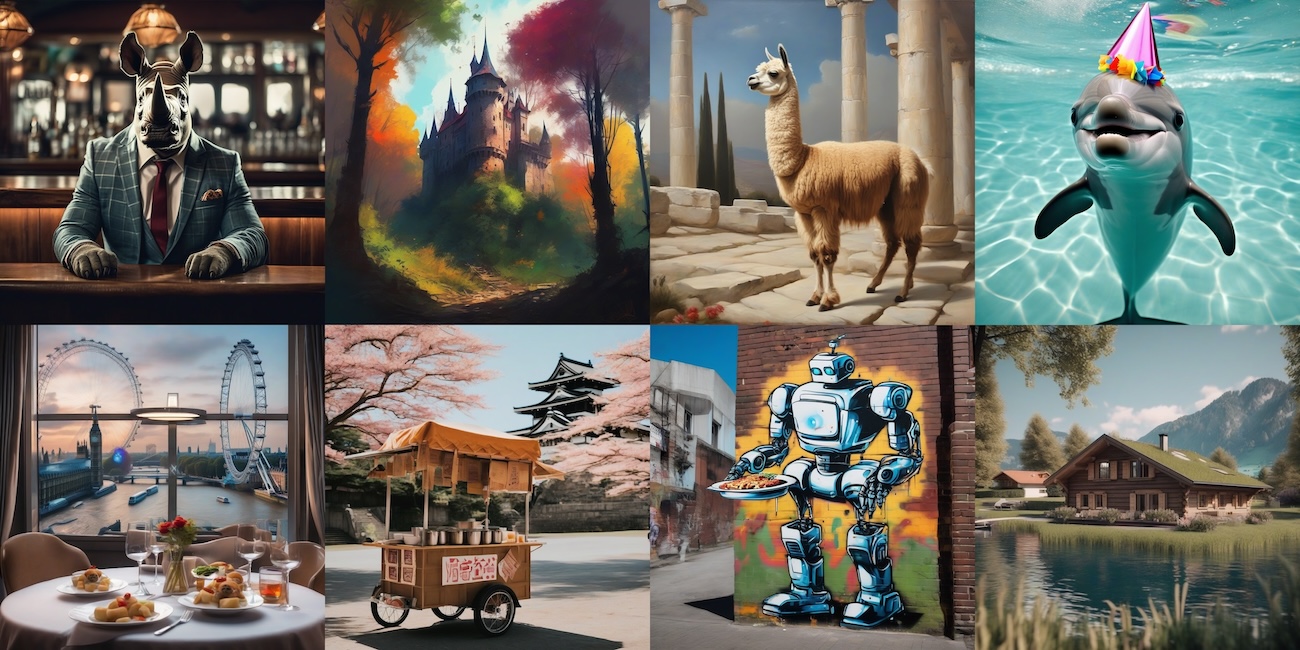
پیشرفت هوش مصنوعی: تلاش برای بهینهسازی ساده SDXL جهت سرعت و حافظه
یادآورترین نکات بهینهسازی ساده SDXL، مدل پیشرفته تولید تصویر هوش مصنوعی، با تأکید بر سرعت، حافظه و کارایی در مقالهٔ تازه ما.
 پژوهش
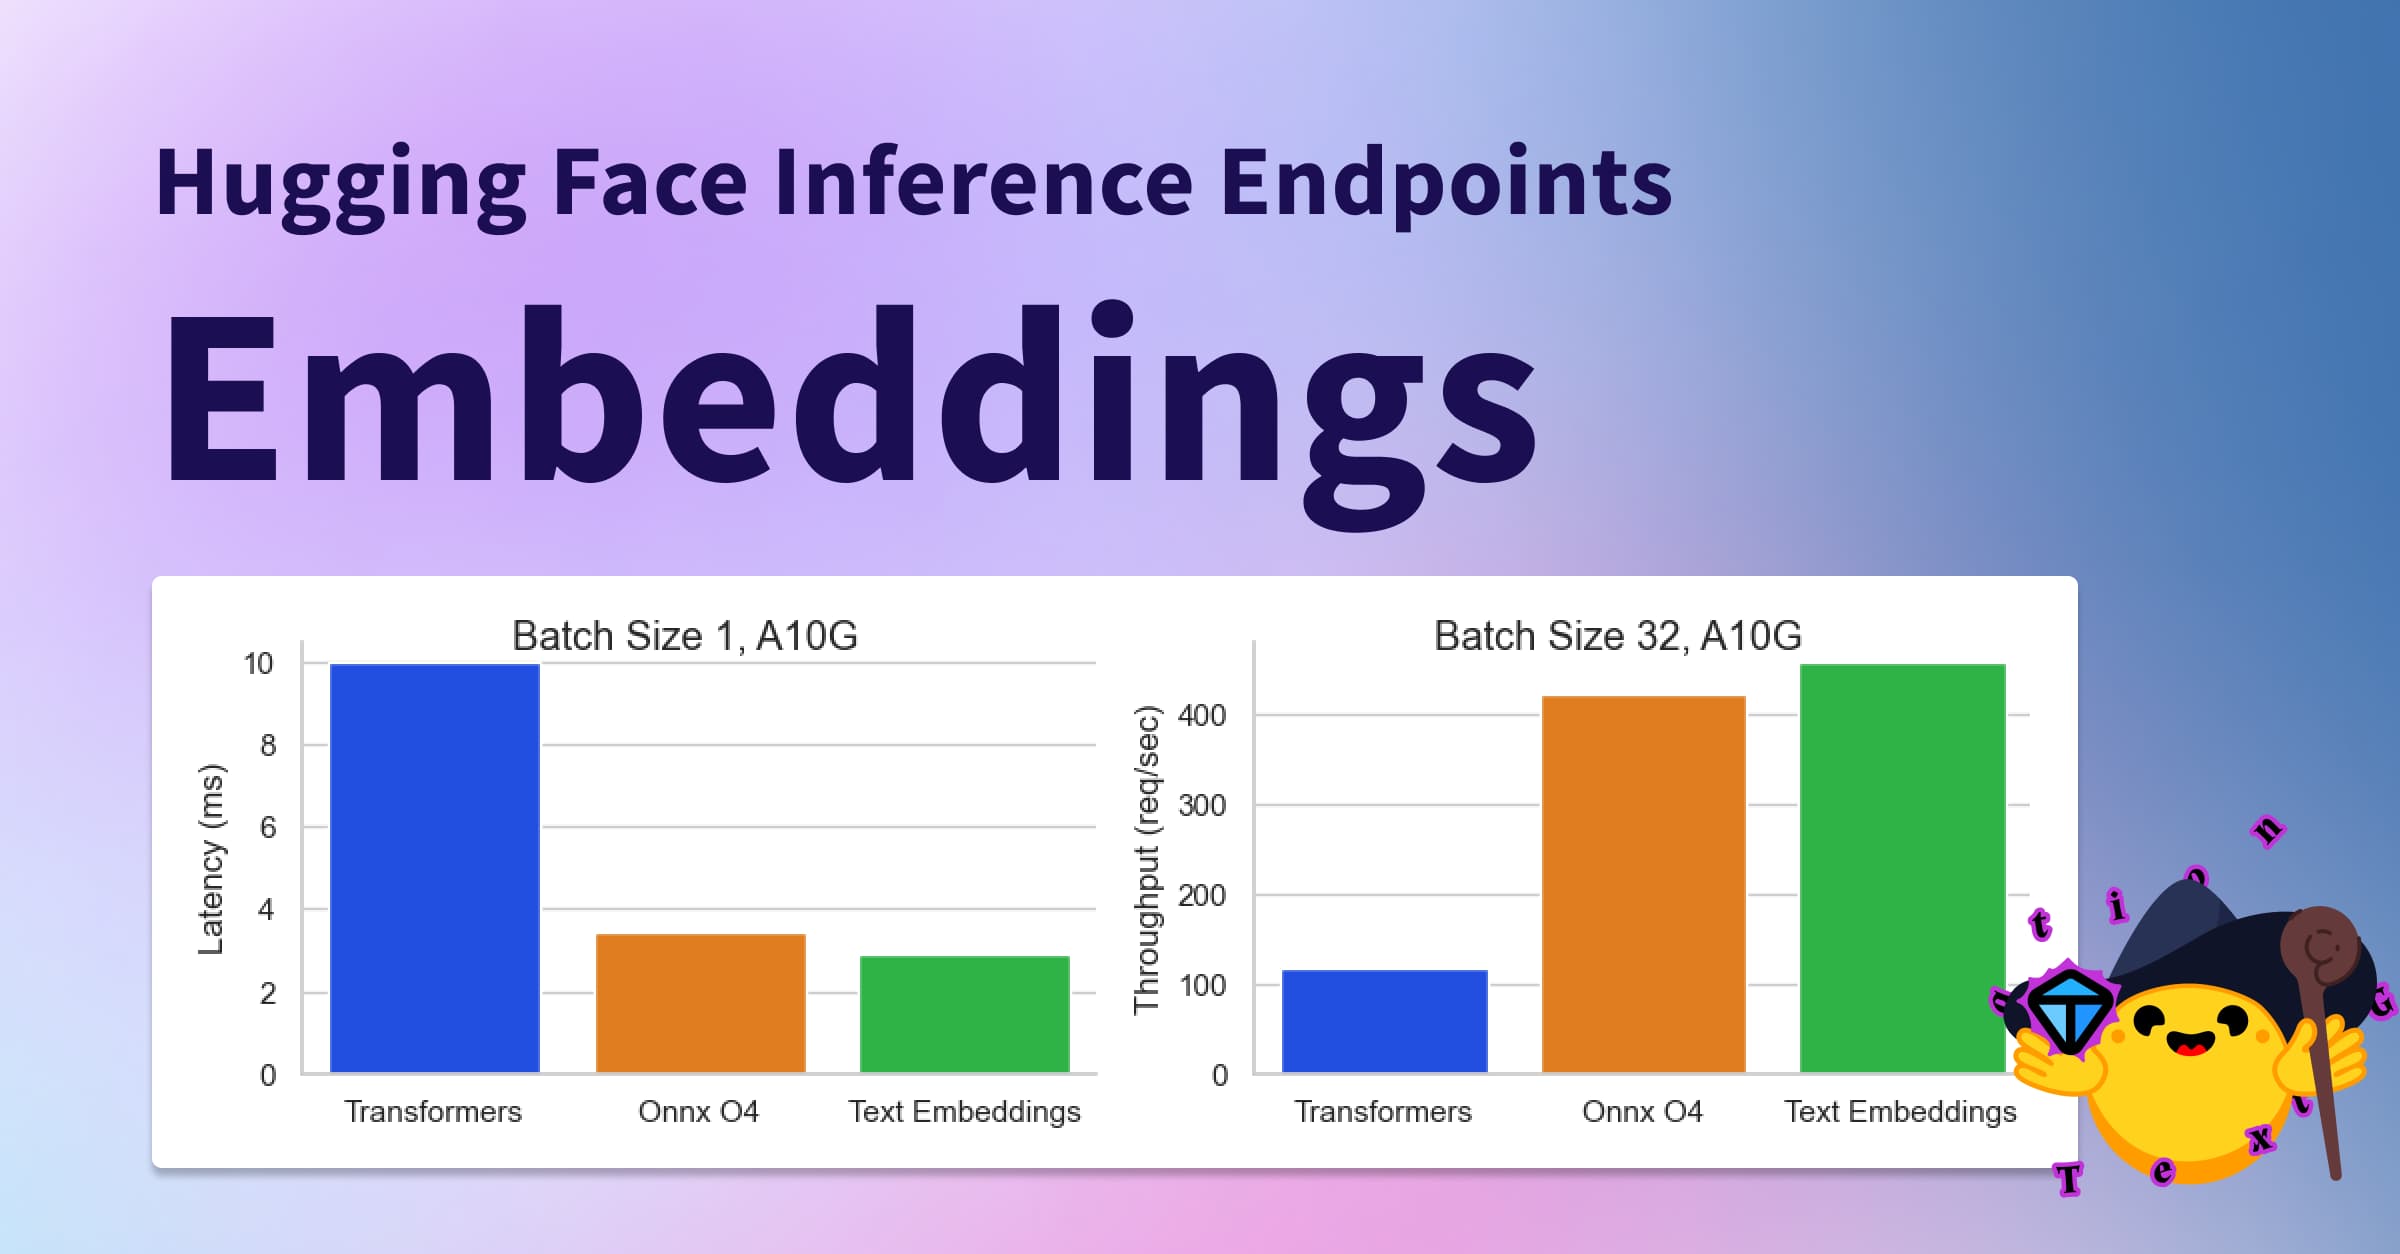
هوش مصنوعی در خدمت دنیای دادهها: انتشار مدلهای ایمبدینگ در Hugging Face
پست جدید هوش مصنوعی در Hugging Face با توضیح گام به گام جهت استقرار مدلهای ایمبدینگ، سرعت پردازش بالاتر و استفاده در تجزیه و تحلیل دادههای متنی و تصویری با مقایسه عملکرد و نکات عملکردی.
 محصولات
Gradio Lite: اجرای بدون سرور در مرورگر با هوش مصنوعی—راهحلی سریع برای توسعه مدلها
Gradio Lite با استفاده از Pyodide به شما امکان میدهد نرمافزارهای هوش مصنوعی Gradio را بهصورت کاملاً سرورسور (Serverless) در مرورگر اجرا کنید. این تکنولوژی سرعت، حریمخصوصی و سهولت انتشار را بهبود میبخشد۔
 پژوهش
همینگ فیس و ONNX Runtime: ۱۳۰,۰۰۰ مدل هوش مصنوعی را دو برنده میکنیم
در این مقاله به بررسی راهکار ONNX Runtime میپردازیم که از طریق آن میتوان بیش از ۱۳۰،۰۰۰ مدلّی Hugging Face را بهینهسازی و سرعت بخشی کرد. این نوآوری، گام مهمی در ارائهٔ دسترسی به هوش مصنوعی در سطح جهان است.
 سختافزار
هوش مصنوعی بر روی Cloud TPU v5e: سرعتبخشی SDXL با JAX
کشف روش جدیدی برای پردازش مدل Stable Diffusion XL با بهرهگیری از JAX بر روی Google Cloud TPU v5e؛ بهبود کارایی، کاهش هزینه و افزایش سرعت تولید تصویر عالی در شرایط واقعی.
 پژوهش
استقرار Llama 2 بر Amazon SageMaker: راهنمایی هوش مصنوعی کم هزینه
این مقاله، بیانگر نتایج یک بنچمارک جامع بر روی Llama 2 در Amazon SageMaker است و بهترین گزینههای کم هزینه و بالاترین سرعت را برای شرکتها معرفی میکند.
 پژوهش
هوش مصنوعی در عمل: روشهای بهینهسازی مدلهای زبان بزرگ
با بهرهگیری از تکنیکهای Flash Attention، حافظهی مبتنی بر کلید-مقدار و بهبود جاسازهای موقعیتی، مدلهای زبان بزرگ را میتوان در محیطهای تولیدی بهینهتر استفاده کرد.