
 پژوهش
آژانگهای هوش مصنوعی را با JavaScript در Hugging Face به کار ببرید
نسخه جدید کتابخانه Agents.js را معرفی میکنیم؛ راهی نوین برای کنترل مدلهای زبانی بزرگ با استفاده از JavaScript و دسترسی به ابزارهای متنوع، چه در مرورگر و چه در سرور. مبحثی جذاب برای توسعهدهندگان و پژوهشگران هوش مصنوعی.
 پژوهش
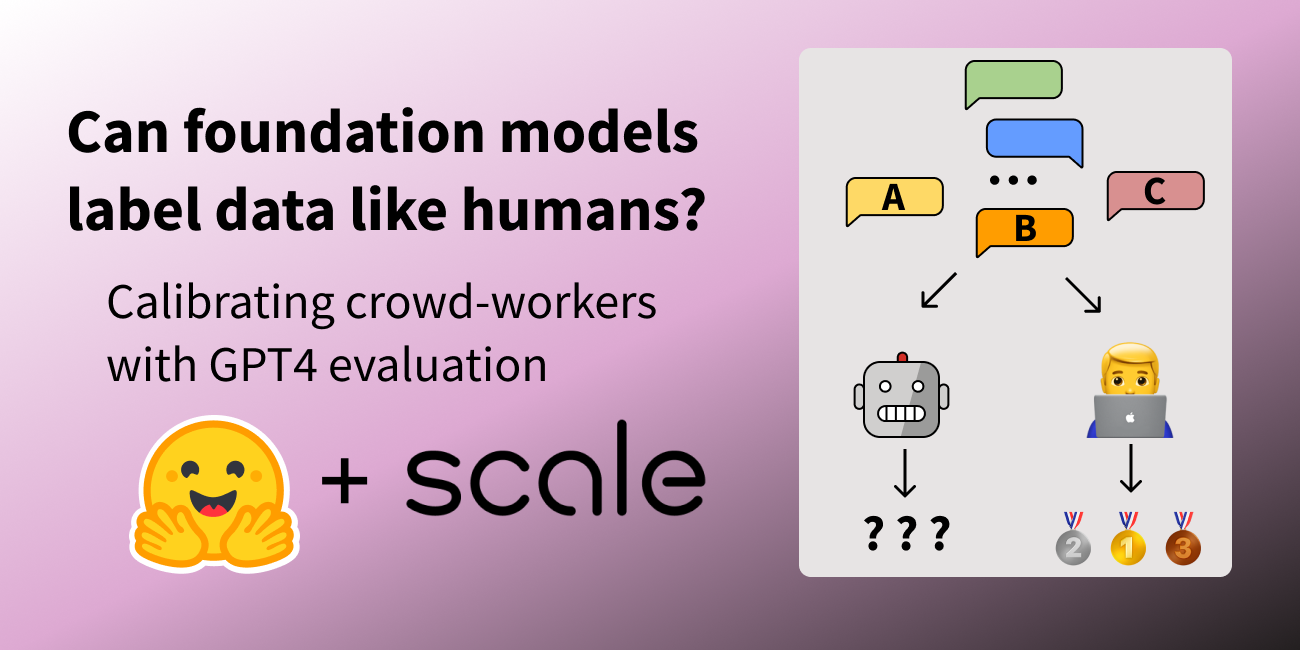
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 محصولات
کانتینر جدید Hugging Face برای استقرار مدلهای هوش مصنوعی در SageMaker
هانگینگ فیس کانتینر استنتاج جدیدی برای استقرار مدلهای زبانی بزرگ در Amazon SageMaker معرفی کرد. این راهکار بر پایه Text Generation Inference عملکردی بهینه و امن ارائه میدهد.
 مدلها
کوانتیزاسیون ۴-بیتی و QLoRA؛ گامی بلند در دسترسپذیری هوش مصنوعی
با همکاری Hugging Face و کتابخانه bitsandbytes، مدلهای زبانی بزرگ اکنون با دقت ۴-بیتی روی سختافزار معمولی اجرا شده و امکان آموزش تطبیقگرها با QLoRA فراهم شده است.
 اخبار
حسابرسی امنیتی safetensors تأیید شد؛ فرمت پیشفرض ذخیره مدلهای هوش مصنوعی
حسابرسی امنیتی Trail of Bits امنیت کتابخانه safetensors را تأیید کرد و سه شرکت پیشرو، این فرمت را به استاندارد پیشفرض ذخیره مدلهای هوش مصنوعی تبدیل میکنند.
 مدلها
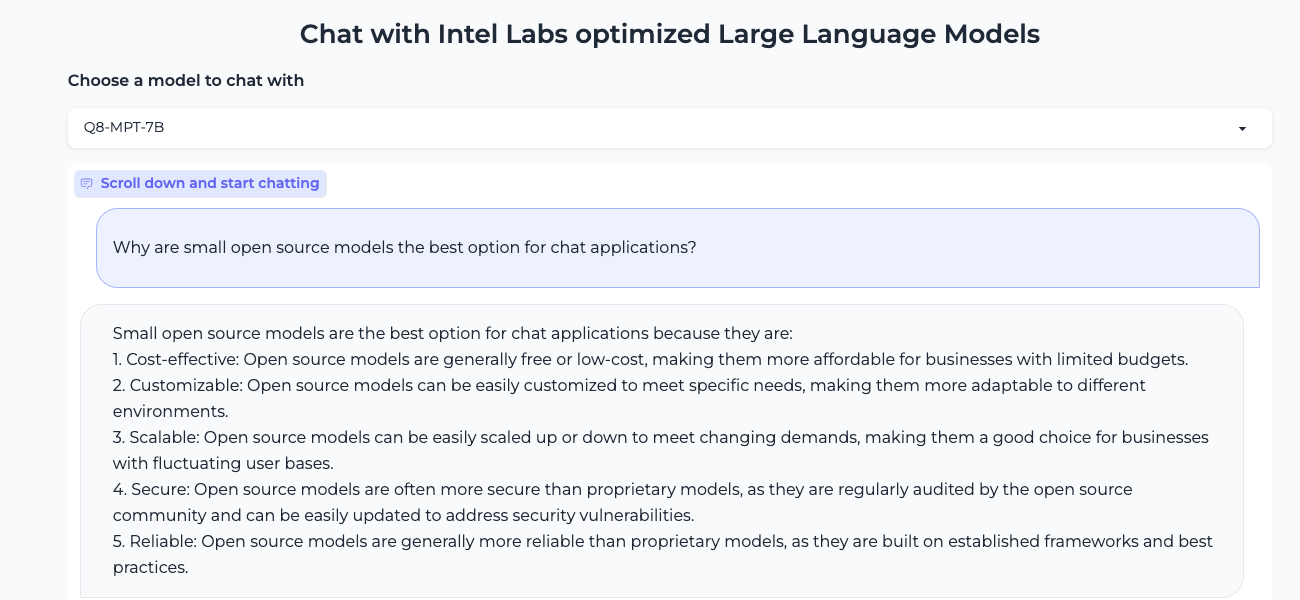
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.
 پژوهش
حذف دادههای تکراری در مقیاس بزرگ؛ راز آموزش هوش مصنوعی باکیفیت
پروژه BigCode با روشهای پیشرفته deduplication، دادههای تکراری را در مقیاس بزرگ حذف میکند تا مدلهای زبانی با کیفیت و امنیت بالاتری آموزش ببینند.
 مدلها
معماری RWKV؛ ترکیب هوش مصنوعی بازگشتی با توانمندی ترنسفورمر
معماری RWKV با ادغام شبکههای بازگشتی (RNN) و ترنسفورمر، راهکاری نوین و کارآمد برای مدلهای زبانی بزرگ ارائه میدهد. در این مقاله به بررسی ویژگیها، کاربردها و آینده آن میپردازیم.
 پژوهش
هوش مصنوعی و تولید متن کمتأخیر: روش Assisted Generation تا ۱۰ برابر سریعتر
با Assisted Generation در هوش مصنوعی، تأخیر تولید متن در مدلهای زبانی بزرگ تا ۱۰ برابر کاهش مییابد؛ بدون افت کیفیت، برای پاسخگویی بلادرنگ.
 پژوهش
هوش مصنوعی زبان مدلها را توضیح میدهد؛ گامی به سوی شفافیت
OpenAI با کمک GPT-4 توضیحاتی خودکار برای رفتار نورونهای مدلهای زبانی بزرگ نوشته و دادههای کامل نورونهای GPT-2 را منتشر کرد.