
 پژوهش
هوش مصنوعی در آزمایش خود: CriticGPT به کمک GPT-4 خطاهای ChatGPT را مییابد
مدل CriticGPT، بر پایه GPT‑4، بهصورت خودکار پاسخهای ChatGPT را تجزیه و تحلیل میکند تا در فرایند RLHF، مربیان را در شناسایی خطاها یاری رساند. نقش مهم در کیفیت تولید محتوا دارد.
 پژوهش
پیادهسازی RLHF با PPO: بازتولید کد OpenAI و نکات کلیدی
این مقاله به تفصیل جزئیات پیادهسازی یادگیری تقویتی با بازخورد انسانی (RLHF) در چارچوب PPO را بررسی میکند و از بازتولید کدهای OpenAI بهره میگیرد.
 سیاست و قانون
هوش مصنوعی GPT‑4: سرعتبخشی و انسجام در نظارت بر محتوا حساس
OpenAI با بهرهگیری از GPT‑4، فرآیندهای تدوین سیاستهای محتوا و تصمیمگیری در نظارت بر آن را بهبود داده؛ این امکان را بهوجود میآورد که برچسبگذاری یکنواخت، بازخورد سریعتر و کاهش نیاز به بازبینی انسانی حاصل شود.
 پژوهش
هوش مصنوعی در لامّا ۲: آموزش مستقیم با DPO و سادهسازی RLHF
در این مقاله، نحوهی آموزش مستقیم لامّا ۲ با روش DPO در Hugging Face بررسی میشود؛ سادهسازی یادگیری بازخورد انسانی و مزایای آن توضیح داده میشود.
 اخبار
Yabble، ابزار هوش مصنوعی برای تحلیل دقیق بازخورد مشتری با GPT‑3
Yabble، نسخه GPT‑3 از OpenAI، برای استخراج سریع و دقیق بازخورد مشتریان طراحی شده؛ شرکتها میتوانند بازخوردها را تحلیل و استراتژیهای بازاریابی را بهبود بخشند.
 پژوهش
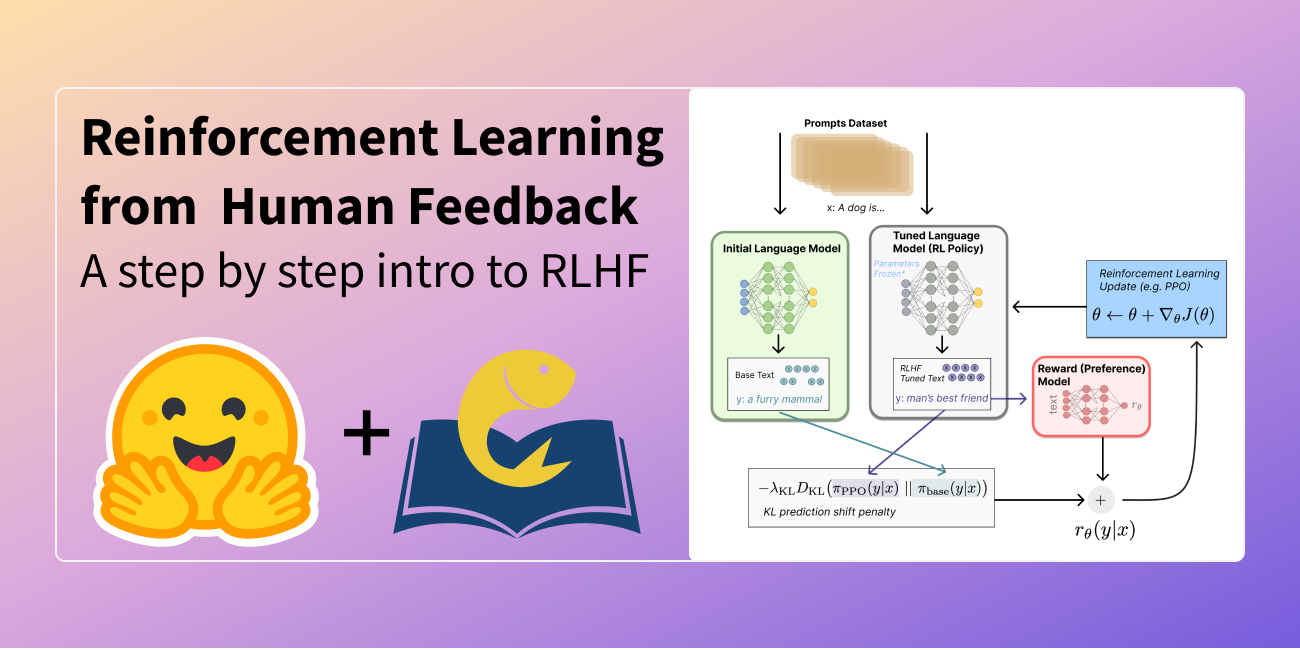
هوش مصنوعی با یادگیری تقویتی از بازخورد انسانی: رویکرد جدید شکافزن
مقالهای در شبکه هوش مصنوعی ارائه میدهد که چگونگی ترکیب یادگیری تقویتی با بازخورد انسانی برای بهبود مدلهای زبانی و افزایش شفافیت را نشان میدهد.
 پژوهش
هوش مصنوعی هوشمند؛ شیوه OpenAI برای همسانسازی سیستمهای یادگیرنده
OpenAI با تمرکز بر یادگیری از بازخورد انسان، در مسیر همسانسازی سیستمهای هوش مصنوعی قدم میگذارد؛ هدف وسیعتری در پی حل مشکلات همسانسازی است.
 پژوهش
خلاصهسازی کتابها با هوش مصنوعی: بازخورد انسانی و نگاهی به آینده
هوش مصنوعی OpenAI با کمک بازخورد انسانی، کتابها را خلاصه میکند؛ عمیقترین بهرهبرداری از نظارت انسان بر سیستمهای پیچیده، અસર اورچیکمولت را پیش‑بینی میکند.
 پژوهش
آموزش مدلهای هوش مصنوعی برای خلاصهسازی بهتر با بازخورد انسانی
OpenAI با استفاده از یادگیری تقویتی از بازخورد انسانی، مدلهای زبانی را برای خلاصهسازی دقیقتر و باکیفیتتر آموزش داده است. این روش نتایج بهتری دارد.
 مدلها
تنظیم دقیق GPT-2 از ترجیحات انسانی
ما مدل زبانی GPT-2 با پارامتر ۷۷۴ میلیون را با استفاده از بازخورد انسانی برای وظایف مختلف تنظیم دقیق کردهایم و با موفقیت ترجیحات برچسبگذارهای انسانی خارجی ر