
 پژوهش
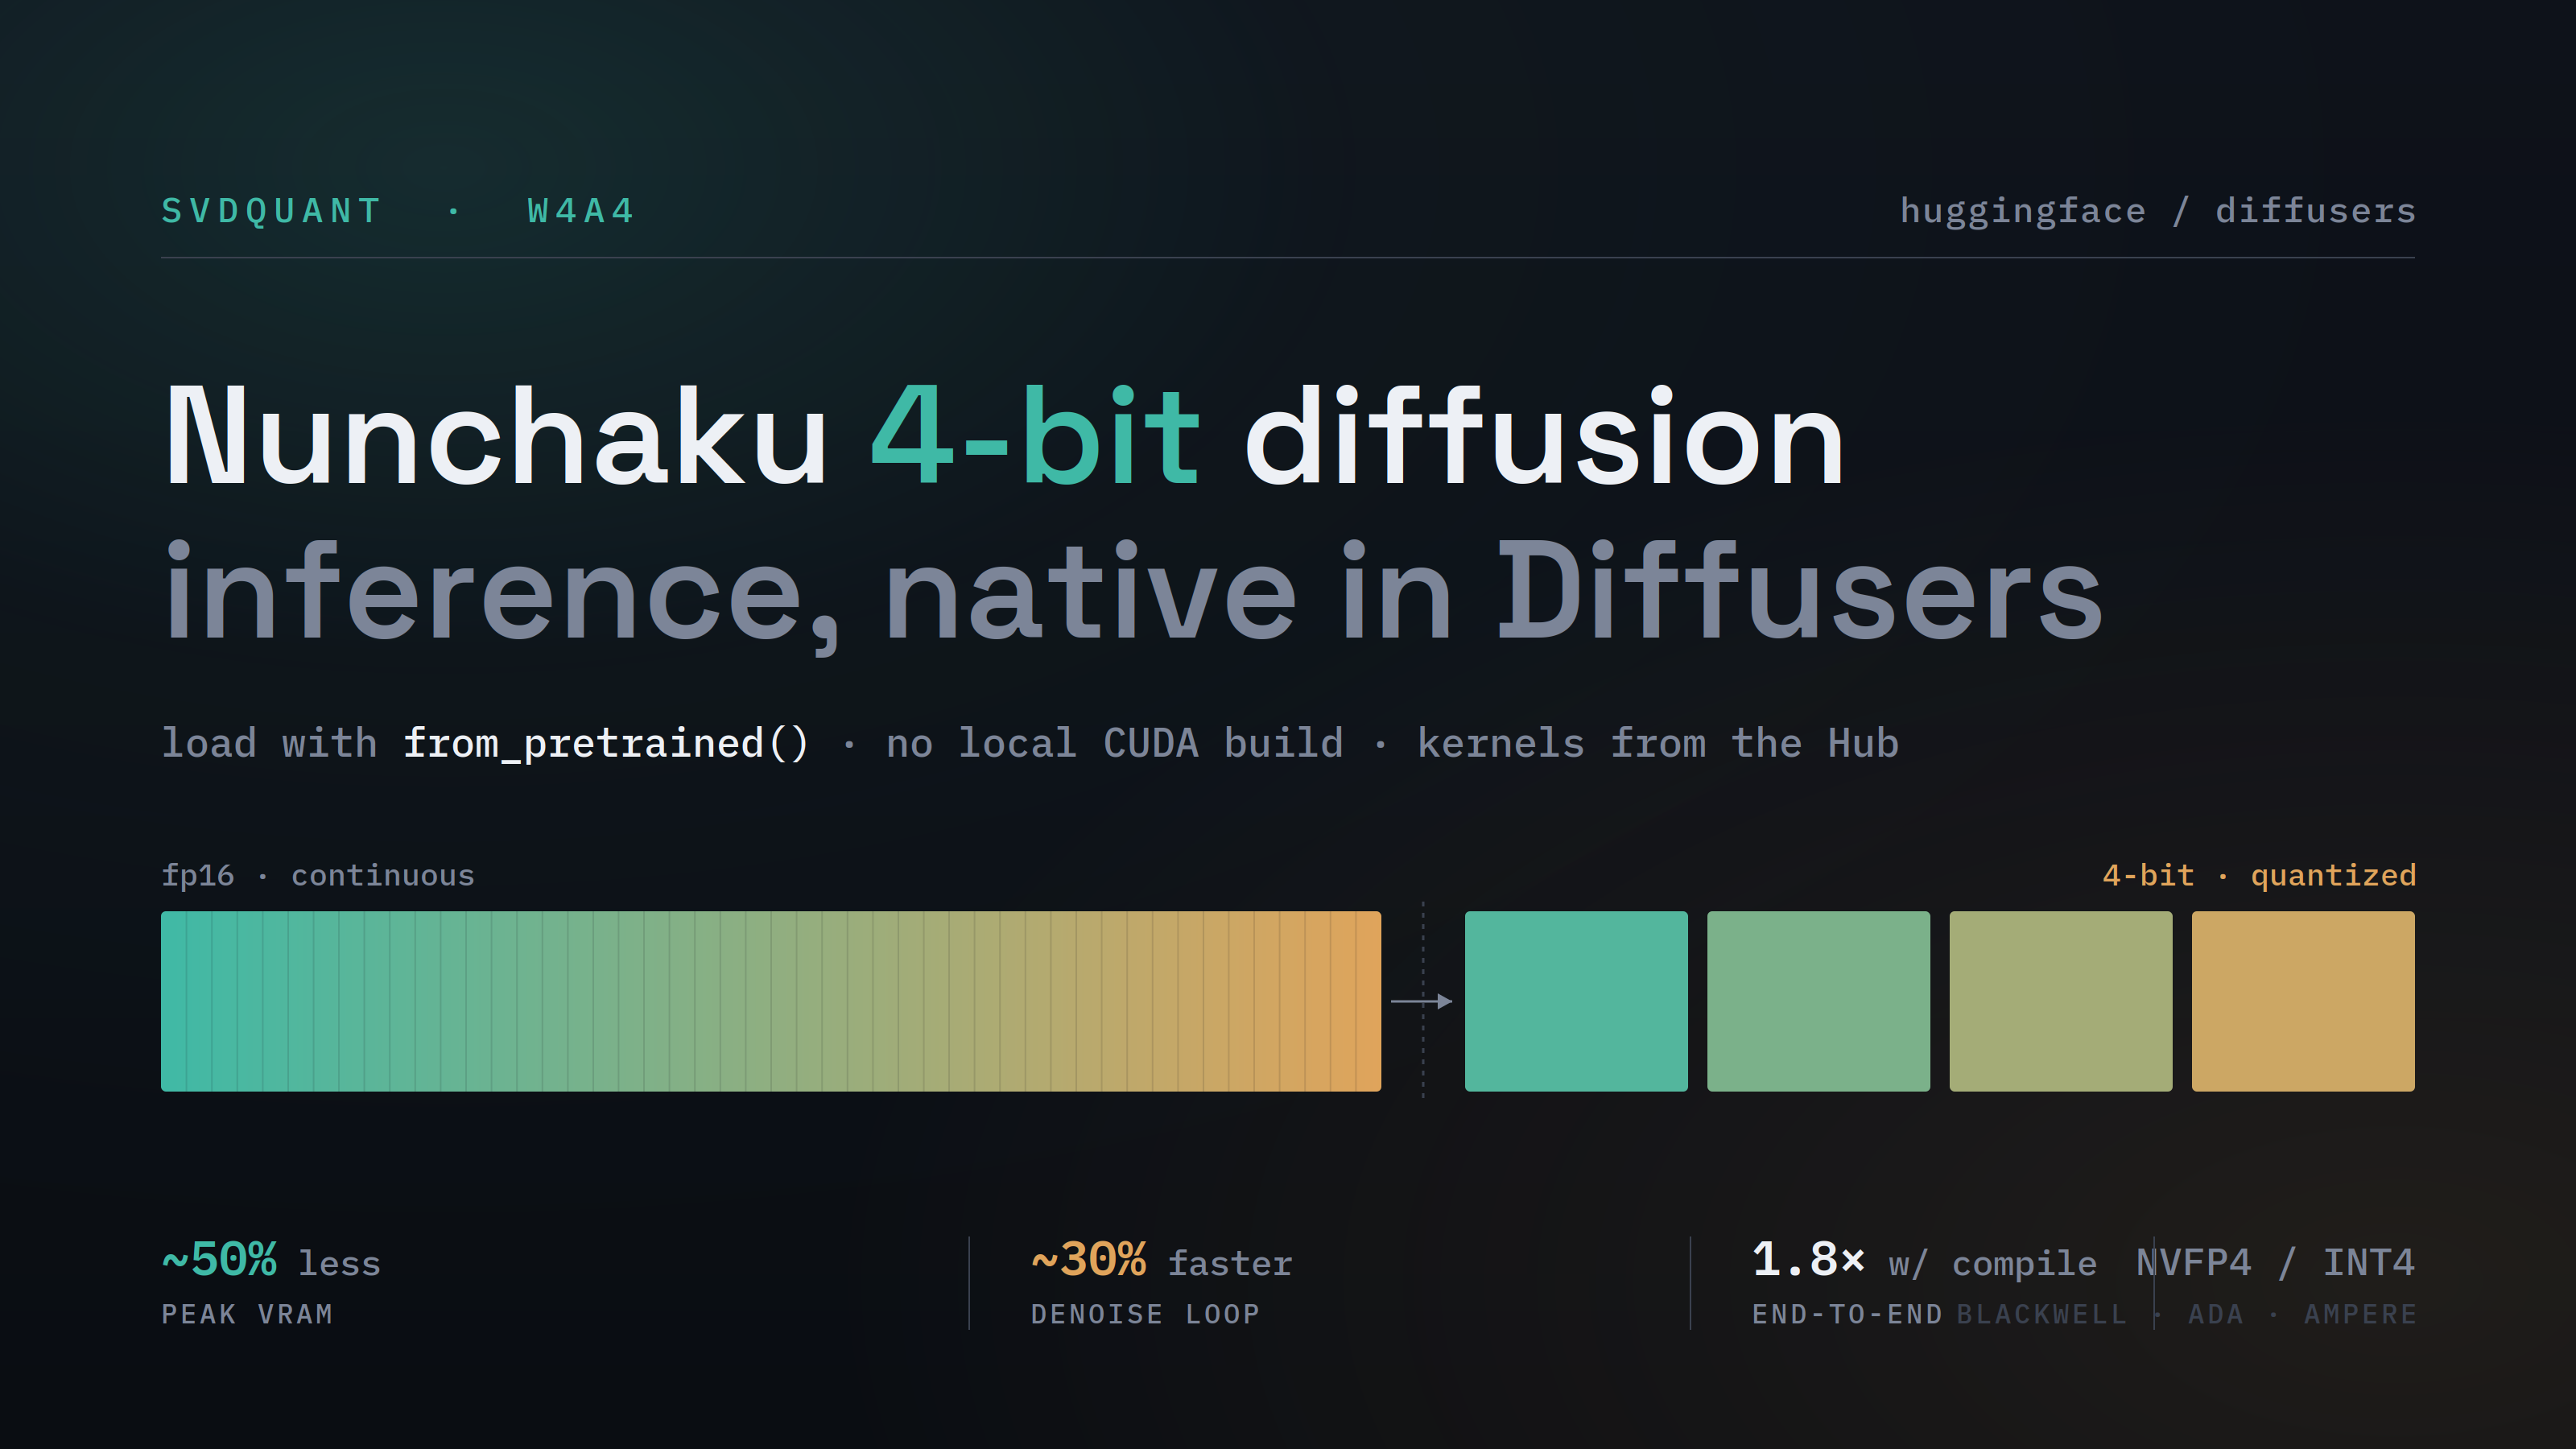
آوردن استنتاج انتشار ۴ بیتی نانچاکو به پخشکنندهها
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 اخبار
سرعت بومی vLLM با کتابخانه Transformers در اکوسیستم هوش مصنوعی
Hugging Face اعلام کرد بکاند transformers در vLLM به سرعت بومی یا حتی بالاتر از پیادهسازیهای اختصاصی رسیده و توسعهدهندگان مدلهای زبانی میتوانند بدون هزینه اضافه، استنتاج فوقسریع داشته باشند.
 اخبار
اوپنایآی و برادکام چیپ اختصاصی «هالاپینو» را برای هوش مصنوعی معرفی کردند
اوپنایآی و برادکام تراشهٔ اختصاصی Jalapeño را برای اجرای مدلهای بزرگ زبانی رونمایی کردند. این چیپ عملکرد، بازده انرژی و مقیاسپذیری سیستمهای هوش مصنوعی را بهطور چشمگیری بهبود میبخشد.
 مدلها
Falcon Perception: مدل سبک هوش مصنوعی برای درک صحنه و زبان طبیعی
معرفی Falcon Perception؛ ترنسفورمر ۰.۶ میلیارد پارامتری با معماری early fusion برای بخشبندی و گراندینگ متنی. نتایج برجسته، استنتاج سریع و متنباز.
 مدلها
معرفی Differential Transformer V2؛ گامی نوین در کارایی و پایداری هوش مصنوعی
مایکروسافت نسخه دوم ترنسفورمر دیفرانسیلی را معرفی کرد؛ بهبود کارایی استنتاج، پایداری آموزش و معماری سادهتر برای مدلهای زبانی بزرگ.
 اخبار
همکاری OpenAI و Cerebras برای افزایش توان محاسباتی هوش مصنوعی
همکاری جدید OpenAI و Cerebras با افزودن ۷۵۰ مگاوات توان محاسباتی پرسرعت، تأخیر استنتاج را کاهش داده و چتجیپیتی را برای کاربران سریعتر میکند.
 سختافزار
هوش مصنوعی در دستهی Groq: پیوستن به Hugging Face و سرعت بینظیر
Groq به تازگی به عنوان یک ارائهدهندهی استنتاج در Hugging Face Hub معرفی شد؛ تکنولوژی LPU™ آن، سرعت بیسابقهای را برای مدلهای زبانی سنگین فراهم میکند. این پیشرفت در حوزهی سرورلس و هوش مصنوعی چگونگی کارکرد آن چیست؟
 محصولات
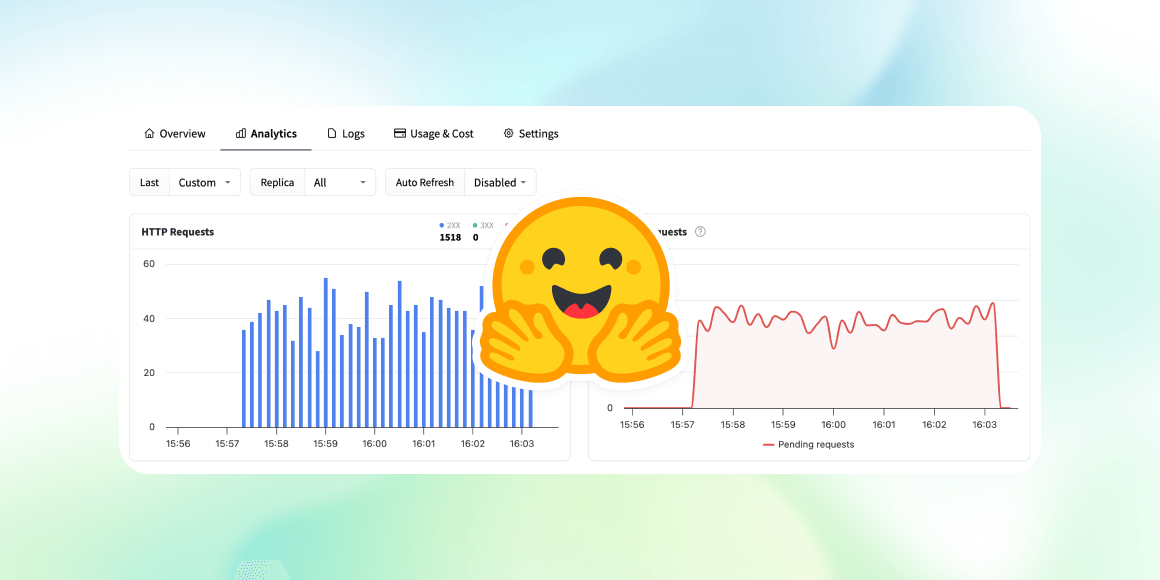
هاگینگ فیس: جهشی در تحلیل بیدرنگ عملکرد نقاط پایانی هوش مصنوعی
هاگینگ فیس داشبورد تحلیل عملکرد نقاط پایانی استنتاج خود را بهروزرسانی کرد. اکنون کاربران به معیارهای بیدرنگ، بارگذاری سریعتر دادهها و پایش دقیقتر برای استقرار بهینه مدلهای هوش مصنوعی دسترسی دارند.
 اخبار
پیوستن Fireworks.ai به Hugging Face بهعنوان ارائهدهنده استنتاج: سرعت بالاتر برای هوش مصنوعی
پلتفرم Fireworks.ai بهصورت رسمی به اکوسیستم Hugging Face پیوست تا کاربران از استنتاج سرورلس سریعتر برای مدلهای هوش مصنوعی محبوب بهرهمند شوند.
 اخبار
هوش مصنوعی و مدیریت هزینه در پردازش روزانه بیش از یک میلیارد داده
با رشد تقاضا برای پردازش دادههای عظیم، بهینهسازی استنتاج هوش مصنوعی برای انجام روزانه بیش از یک میلیارد طبقهبندی بدون افزایش هزینه کلیدی است.