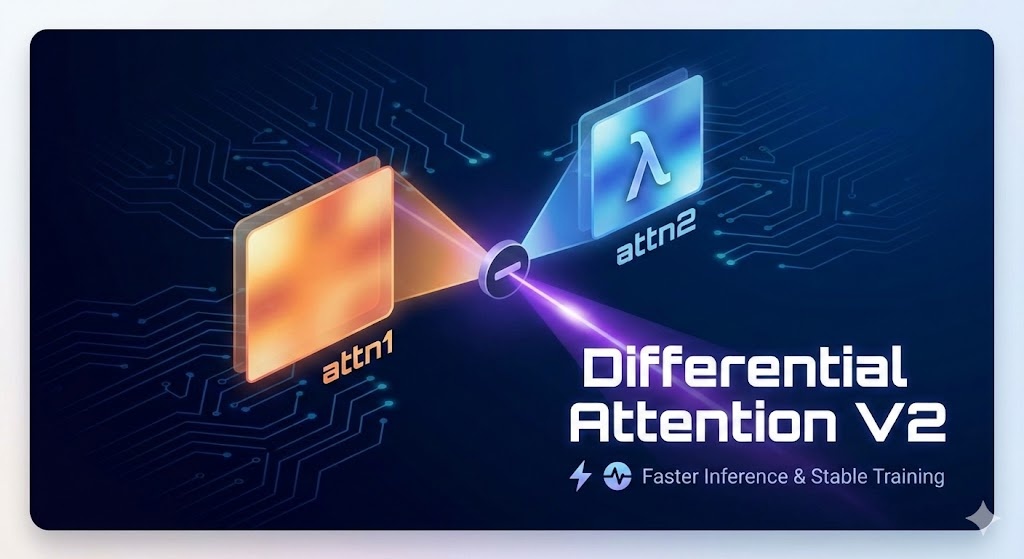
مایکروسافت به تازگی نسخه دوم ترنسفورمر دیفرانسیلی (Differential Transformer V2) را بهعنوان یک پیشرفت مهم در حوزه معماری مدلهای زبانی بزرگ منتشر کرده است. این مدل که توسط تیمهایی از پژوهشگران مایکروسافت و دانشگاههای همکار توسعه یافته، با تمرکز بر بهبود کارایی استنتاج، پایداری آموزش در مقیاس تولید و سادگی معماری، گام تازهای در جهت ساخت مدلهای هوش مصنوعی قدرتمندتر برداشته است.
در حالی که نسخه اول ترنسفورمر دیفرانسیلی (DIFF V1) برتری خود را در کاهش نویز و بهبود توجه نشان داده بود، نسخه دوم با بازبینی اساسی، به دنبال حل چالشهای عملی در آموزش مدلهای بزرگ است. این نسخه به دلیل حذف نیاز به هستههای سفارشی و شتابدهی سریعتر، میتواند تحولی در استقرار مدلهای زبانی در محیطهای تولیدی ایجاد کند.
چرا Differential Transformer V2 اهمیت دارد؟
معماریهای مبتنی بر ترنسفورمر به ستون فقرات بسیاری از مدلهای زبانی بزرگ تبدیل شدهاند، اما همچنان با چالشهایی مانند مصرف بالای محاسبات و بیثباتی در آموزش با نرخ یادگیری بالا روبرو هستند. DIFF V2 با معرفی مکانیزمهای تازه، تلاش میکند این مشکلات را برطرف کند. نکته کلیدی، بهبود «استنتاج» بدون نیاز به هستههای سفارشی است؛ یعنی توسعهدهندگان میتوانند به سادگی از این معماری در زیرساختهای موجود استفاده کنند.
از دیگر ویژگیهای این نسخه، اعمال محدودیت بر اندازه «سافتمکس» (Softmax) است که به کاهش ناپایداریهای عددی کمک میکند. پژوهشگران همچنین با حذف «سینکهای توجه» (Attention Sinks) به یک معماری تمیزتر و خواناتر دست یافتهاند که درک رفتار مدل را آسانتر میکند.
آزمایشهای پیشگامانه در مقیاس تولید
مایکروسافت برای ارزیابی DIFF V2، آزمایشهای پیشآموزشی را روی مدلهای متراکم (dense) و یک مدل مخلوط از متخصصان (MoE) با نام 30A3 انجام داده است. این آزمایشها بر روی تریلیونها توکن و با نرخ یادگیری بالای ۰.۰۰۰۶ تا ۰.۰۰۱ صورت گرفته است. نرخ یادگیری بزرگ در مقیاس تولید، چالشبرانگیز است اما DIFF V2 از نظر پایداری آموزش، عملکرد قابل توجهی نشان داده است.
بخشی از یافتههای اولیه حاکی از آن است که این مدل میتواند با استفاده از نرخ یادگیری بالا، سریعتر به همگرایی برسد، ضمن اینکه نوسانات تدریجی کمتری دارد. با این حال، نتایج نهایی هنوز در دست بررسی است و پژوهشگران تأکید کردهاند که آزمایشها همچنان در مراحل بعدی آموزش ادامه دارد.
ویژگیهای کلیدی نسخه دوم
- استنتاج سریعتر بدون نیاز به هستههای سفارشی و کاهش وابستگی به سختافزار خاص
- اعمال محدودیت بر قدرمطلق سافتمکس برای افزایش پایداری ریاضی
- طراحی معماری سادهتر با حذف کامل سینکهای توجه
- پایداری بالا در آموزش مدلهای MoE با نرخ یادگیری بالا
- مناسب برای استقرار در محیطهای تولید و مقیاسپذیری آسان
این ویژگیها نشان میدهد که مایکروسافت به دنبال معماریای است که نهتنها دقت بالایی داشته باشد، بلکه از نظر عملی نیز بتوان آن را در پروژههای واقعی به کار گرفت. طراحی تمیز و کاهش پیچیدگیهای محاسباتی، DIFF V2 را به گزینهای جذاب برای توسعهدهندگان و محققان تبدیل میکند.
جمعبندی و چشمانداز آینده
معرفی Differential Transformer V2، نشاندهنده ادامه روند نوآوری مایکروسافت در حوزه مدلهای زبانی است. این نسخه اگرچه هنوز در مراحل آزمایشی است، اما با تمرکز بر کارایی و پایداری، میتواند راه را برای نسل بعدی مدلهای هوش مصنوعی هموار کند. نتایج نهایی این آزمایشها، به ویژه در مورد عملکرد 30A3 MoE، میتواند اطلاعات ارزشمندی در اختیار جامعه پژوهشی قرار دهد.
به نظر میرسد حرکت به سمت معماریهای کارآمدتر و پایدارتر، روند غالب سالهای آینده خواهد بود و DIFF V2 بخشی از این جریان مهم است. علاقهمندان میتوانند برای مطالعه جزئیات بیشتر به وبلاگ رسمی Hugging Face مراجعه کنند.
پرسشهای پرتکرار
Differential Transformer V2 چیست؟
این نسخه دوم معماری ترنسفورمر دیفرانسیلی است که توسط مایکروسافت معرفی شده و هدف آن بهبود کارایی استنتاج، پایداری آموزش مدلهای زبانی بزرگ و سادگی معماری با حذف سینکهای توجه است.
Differential Transformer V2 چه تفاوتی با نسخه اول دارد؟
این نسخه برخلاف DIFF V1 بر کارایی استنتاج بدون هسته سفارشی و پایداری آموزش با نرخ یادگیری بالا تمرکز دارد. همچنین محدودیت بر سافتمکس و حذف سینکهای توجه از دیگر تفاوتهای اصلی آن است.