
 اخبار
همکاری OpenAI و Axel Springer: هوش مصنوعی در رسانههای کمکی
OpenAI با Axel Springer توافقی را برای تعمیق استفاده مفید از هوش مصنوعی در روزنامهنگاری امضا کرده است؛ اولین شرکای رسانهای در این حوزه، گامی مهم در تحول رسانهها.
 مدلها
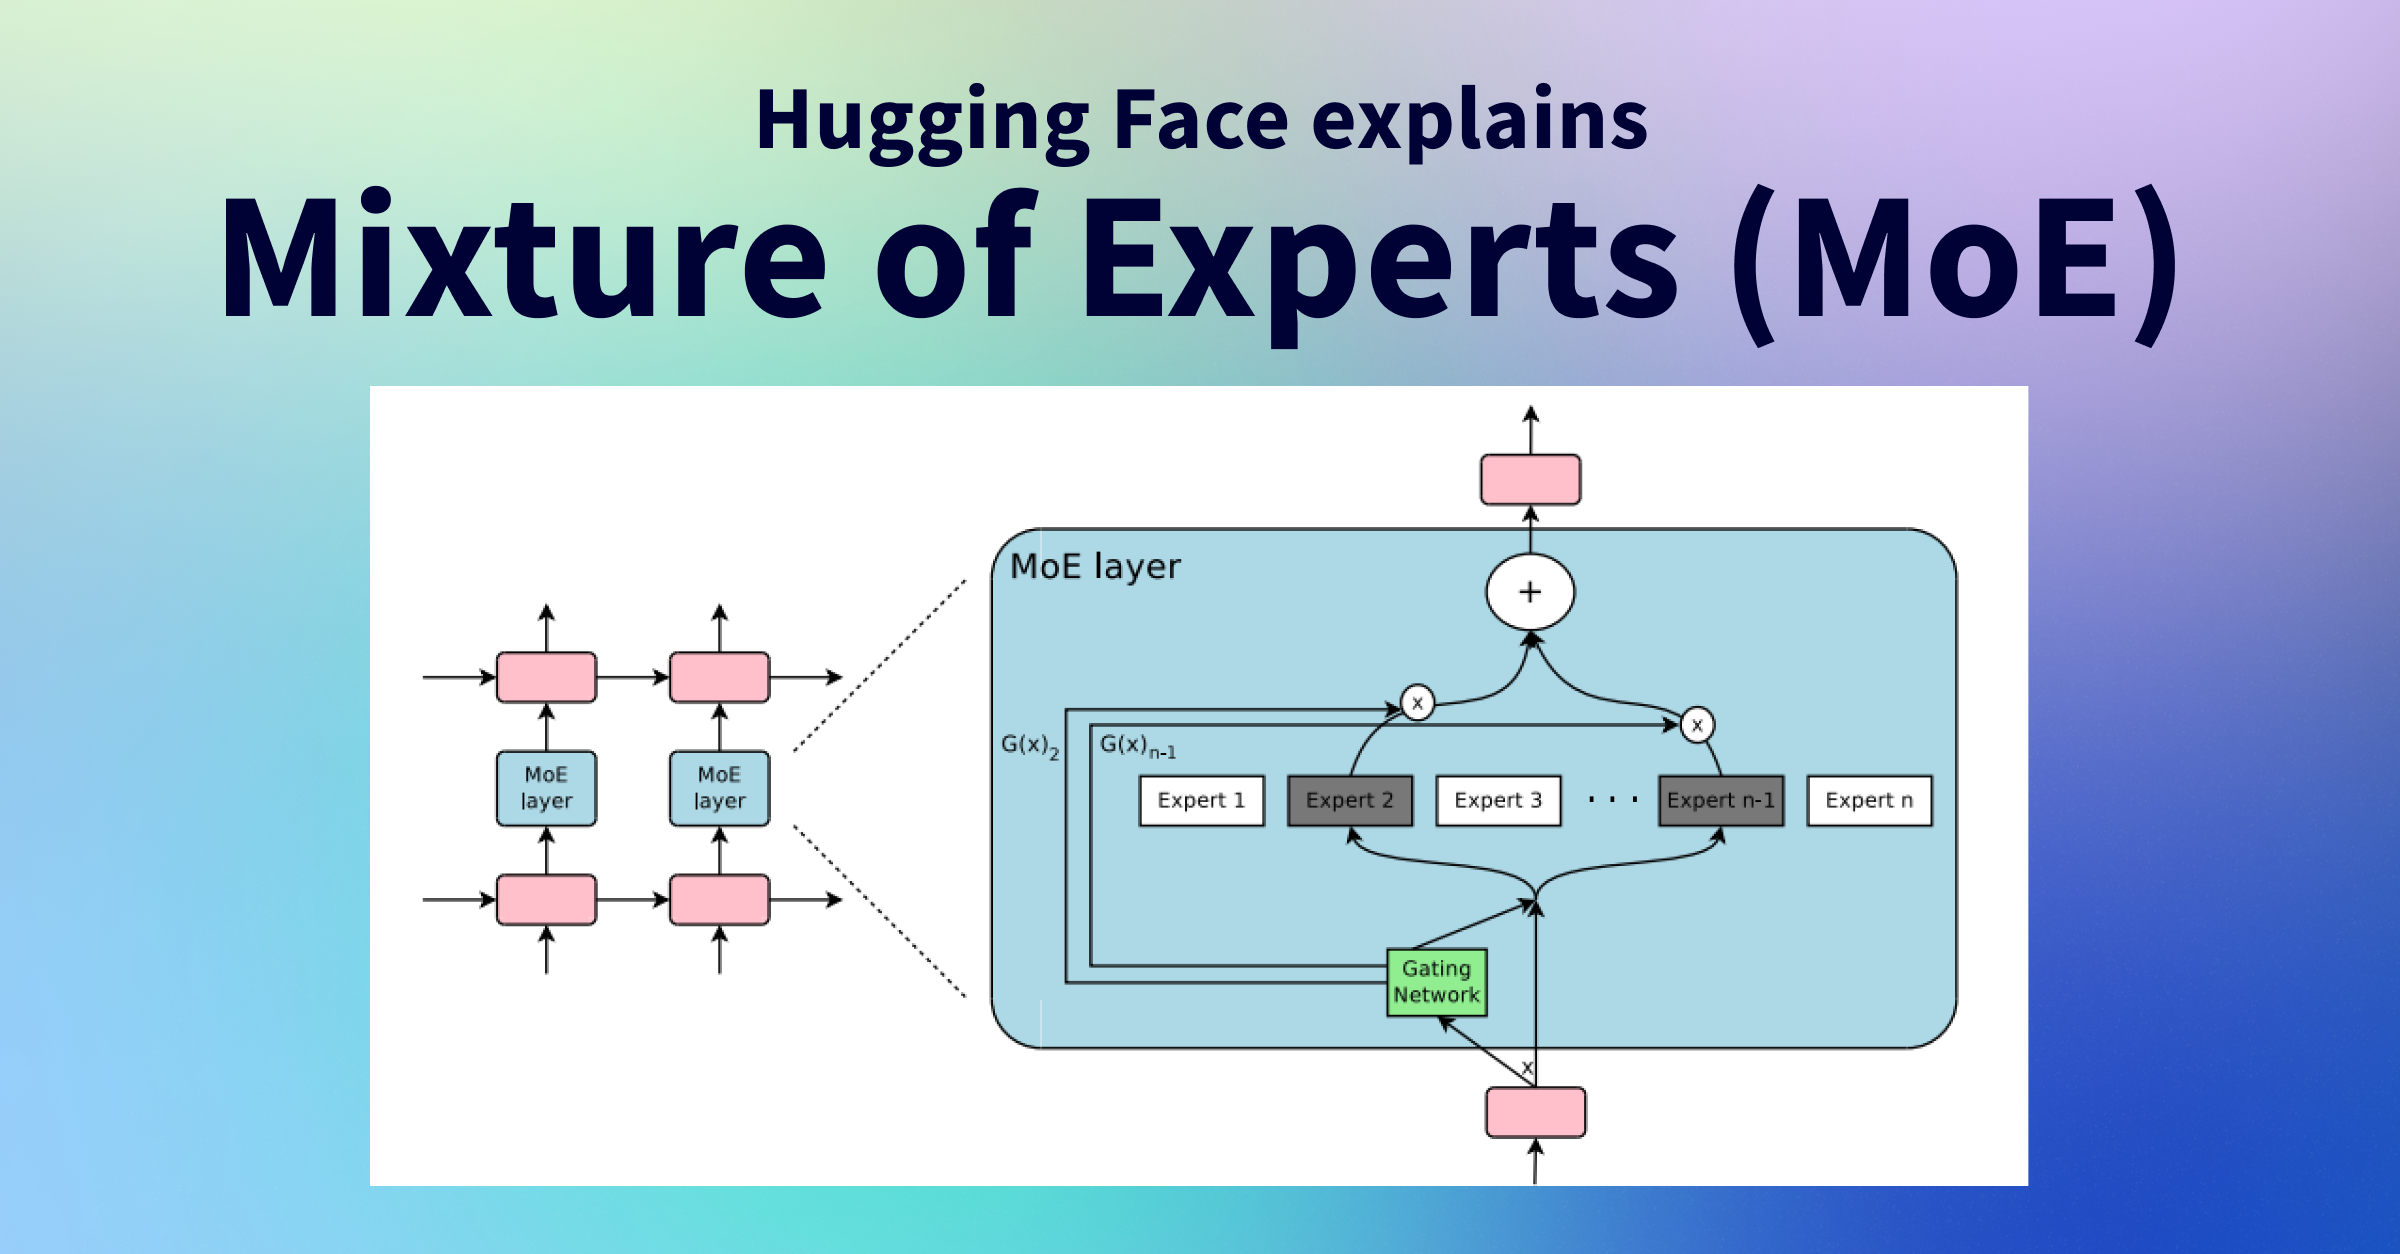
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 سختافزار
AMD و 🤗: تسریع LLMها بهصورت Out-of-the-Box با کارت گرافیک AMD
خبر جدید اینستیتوت هوش مصنوعی 🤗 و AMD، امکان اجرای سریع مدلهای زبانی بر کارتهای گرافیک MI300 را بدون نیاز به تغییر در کد، فراهم میکند.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 پژوهش
هوش مصنوعی و شراکتهای داده OpenAI: ساخت دیتاستهای باز و خصوصی
OpenAI در جریان ساخت دیتاستهای باز و خصوصی در شراکت با شرکتهای متفاوت قرار دارد. این همکاریها در راستای پیشرفت هوش مصنوعی و رعایت اخلاقیت دادهای است.
 سختافزار
هوش مصنوعی: سرعت جاندادانهای برای Llama 2 روی AWS Inferentia2
AWS Inferentia2 با همکاری Hugging Face و optimum‑neuron، Llama 2 را برای تولید متن به سرعتی بیسابقه بر روی سرورها میشکند. در این مقاله نقشه راه و نتایج آزمایشات را بررسی میکنیم.
 محصولات
هوش مصنوعی با شخصیسازی: ساخت همکار کدنویسی Personal Copilot
با همکار کدنویسی شخصیسازی شده، توسعهدهندگان میتوانند از مدلهای هوش مصنوعی پیشرفته بهرهبرند، فرآیند کدنویسی را سفارشی سازی کنند و بهصورت در VS Code بهینه شوند.
 پژوهش
هوش مصنوعی در حاشیه کد: با یک خط، مرور تعاملی دیتاست هگفیس
هر که در زمینهٔ یادگیری ماشین مشغول است، میتواند با یک خط کد از قابلیت Spotlight هگفیس برای بررسی تعاملی دیتاست بهرهبرد. این ابزار، هممرکزسازی داده و ریزش و کارایی تجزیه و تحلیل را در یک محیط باز فراهم میکند.
 مدلها
پیشرفت هوش مصنوعی: تلاش برای بهینهسازی ساده SDXL جهت سرعت و حافظه
یادآورترین نکات بهینهسازی ساده SDXL، مدل پیشرفته تولید تصویر هوش مصنوعی، با تأکید بر سرعت، حافظه و کارایی در مقالهٔ تازه ما.
 پژوهش
هوش مصنوعی در فرمهای آنلاین: تجربه گفتگو بر پایه GPT‑4 و توسعه پویا
Typeform با ترکیب GPT‑3.5 و GPT‑4 فرمهای آنلاین را به تجربههای تعاملی و خودتنظیم تبدیل کرده و کاربران را قادر میسازد دادههای پویا جمعآوری کنند.