
 مدلها
کوانتیزاسیون ۴-بیتی و QLoRA؛ گامی بلند در دسترسپذیری هوش مصنوعی
با همکاری Hugging Face و کتابخانه bitsandbytes، مدلهای زبانی بزرگ اکنون با دقت ۴-بیتی روی سختافزار معمولی اجرا شده و امکان آموزش تطبیقگرها با QLoRA فراهم شده است.
 پژوهش
هوش مصنوعی زنده: آموزش Stable Diffusion برای پیروی از دستورات ویرایش تصویر
در این مقاله، روش تنظیم دستوری Stable Diffusion با InstructPix2Pix بررسی میشود؛ روشی که به مدل اجازه میدهد دستورات متنی را برای ویرایش تصاویر اجرا کند.
 اخبار
حسابرسی امنیتی safetensors تأیید شد؛ فرمت پیشفرض ذخیره مدلهای هوش مصنوعی
حسابرسی امنیتی Trail of Bits امنیت کتابخانه safetensors را تأیید کرد و سه شرکت پیشرو، این فرمت را به استاندارد پیشفرض ذخیره مدلهای هوش مصنوعی تبدیل میکنند.
 اخبار
همکاری Hugging Face و IBM برای سازندگان هوش مصنوعی در watsonx.ai
در همکاری جدید Hugging Face با IBM، استودیوی سازمانی watsonx.ai به سازندگان هوش مصنوعی امکان میدهد مدلهای متنباز را برای کسبوکارها شخصیسازی کنند.
 محصولات
اپلیکیشن رسمی ChatGPT برای آیفون منتشر شد؛ هوش مصنوعی در جیب شما
اپلیکیشن رسمی ChatGPT برای iOS با ورودی صوتی و همگامسازی گفتگوها عرضه شد. جدیدترین مدلهای هوش مصنوعی اکنون در دسترس کاربران آیفون است.
 مدلها
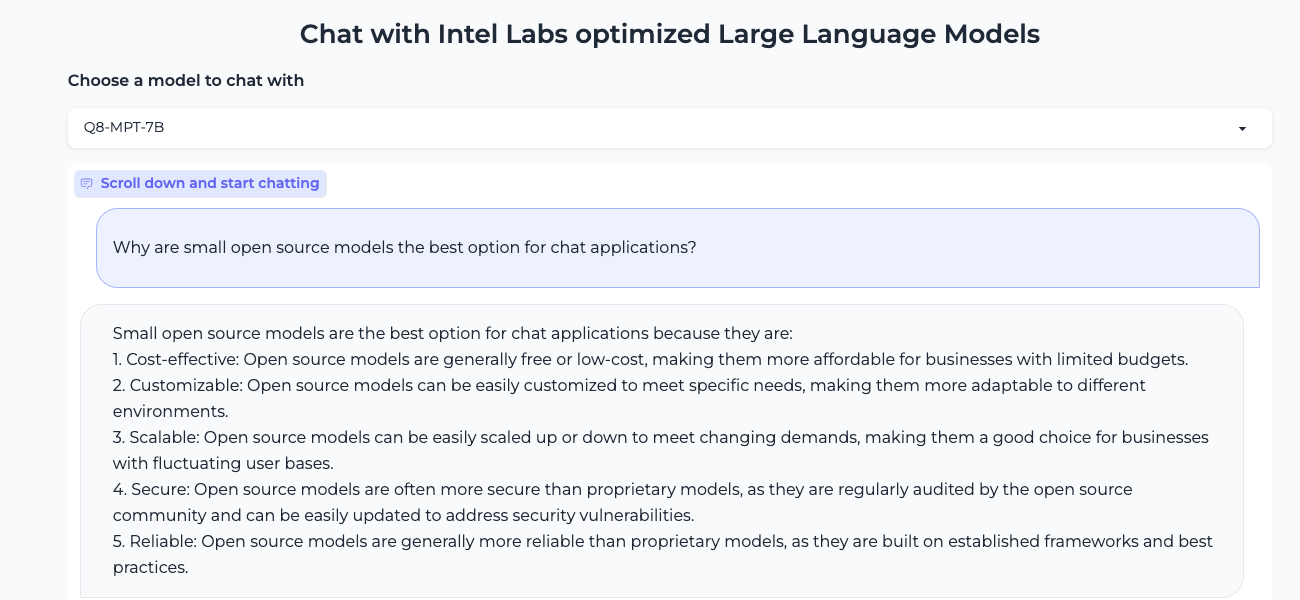
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.
 پژوهش
حذف دادههای تکراری در مقیاس بزرگ؛ راز آموزش هوش مصنوعی باکیفیت
پروژه BigCode با روشهای پیشرفته deduplication، دادههای تکراری را در مقیاس بزرگ حذف میکند تا مدلهای زبانی با کیفیت و امنیت بالاتری آموزش ببینند.
 مدلها
معماری RWKV؛ ترکیب هوش مصنوعی بازگشتی با توانمندی ترنسفورمر
معماری RWKV با ادغام شبکههای بازگشتی (RNN) و ترنسفورمر، راهکاری نوین و کارآمد برای مدلهای زبانی بزرگ ارائه میدهد. در این مقاله به بررسی ویژگیها، کاربردها و آینده آن میپردازیم.
 مدلها
اجرای چتبات شبیه ChatGPT با هوش مصنوعی روی یک GPU AMD؛ ممکن شد
در این مقاله وبلاگ هوش مصنوعی هما، نحوه اجرای مدل Vicuna روی یک کارت گرافیک AMD با فناوری ROCm را بررسی میکنیم. راهکاری مناسب برای ساخت چتبات شبیه ChatGPT
 پژوهش
هوش مصنوعی و تولید متن کمتأخیر: روش Assisted Generation تا ۱۰ برابر سریعتر
با Assisted Generation در هوش مصنوعی، تأخیر تولید متن در مدلهای زبانی بزرگ تا ۱۰ برابر کاهش مییابد؛ بدون افت کیفیت، برای پاسخگویی بلادرنگ.