
 پژوهش
هوش مصنوعی: چگونه مدلهای بزرگ زبانی بدون نمونهچین آزمایش شوند
این مقاله به بررسی روشهای بدون نمونهچین (Zero‑Shot) برای ارزیابی مدلهای زبان عظیم در هاب هوش مصنوعی میپردازد و ابزارهای جدید را معرفی میکند.
 پژوهش
هوش مصنوعی را با Evaluation on the Hub ارزیابی کنید – راهنمای جامع اوپنسورس
معرفی Evaluation on the Hub، ابزار جدید اوپنسورس برای ارزیابی مدلهای هوش مصنوعی بدون نوشتن کد، توضیحات کاربردی، مراحل عملی و نکات کلیدی.
 پژوهش
نقدنویسی هوش مصنوعی، مهارتی نو برای کشف و بهینهسازی ضعفهای خلاصه
OpenAI با مدلهای «نقدنویسی» هوش مصنوعی، بهصورت خودکار عیوب در خلاصههای متن را تشخیص میدهد؛ این فناوری مقیاسپذیر، نقش مهمی در نظارت انسانی بر سیستمهای پیچیده ایفا میکند.
 پژوهش
آموزش مدل GPT-2 خودساخته CodeParrot برای کد نویسی هوش مصنوعی
در این مقاله به آموزش مرحله به مرحله ساخت مدل GPT‑2 به نام CodeParrot میپردازیم؛ از جمعآوری ۱۸۰ گیگابایت کد پایتون تا آموزش و ارزیابی نهایی، ویژگیها و نکات کلیدی این پروژهٔ هوش مصنوعی را توضیح میدهد.
 پژوهش
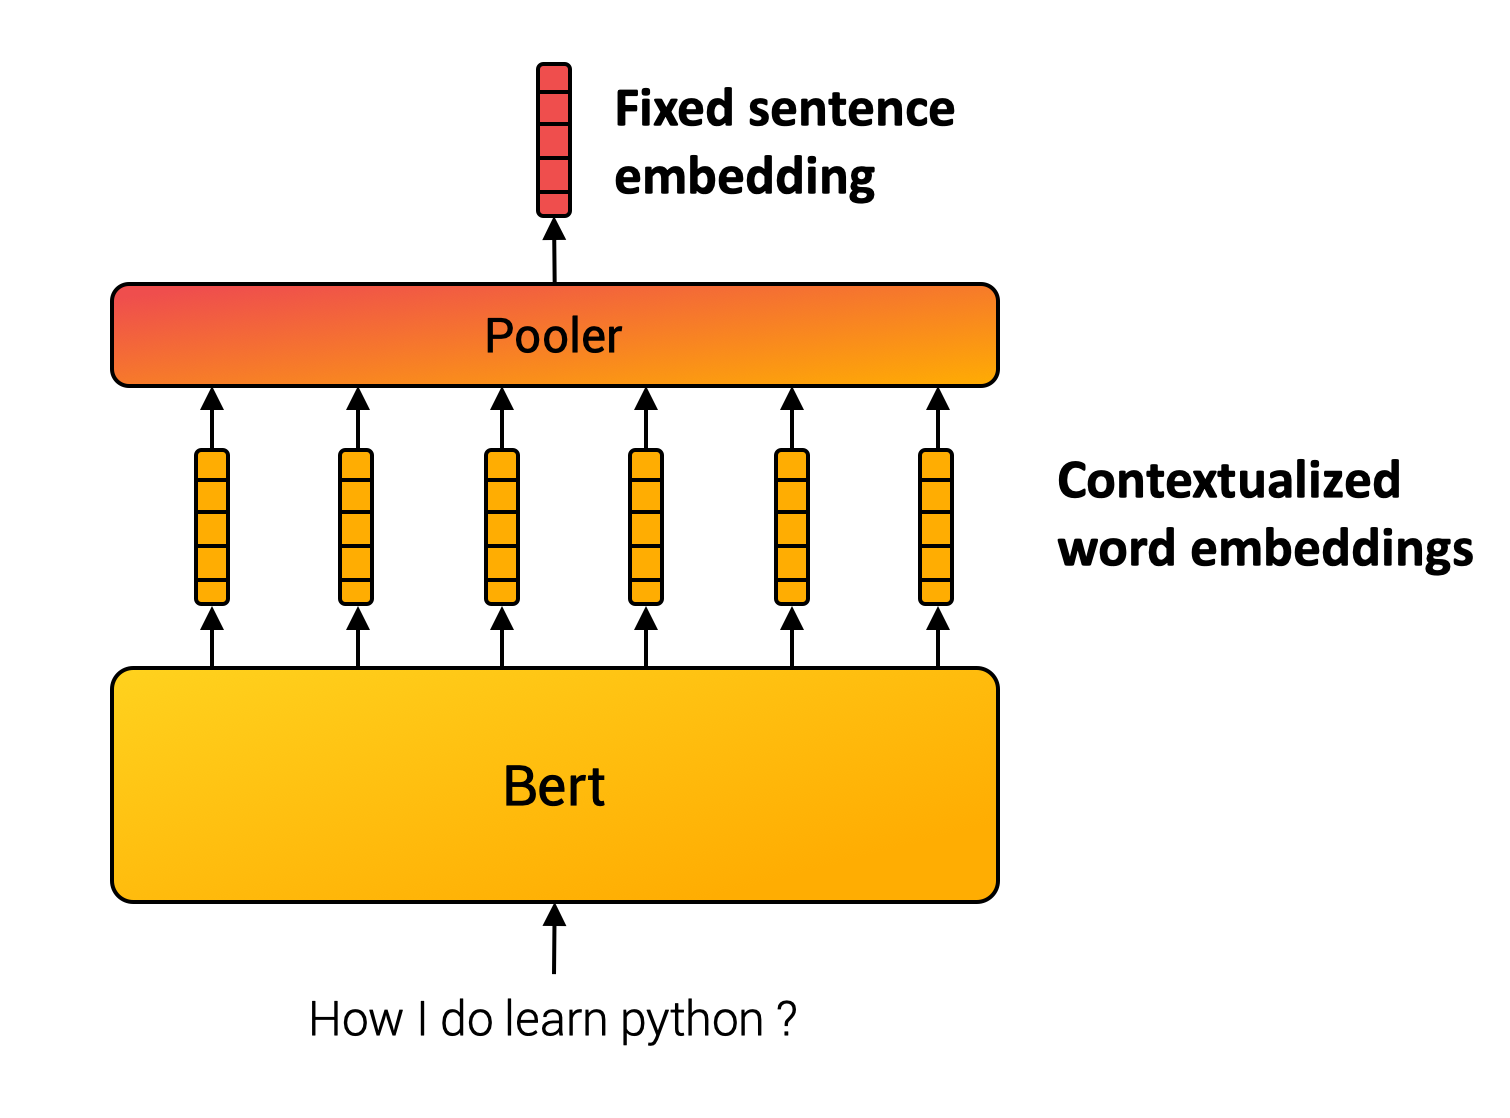
کیفیت جملات هوش مصنوعی بهوسیله ۱ میلیارد جفت آموزش داده میشود
در این پست، هوش مصنوعی با استفاده از ۱ میلیارد جفت آموزش، مدلگذاری جملات را به سطح جدیدی میبرد؛ نوشتن، ترکیب و ارزیابی در این مقاله بررسی میشود.
 پژوهش
ارزیابی مدلهای زبانی بزرگ آموزشدیده روی کد؛ رویکرد نوین OpenAI
در این مقاله به بررسی روشهای ارزیابی مدلهای زبانی بزرگ متخصص در کدنویسی میپردازیم و معیار HumanEval و اهمیت آن را برای سنجش هوش مصنوعی کدنویس تحلیل میکنیم.
 پژوهش
معیار جدید Procgen؛ سنجش تعمیمپذیری مهارتهای عاملهای هوش مصنوعی
در این مقاله، معیار Procgen Benchmark از OpenAI را بررسی میکنیم؛ ابزاری با ۱۶ محیط رویهای که سرعت یادگیری مهارتهای قابلتعمیم را در عاملهای یادگیری تقویتی میسنجد.
 پژوهش
رونمایی OpenAI از معیاری برای اکتشاف امن در یادگیری تقویتی هوش مصنوعی
OpenAI معیاری جدید برای سنجش اکتشاف امن در یادگیری تقویتی عمیق معرفی کرد. این معیار به محققان کمک میکند تعادل میان اکتشاف و ایمنی را ارزیابی کنند.
 پژوهش
نوآوری OpenAI: سنجش مقاومت هوش مصنوعی در برابر حملات ناشناخته
OpenAI متدی جدید برای سنجش مقاومت شبکههای عصبی در برابر حملات خصمانه پیشبینینشده معرفی کرده است. متریک UAR کارایی مدلها را در برابر تهدیدات ناگهانی ارزیابی میکند.
 پژوهش
هوش مصنوعی: ارزیابی خطراتی از توابع پاداش نادرست در یادگیری تقویتی
در این مقاله به بررسی عواقب استفاده از توابع پاداش نادرست در الگوریتمهای یادگیری تقویتی میپردازیم و نکات کلیدی برای طراحی صحیح آن را ارائه میکنیم.