
معرفی مدلسازی جملات در هوش مصنوعی
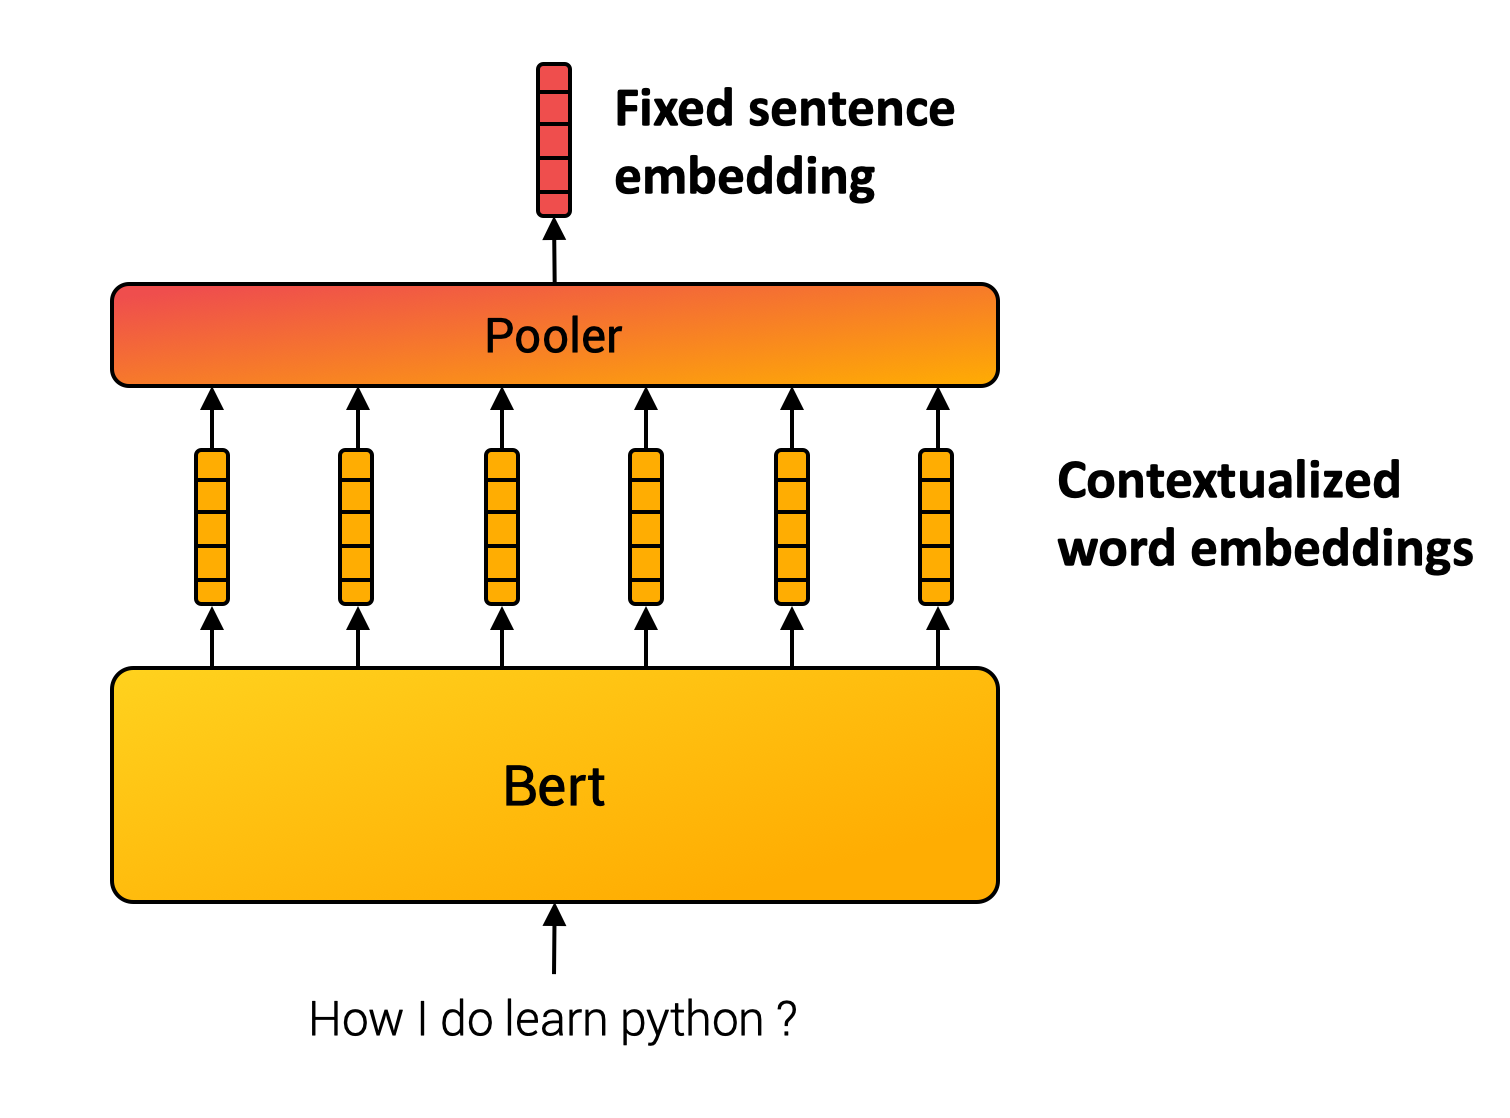
مدلهای embedding جملات، متن را به بردارهای عددی تبدیل میکنند تا معنا و ساختار جمله در فضای بردار قابل بررسی باشد. این روش بهویژه در کاربردهای تشخیص متن، همبستگی معنایی و پرسش‑پاسخ بسیار موثر است.
متدولوژی آموزش ۱ میلیارد جفت
Hugging Face در دوره Community Week از ترکیب پیشرفته JAX/Flax بهرهمند شد و با استفاده از الگوی Multiple Negative Ranking Loss، مدل را بر روی ۱ میلیارد جفت سؤال‑ جواب طبیعی آموزش داد. این حجم عظیم دادههای متنی باعث ارتقاء دقت و قطریت مدل شد.
سرورها و زیرساختهای بهینهسازی شده
پروژه روی ۷ TPU v3‑8 اجرا شد و بخشهای مهم مانند sharding، mixed‑precision training و batch‑size tuning بهدنبال ساماندهی بهتر و زمان آموزش کوتاهتر بود. پشتیبانی تیمهای Google Cloud و JAX راهنمای موثری برای بهبود کارایی فراهم کرد.
کاربردهای عملی و نتایج تحقیقاتی
نتایج نتایج بهدست آمده نشان داد که مدل ۱‑بیلیون محاسبات دمجفت، بر روی benchmarkهای CLUE و SemEval جایگاه برتری را به دست میآورد و میتواند بهعنوان سرویس embedding در سیستمهای پرسش‑پاسخ مفتوح و جستجوی معنایی استفاده شود.
- کاهش انتصابهای نادرست در سامانههای وردپرس
- بهبود دقت جستجوی semantic در سامانههای e‑commerce
- پشتیبانی از تشخیص تقلب در برچسبگذاری متن
پرسشهای پرتکرار
چند جفت آموزش برای ایجاد مدل embedding جملات تعمیمپذیر لازم است؟
برای دستیابی به مدل عالی، حداقل ۱ میلیارد جفت آموزش مقدار بالایی از تنوع معنایی ارائه میدهد و در اکثر مطالعات بهعنوان حد مناسب دیده میشود.
به چه شکل میتوان از این مدل در گتریکهای تجاری بهرهمند شد؟
مدل embedding میتواند در فیلتر کردن محتوا، پیشبینی تعامل کاربر و ساماندهی محصولات بر اساس معنا استفاده شود.


