
 پژوهش
جدول رهبری NPHardEval: سنجش توانایی استدلال هوش مصنوعی با مسائل سخت
NPHardEval معیاری پویا برای ارزیابی قدرت استدلال مدلهای زبانی بزرگ است؛ این جدول رهبری با ۹۰۰ مسئله سخت، هر ماه بهروز میشود.
 اخبار
هشدار زودهنگام برای سوءاستفاده زیستی از هوش مصنوعی؛ گامی از OpenAI
ارزیابی جدید OpenAI با مشارکت متخصصان و دانشجویان زیستشناسی نشان میدهد که GPT-4 تنها بهبودی جزئی در دقت ساخت تهدیدات زیستی ایجاد میکند؛ یافتهای که به عنوان نقطه شروع تحقیقات بیشتر مطرح شده است.
 مدلها
هوش مصنوعی در دنیای واقعی: جدول ردهبندی مدلها برای کاربردهای شرکتی
هفتمان مه جدید، جدول ردهبندی ارزیابی عملکرد مدلهای زبانی در سناریوهای واقعی شرکتی را از سوی هیوگینگ فیند معرفی کرده؛ بخشهای مالی، قانون، خدمات مشتری و شناسایی حساسیت را پوشش میدهد.
 پژوهش
ساخت لیدربورڈ هوش مصنوعی: گام به گام با Vectara و HHEM
راهنمای جامع نصب لیدربورڈ هوش مصنوعی در هاجینگ فیس با Vectara و امکان ارزیابی دقیق لسههای هالوژن در مدلهای LLM و مدلهای تجاری در مجتمع آموزشی.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 اخبار
هوش مصنوعی در شناسایی اشیاء: نمره بندی مدلها و مشکلات متریکها
در این مقاله، به بررسی لیست درجه بندی مدلهای تشخیص اشیاء در Hugging Face میپردازیم، متریکهای مهم مثل IoU و AP را توضیح داده و مشکلات احتمالی آنها را بررسی میکنیم.
 پژوهش
بررسی تعصب در مدلهای تولید تصویر از متن؛ چالشها و راهکارها
تعصب در مدلهای تولید تصویر از متن یکی از چالشهای جدی هوش مصنوعی است؛ در این مقاله منابع، روشهای شناسایی و راهکارهای مقابله با آن را بررسی میکنیم.
 اخبار
ابهامات در جدول ردهبندی مدلهای هوش مصنوعی هوگینگ فیس: چالش MMLU
هوگینگ فیس ابهامات اخیر در نتایج ارزیابی MMLU مدل LLaMA در جدول ردهبندی مدلهای زبان بزرگ آزاد خود را بررسی میکند. این ناهماهنگی بین امتیازات منتشر شده و نتایج ردهبندی، بحثهایی را در جامعه AI برانگیخته است.
 پژوهش
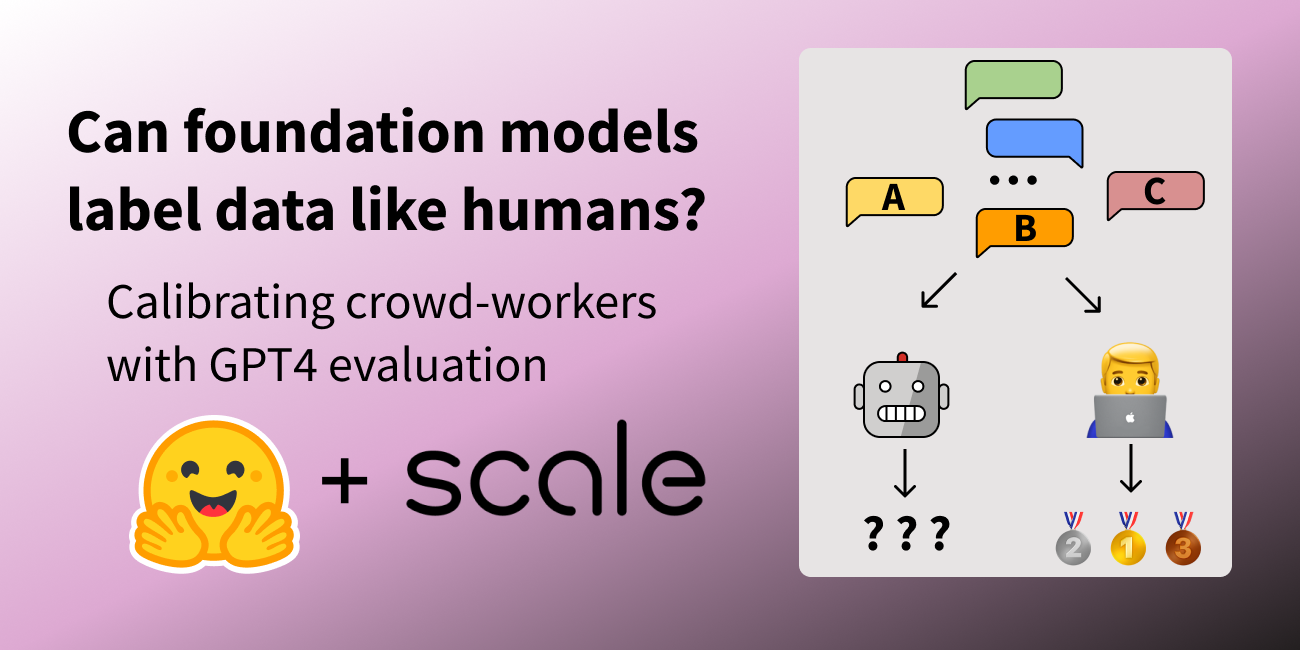
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 پژوهش
هوش مصنوعی در برابر سوگیری: چگونه کتابخانهی 🤗 Evaluate سوگیری مدلهای زبانی را بررسی میکند
کتابخانهی🤗 Evaluate از Hugging Face بر پایه معیارهای جدید، امکان سنجش سوگیری مدلهای زبانی را فراهم کرده است؛ به سوی هوش مصنوعی بدون تبعیض پیش میرود.