
 مدلها
کوانتایز دیفیوژن ترنسفورمر با Quanto: کاهش مصرف حافظه در هوش مصنوعی
با معرفی ابزارهای Quanto و Diffusers، اجرا کردن مدلهای سنگین تولید تصویر با هوش مصنوعی بر روی سختافزارهای محدودتر بدون افت عملکرد محسوس اکنون امکانپذیر است.
 پژوهش
LAVE: ارزیابی VQA بدون محدودیت زمانی روی Docmatix با LLMها
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 اخبار
معرفی SearchGPT: پروتوتایپ جستجوی نوین با پاسخهای زنده و دقیق
شرکت OpenAI پروتوتایپ موقت SearchGPT را معرفی کرد. این ابزار هوش مصنوعی با ارائه پاسخهای سریع و بهروز همراه با منابع شفاف، تجربه جستجوی کاربران را متحول میکند.
 مدلها
هوش مصنوعی با GPT‑4o mini: کارایی بالا در هزینه کمتر
OpenAI با معرفی GPT‑4o mini، نسخهای کمهزینه و با قدرت مشابه مدلهای پیشین ارائه داد. این مدل امکان پردازش هوشمند را در هزینهای گزافکاهش میدهد.
 پژوهش
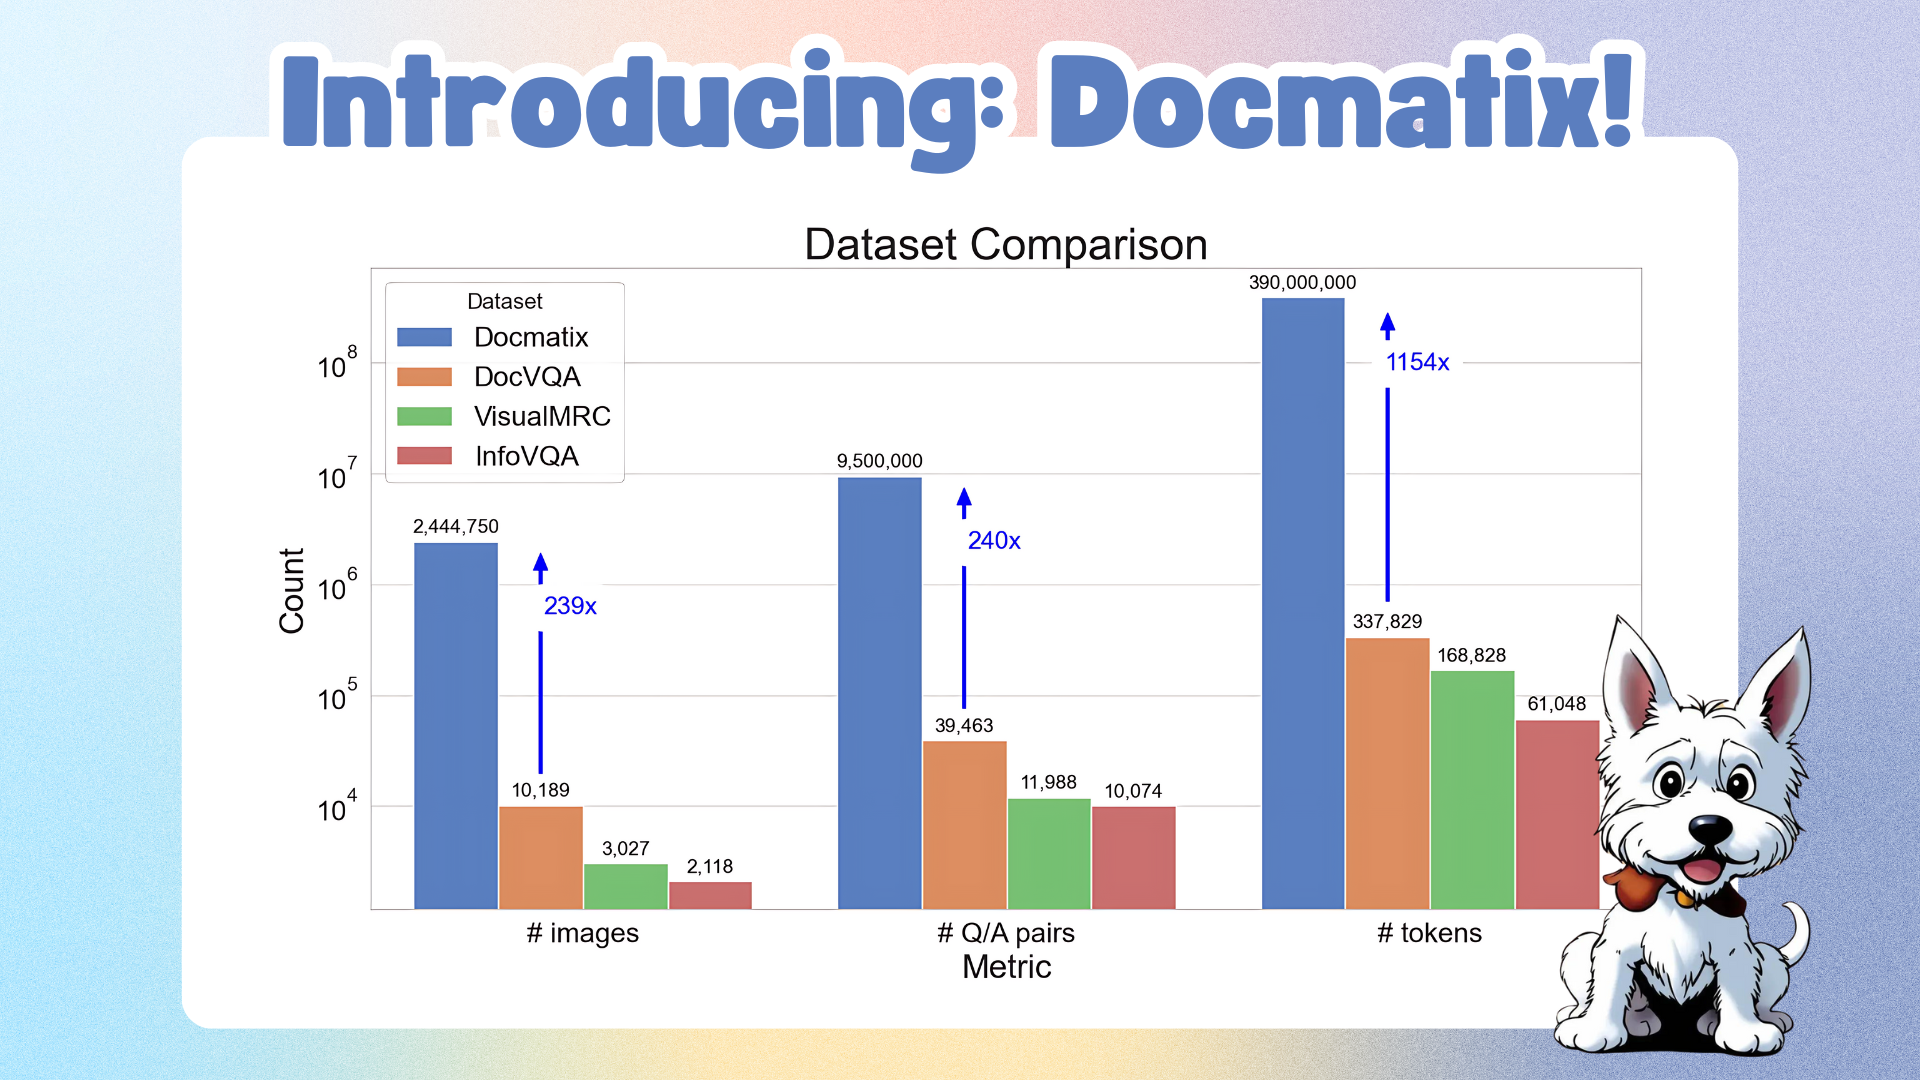
هوش مصنوعی: دیتاست Docmatix، ۲۴۰برابر بزرگتر از DocVQA برای پاسخگویی به سوالات تصویری در مستندات
در حالی که دیتاست DocVQA با ۱۰٬۰۰۰ تصویر کمبود داشت، Hugging Face دیتاستی تحت عنوان Docmatix را معرفی کرد؛ ۲.۴ میلیون تصویر و ۹.۵ میلیونپایهپاسخ برای پیشبینیهای عکس‑متن در مستندات PDF.
 مدلها
هوش مصنوعی با مدل SmolLM: سرعت بیسابقه و کارایی خارقالعاده
مدل SmolLM، خانواده کوچک و قدرتمندی از هوش مصنوعی با 135M، 360M و 1.7B پارامتر، بر پایه مجموعه داده قوی ساخته شده و امکان اجرا بر دستگاههای محلی را فراهم میکند.
 پژوهش
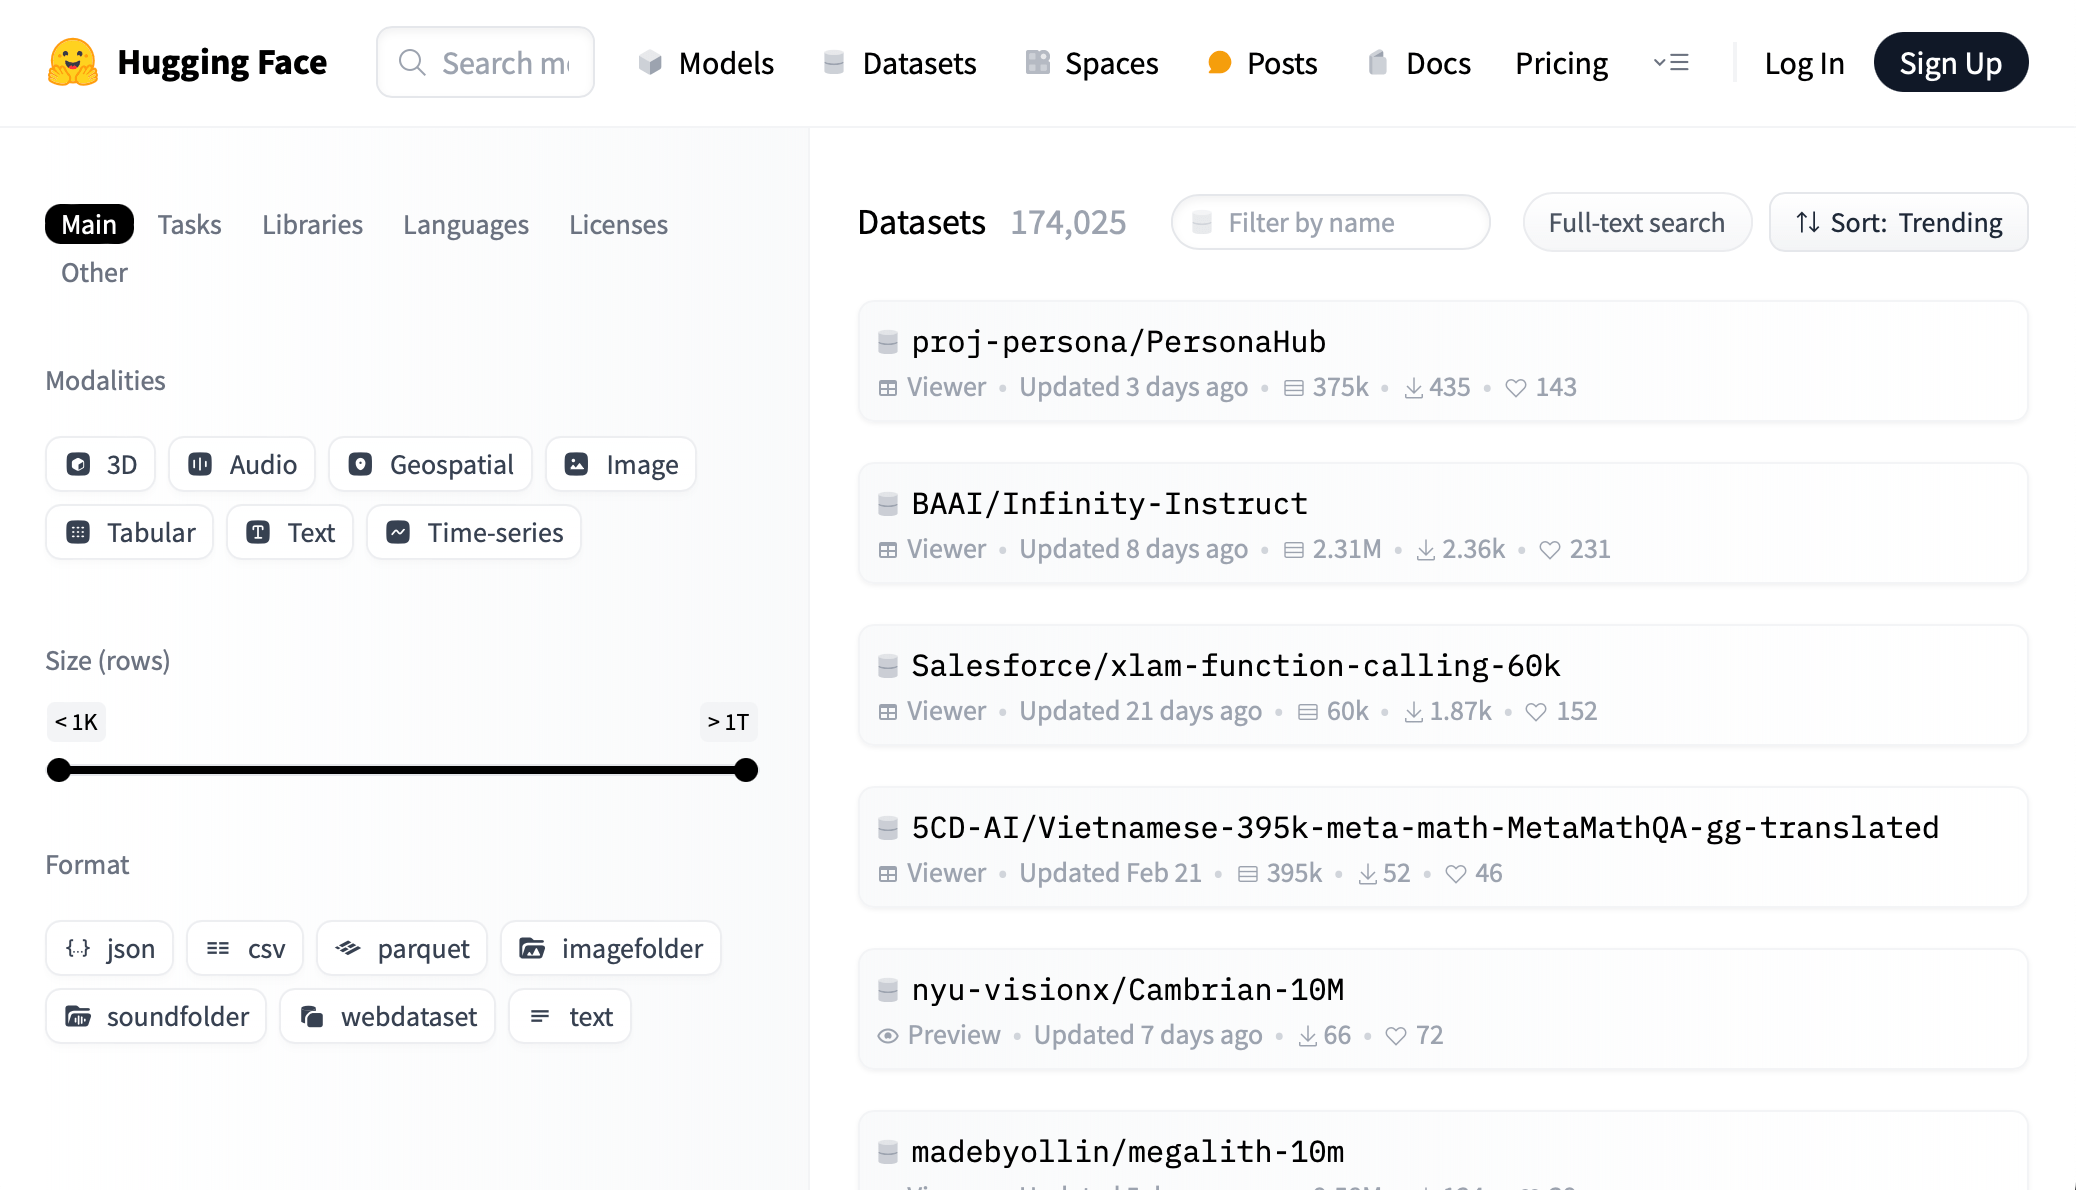
هفینگفیس معرفی میکند فیلترهای جستجوی هوش مصنوعی: مودالیتی، اندازه و فرمت دیتاست
هفینگفیس با افزودن فیلترهای مودالیتی، اندازه، فرمت و کتابخانه، جستجوی دیتاست را برای پژوهشگران و توسعهدهندگان هوش مصنوعی سادهتر کرده است. این ابزار جدید امکان انتخاب دقیق تر دیتا را فراهم میآورد.
 مدلها
گوگل معرفی میکند Gemma 2: آخرین مدل هوش مصنوعی متنباز
با معرفی Gemma 2، گوگل اولین مدل زبان متنباز نسل جدیدش را باز کرده و با امکانات پیشرفتهای نظیر sliding window attention و knowledge distillation، متنسازی را به سطح بالاتری برده است.
 پژوهش
هوش مصنوعی در ثبت اختراع: XLSCOUT ارائه کرد ParaEmbed 2.0 با ۲۳٪ افزایش دقت
XLSCOUT با همکاری Hugging Face معرفی ParaEmbed 2.0، مدل پیشرفتهای برای استخراج و همراستاسازی متون ثبت اختراع، با دقت ۲۳٪ بالاتر. این پیشرفت به عنوان گام مهمی در دیجیتالیسازی مالکیت فکری مطرح میشود.
 پژوهش
هوش مصنوعی در Prezi: چگونه همکاری با Hugging Face مسیر چندمتد را پیش میبرد
Prezi در راهاندازی هوش مصنوعی چندمدلی با پشتیبانی از برنامهی Expert Support Hugging Face. همکاری جدید، مدلهای متن-تصویر، متودهای نوین.