
 پژوهش
هوش مصنوعی در Liger GRPO: تقویت TRL با بهینهسازی حافظه و مقیاسپذیری
در این خبر، Liger GRPO با کاهش مصرف حافظه ۴۰٪ و افزودن امکانات FSDP و PEFT، آموزش RL را برای مدلهای بزرگ بهینه میکند و به تسهیل مقیاسپذیری در چند گپ تبدیل میشود.
 پژوهش
هوش مصنوعی در آزمایش خود: CriticGPT به کمک GPT-4 خطاهای ChatGPT را مییابد
مدل CriticGPT، بر پایه GPT‑4، بهصورت خودکار پاسخهای ChatGPT را تجزیه و تحلیل میکند تا در فرایند RLHF، مربیان را در شناسایی خطاها یاری رساند. نقش مهم در کیفیت تولید محتوا دارد.
 پژوهش
هوش مصنوعی و RLOO: Reinforcement Learning برگردد به RLHF
مرحلۀ جدید در آموزش مدلهای هوش مصنوعی: RLOO، متود Reinforcement Learning که کمحافظهتر و سریعتر از PPO است، برای پژوهشگران RLHF دسترسپذیر میشود.
 پژوهش
پیادهسازی RLHF با PPO: بازتولید کد OpenAI و نکات کلیدی
این مقاله به تفصیل جزئیات پیادهسازی یادگیری تقویتی با بازخورد انسانی (RLHF) در چارچوب PPO را بررسی میکند و از بازتولید کدهای OpenAI بهره میگیرد.
 پژوهش
هوش مصنوعی در لامّا ۲: آموزش مستقیم با DPO و سادهسازی RLHF
در این مقاله، نحوهی آموزش مستقیم لامّا ۲ با روش DPO در Hugging Face بررسی میشود؛ سادهسازی یادگیری بازخورد انسانی و مزایای آن توضیح داده میشود.
 پژوهش
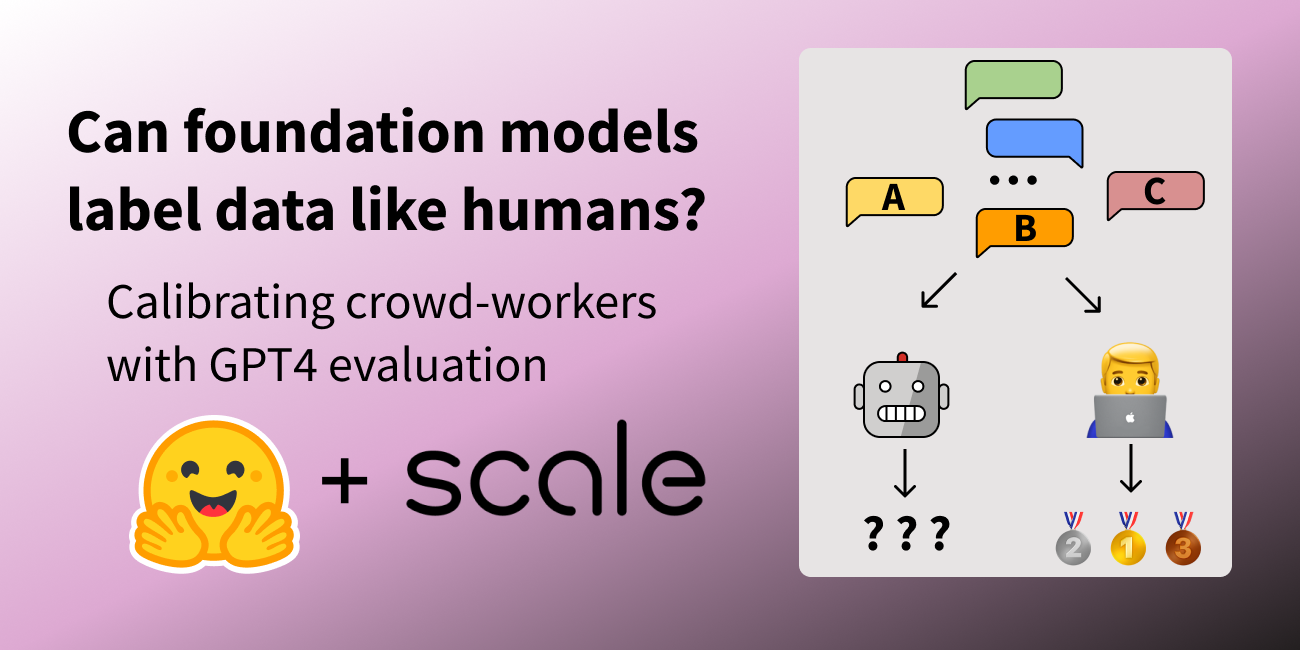
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 پژوهش
یکپارچگی BERTopic با هاب Hugging Face؛ پیشرفتی در مدلسازی موضوعی هوش مصنوعی
BERTopic اکنون به Hugging Face Hub متصل شده است؛ امکان ذخیره و بارگذاری مدلهای موضوعی با safetensors فراهم شده و گامی در جهت دموکراتیزه کردن هوش مصنوعی است.
 پژوهش
هوش مصنوعی با StackLLaMA: آموزش عملی دستنشان برای آموزش LLaMA با RLHF
مقالهی StackLLaMA را برای آموزش LLaMA با RLHF دستهبندی میکند؛ مراحل ساده، چالشها، و راهحلهای عملی، نمونهای برای ارتقاء و دموکراتیزهسازی AI.
 پژوهش
هوش مصنوعی: آموزش فاینتیونینگ 20B مدل با RLHF روی کارت گرافیک 24GB
در این مقاله، به بررسی آموزش فاینتیونینگ 20B مدل زبانی با یادگیری تقویتی (RLHF) روی کارت گرافیک 24GB پرداختهایم و نکات کلیدی را در راهحلهای متنباز پوشش میدهیم.
 پژوهش
هوش مصنوعی: رازهای ساخت ربات گفتگوی کارآمد و کارا در عصر دیجیتال
این مقاله به بررسی تکنیکهای کلیدی ربات گفتگوی هوش مصنوعی میپردازد؛ مثل RLHF، IFT، CoT و Red team. راهکارهای باز و متن‑باز برای بهتر کردن آنها در عصر دیجیتال را بررسی میکنیم.