چالش ردیابی وضعیت در متون طولانی
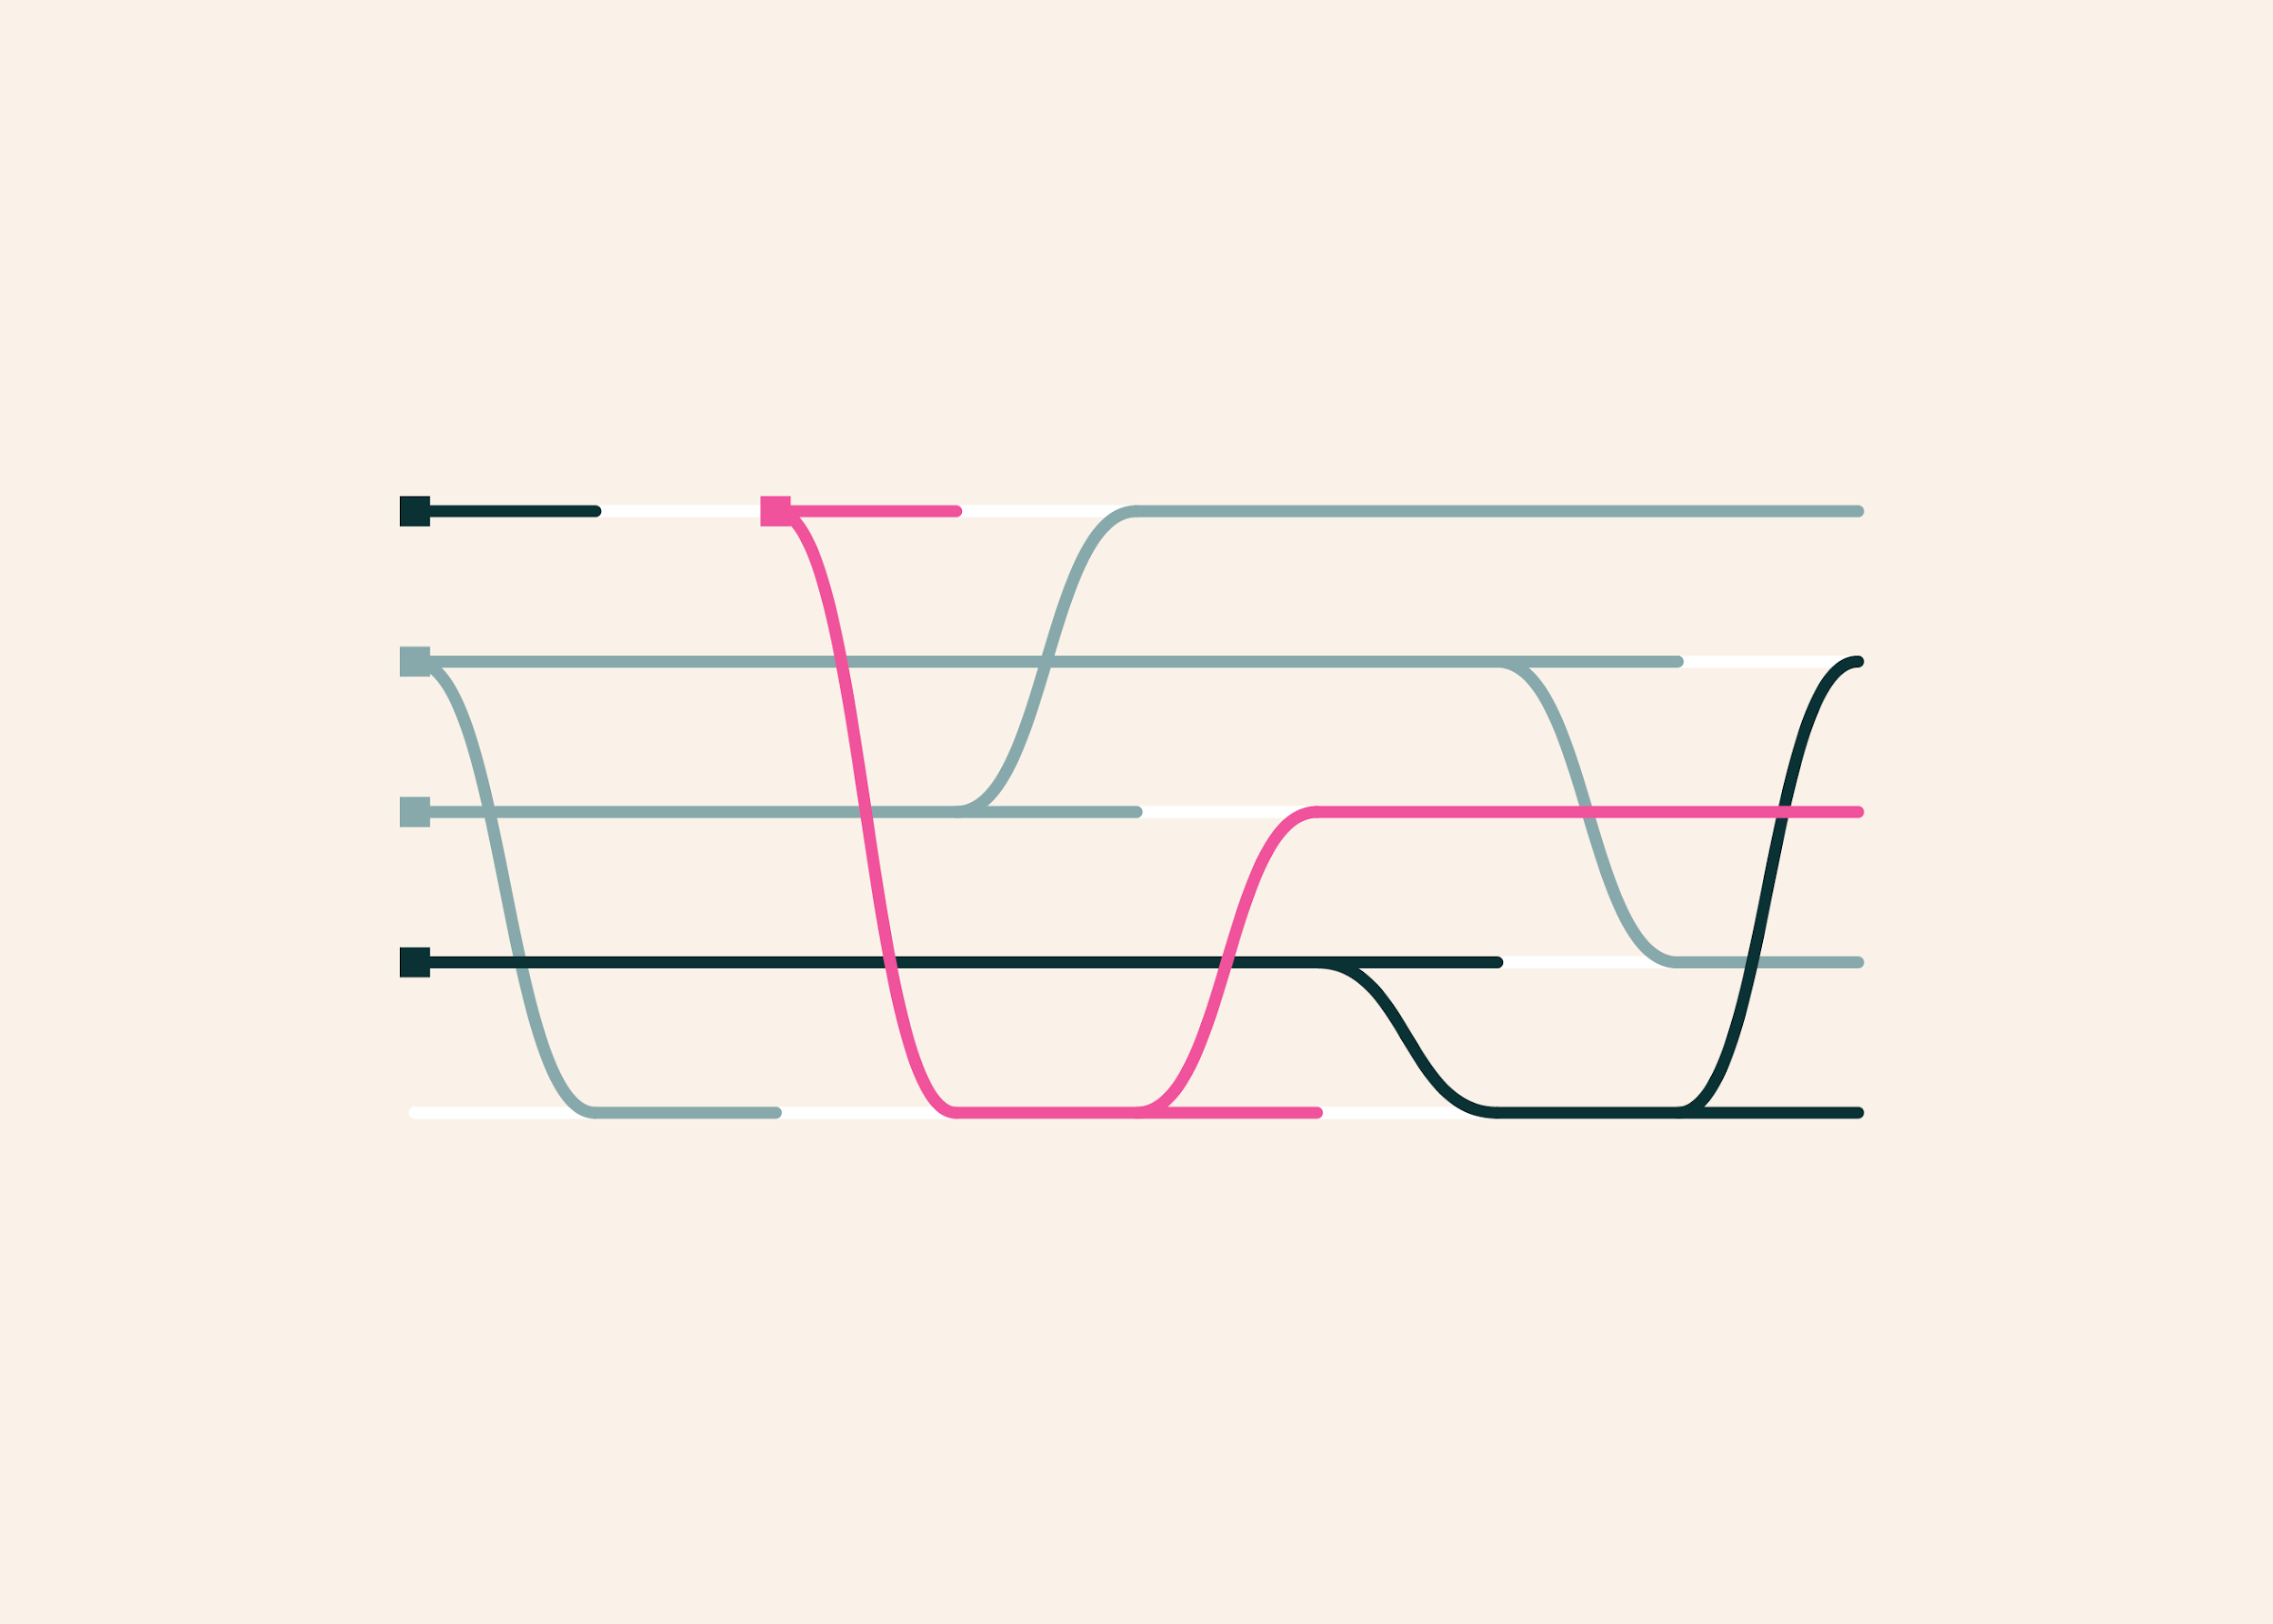
مدلهای زبانی بزرگ (LLM) اغلب در درک مفاهیم اولیه خوب هستند، اما وقتی بحث به ردیابی تغییرات چندلایهای در اسناد بسیار طولانی میرسد، ادایها پیچیدهتر میشود. بنچمارک جدید StateBench که توسط تیم پژوهشی Ai2 (Allen Institute for AI) منتشر شده، دقیقاً برای پر کردن این خلأ طراحی شده است. این ابزار میسازد توانایی مدلها را در پیگیری وضعیت موجودیتها (مانند متغیرهای کد یا شخصیتهای یک داستان) در طول زمان و با تغییرات مداوم بسنجد.
ردیابی وضعیت کاربردهای متنوعی دارد؛ از دنبال کردن تغییرات متغیرها در کد برنامهنویسی گرفته تا فهم خواندن یک رمان مرموز که در آن اشیاء بین شخصیتها دستبهدست میشوند. اگر مدل نتواند بفهمد کدام شخصیت در نهایت مالک یک شیء خاص شده است، پاسخهای بعدی آن مدل در زمینههای پیچیدهتر نمایشتر تلقی میشوند.
سطح دشواری و تفاوت مدلها
یکی از نکات کلیدی که Research Team در مقاله خود مطرح میکند، عدم یکسان بودن مسائل ردیابی وضعیت است. برخی سؤالات صرفاً نیاز به یافتن آخرین بهروزرسانی دارند، در حالی که دیگران نیازمند پیگیری زنجیرهای تغییرات هستند. در این زنجیرهها، یک oversight کوچک در مرحله میانی میتواند منجر به خطای فاحش در پاسخ نهایی شود.
نتایج اولیه نشان میدهد که حتی مدلهای پیشروی (Frontier Models) در وظایف پیچیدهتر چالشبرانگیزی دارند. مدلهای پیشآموزشدیده شما معمولاً در سطوح ساده عملکرد قابل قبولی نشان میدهند، اما با افزایش عمق زنجیرهی تغییرات، دقت آنها بهطور چشمگیری کاهش مییابد. این یافتهها نشان میدهد که هوش مصنوعی هنوز در درک ساختارهای وابسته به زمان و ترتیب رویدادها، فاصلهای تا کمال دارد.
پیامدها برای توسعهدهندگان و پژوهشگران
StateBench با انتشار دادهها و کد منبع، برای جامعهی علمی و صنعتی در دسترس قرار گرفته است. این بنچمارک میتواند به عنوان معیاری استاندارد برای مقایسه عملکرد مدلهای مختلف در کارهای Long-Context (زمینه بلند) استفاده شود. برای تیمهایی که بر روی پردازش اسناد قانونی، کدهای غلیظ یا روایتهای بلند کار میکنند، درک محدودیتهای فعلی مدلها برای طراحی معماریهای ایمنتر ضروری است.
- تعمیلی: StateBench از Ai2 برای سنجش ردیابی وضعیت ایجاد شد.
- کاربردها: شامل خواندن کد، پیگیری روایت داستان و تحلیل اسناد بلند است.
- یافته کلیدی: مدلها در مسائل نیازمند زنجیرهچندمرحلهای عملکرد ضعیفتری دارند.
پرسشهای پرتکرار
StateBench چیست و چه چیزی را میسنجد؟
StateBench یک بنچمارک جدید است که توانایی مدلهای زبانی را در ردیابی تغییرات وضعیت موجودیتها در متون طولانی ارزیابی میکند. این ابزار تمرکز بر پیگیری زنجیرهای تغییرات دارد، نه صرفاً حفظ اطلاعات اولیه.
چرا ردیابی وضعیت برای توسعهدهندگان هوش مصنوعی مهم است؟
زیرا بسیاری از کاربردهای واقعی (مانند تحلیل کد، اسناد حقوقی یا داستاننویسی) نیازمند آن هستند که مدل تغییرات تدریجی و وابسته به زمان را بهدقیق پیگیری کند. خطا در این فرآیند منجر به نتیجهگیری غلط کلی میشود.