چرا Docker و Kubernetes؟
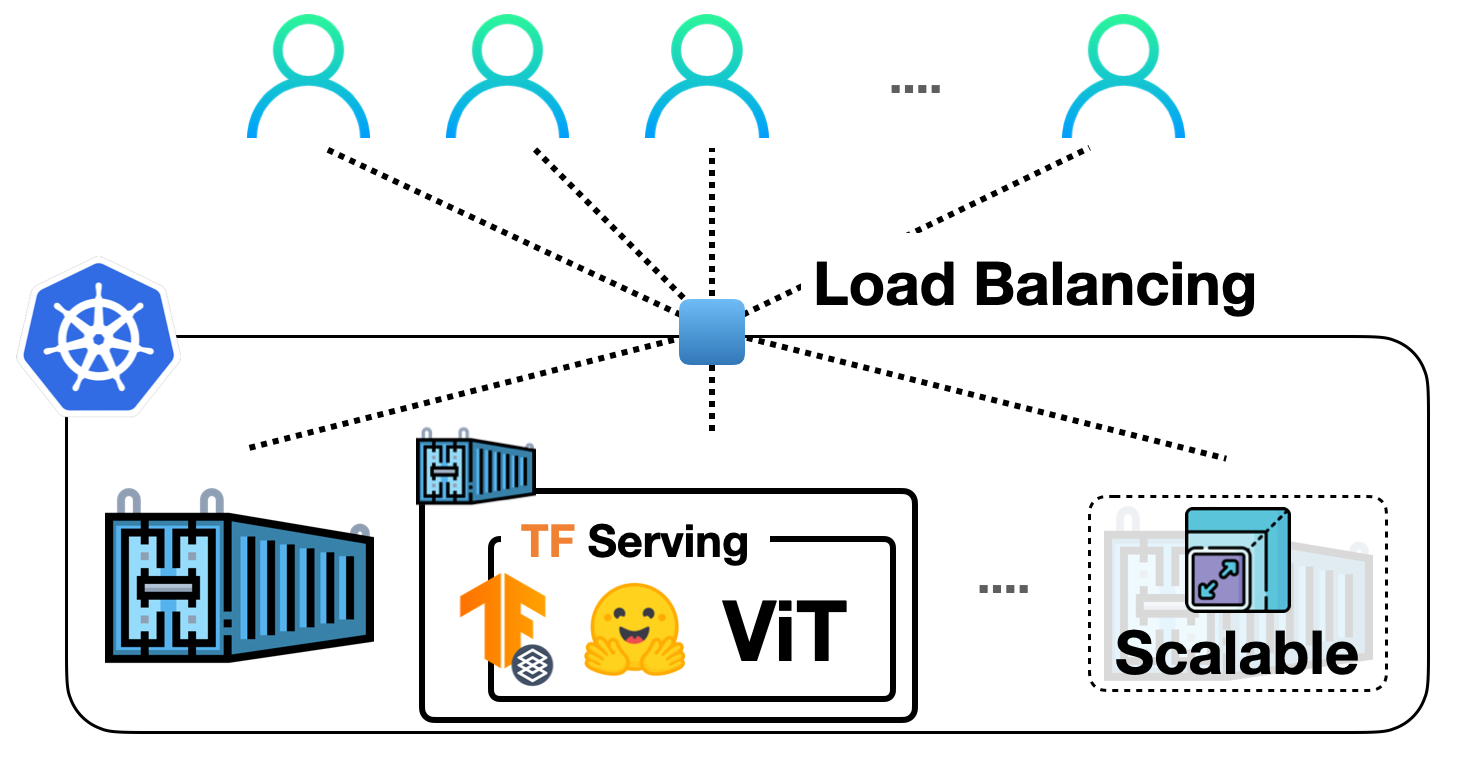
در پروژههایی که به مقیاسپذیری بالا و دسترسی ۲۴ ساعته برای کاربران نیاز دارند، استفاده از داکر برای ایزولهسازی محیط و کُبرنتیز برای هماهنگی و مقیاسپذیری سرویس میتواند راهکار مؤثری باشد. تطبیق منابع، طراحی لایههای سرویس، و امکان رولبک در صورت بروز مشکل، این ترکیب را برای استقرار مدلهای یادگیری ماشین بسیار مناسب میسازد.
ساخت و آزمایش محلی داکر
ابتدا یک Dockerfile بسازید که تصویر پایه را از TensorFlow 2.x یا Python 3.8 طبق نیاز نسخههای HuggingFace Transformers بپوشاند. سپس تصویر با فرمان docker build -t yourusername/viT-tfserving:latest . ساخته و با docker run -p 8501:8501 -d yourusername/viT-tfserving:latest در محیط محلی اجرا کنید. اطمینان از عملکرد درست با ارسال درخواست gRPC به localhost:8501 میتواند راهنمای خوبی برای مرحله بعدی باشد.
- Dockerfile شامل : FROM tensorflow/serving:latest
- داشتن پوشهی مدل /models/ViT با saved_model.pb
- استفاده از ENTRYPOINT و CMD برای راهاندازی Celery یا TF Serving در حال اجرا
استقرار در Kubernetes بر روی GKE
برای تولید محیط مقیاسپذیر، اولین گام ایجاد یک کلاستر در Google Kubernetes Engine (GKE) است. پس از انتخاب تعداد گره، نوع ماشین و قابلیت پیشبینی میتوانید از kubectl برای گسترش مُرکلای تصویر داکر خود در مخزن Google Container Registry استفاده کنید. فایلهای manifests (deployment، service و ingress) را بهصورت YAML بنویسید و با kubectl apply -f نصب کنید.
نحوه تست و راهاندازی اِنڈپوینت
با ارسال پیامهای gRPC یا REST به سرور http://your-service-name.svc.cluster.local:8501/v1/models/ViT:predict میتوانید عملکرد مدل را ارزیابی کنید. همچنین برای اطمینان از پایداری، میتوانید پارامترهای max_instances_per_model و max_batch_size را در فایل config تنظیم کنید.
نکات درباره تنظیمات TF Serving
TF Serving را میتوان با server_config.pbtxt به صورت سفارشی تنظیم کرد؛ برای مثال، فعال کردن batching روی درخواستهای ورودی یا تغییر حدینههای حافظه و زمان پردازش. این پارامترها میتوانند به بهبود راندمان در محیطهای بهرهبرداری کمک شایانی کنند.
نتیجهگیری و ادامه مسیر
با پیادهسازی Docker + Kubernetes + TF Serving، مدل ViT میتواند در مسیحهای واقعی، بهوسیلهی چندین درخواست همزمان و بدون وقفه برپایان باشد. گامهای بعدی میتواند شامل تنظیمات CI/CD برای نسخهبندی خودکار، رصدپذیری و امنیت سرویس باشد.
پرسشهای پرتکرار
چرا باید از Docker و Kubernetes برای استقرار ViT استفاده کنیم؟
Docker باعث ایزولهسازی محیط و نگهداری وابستگیهای نرمافزاری میشود؛ Kubernetes بهصورت پویا منابع را مدیریت کرده و مقیاسپذیری، استرستعداد بالا و امکان رولبک را فراهم میآورد. ترکیب این دو ابزار بهطور خاص برای مدلهای یادگیری ماشین که نیازمند مصرف بالای حافظه و پردازش سنگین هستند، بسیار مناسب است.
آیا میتوانیم این استقرار را بهراحتی در محیطهای دیگر مانند AWS یا Azure انجام دهیم؟
بله. با تغییرات جزئی در فایلهای YAML و بهکارگیری سرویسهای مدیریت کلاستر معتبری مانند Amazon EKS یا Azure AKS، همین روند را اعمال میکنید. همچنین میتوانید از رجیستریهای DockerHub یا ECR برای ذخیرهسازی تصویر داکر استفاده کنید. تنها نکته این است که پارامترهای <code>kubeconfig</code> و <code>service_account</code> بهدست محیط مورد نظر تنظیم شوند.