
 سختافزار
هشدار هوش مصنوعی: حملات تزریق پرامپت به چالش امنیتی بزرگ
حملات تزریق پرامپت، چالش امنیتی برای سیستمهای هوش مصنوعی؛ بررسی راهکارهای OpenAI در حفاظت از دادهها و کارایی مدلها در برابر این تهدید محدود.
 پژوهش
هوش مصنوعی بدون GPU: چگونگی افزایش کارایی با vLLM هممحور در TRL
این مقاله روش Co‑Located vLLM در TRL را معرفی و نشان میدهد چگونه با استفاده از GPUهای مشترک، کارایی مدلهای LLM را بدون هزینه اضافی به حداکثر میرساند.
 اخبار
هوش مصنوعی در شتاب TGI بر روی Intel Gaudi: راهنمای جامع
TGI (Text Generation Inference) با یکپارچگی نوین در پردازندههای Intel Gaudi، سرعت و کارایی مدلهای بزرگ زبان را به طور چشمگیری بهبود میبخشد و اجرای مدلهای LLM را در زمان کمتری ممکن میسازد؛ راهنمای جامع برای پیادهسازی و بهرهبرداری.
 اخبار
هوش مصنوعی کوچکتر میشود: معرفی مدلهای ۲۵۶M و ۵۰۰M SmolVLM
هوش مصنوعی SmolVLM با مدلهای ۲۵۶M و ۵۰۰M کوچکتر و کارآمدتر میشود. این مدلها، از جمله کوچکترین VLM جهان، عملکرد چندوجهی قوی را در ابعادی به مراتب کوچکتر ارائه میدهند و دسترسپذیری را افزایش میدهند.
 پژوهش
سرعتگذاری مدلهای ترنسفورمر به کمک AWS Inferentia2 در هوش مصنوعی
AWS Inferentia2، سختافزار جدید ابری، توانایی شتابزدهسازی مدلهای ترنسفورمر هفینگ فیس را افزایش داده و هزینههای اجرایی را به شکل چشمگیری کاهش میدهد. انطباق با پلتفرم هفینگ فیس امکان استفاده آسان از ترنسفورمری را در پروژههای عملی فراهم میکند.
 پژوهش
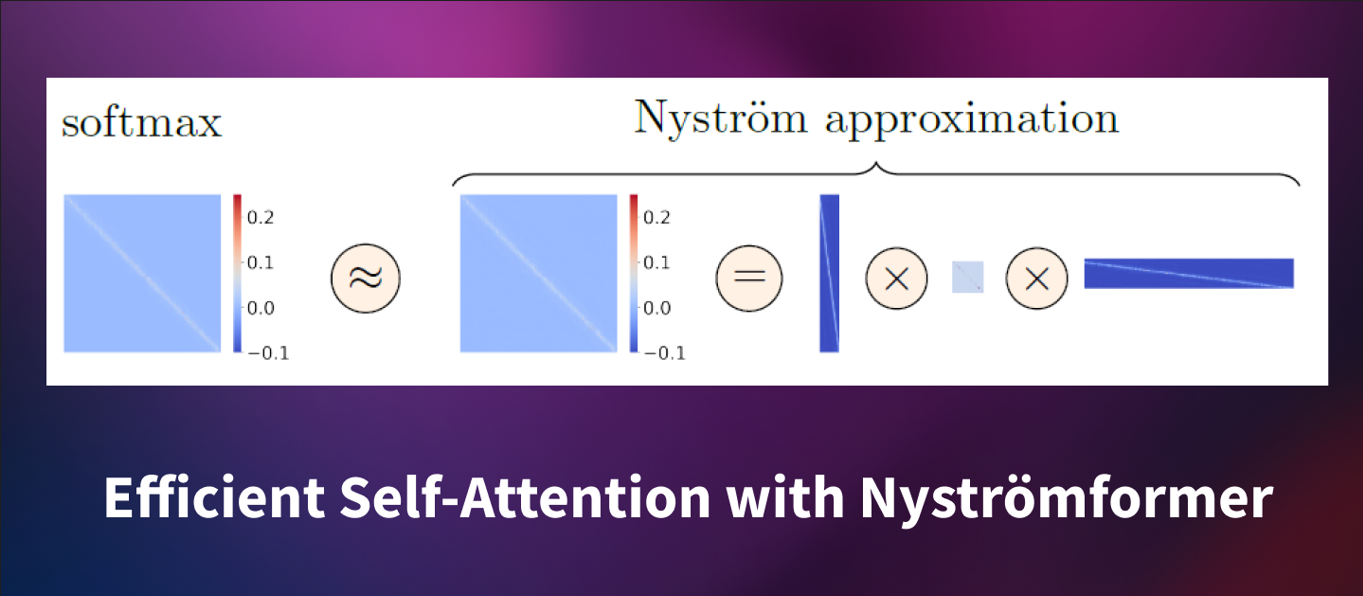
هوش مصنوعی: نیستروفرمری که زمان و حافظه ترنسفورمرها را کاهش میدهد
روش نیستروفرمری با بهرهگیری از تکنیک نیسترو، خود‑توجه در ترنسفورمرها را به صورت خطی ساختن میکند؛ کارایی آن در NLP و CV موثر است.
 پژوهش
هوش مصنوعی: آموزش کارآمد مدل زبان برای پر کردن بخش متوسط متن
خلاصهای از چگونگی آموزش مدلهای زبان گسترش یافته برای پرکردن بخش وسط متن با استفاده از روشهای جدید و بهینه، چشماندازهای امکانپذیر در حوزه هوش مصنوعی را میپیشبینی میکند.
 سختافزار
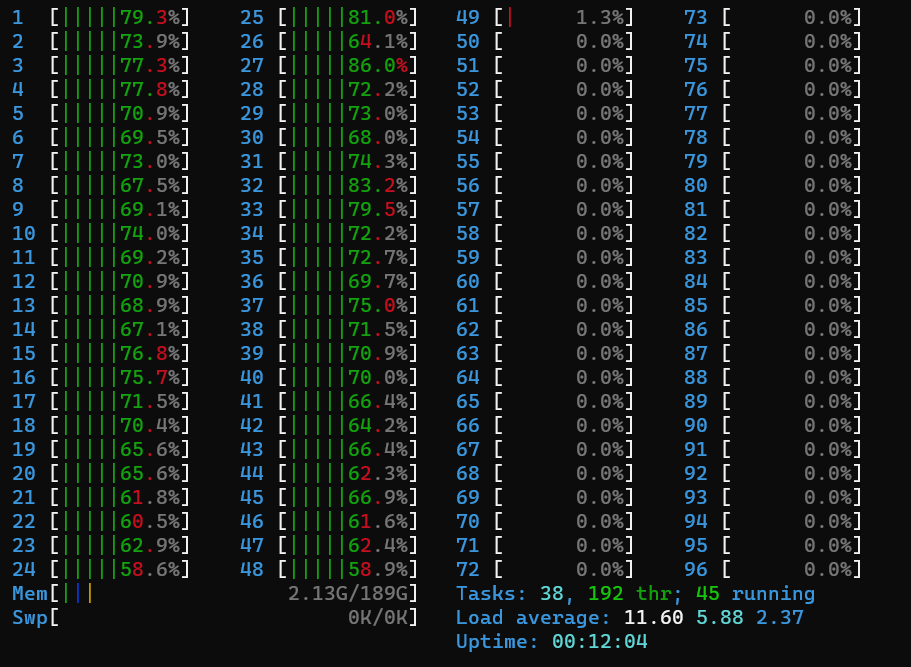
راهنمای بهینهسازی هوش مصنوعی: افزایش کارایی مدل BERT روی CPU
در دنیای هوش مصنوعی، اجرای مدلهای زبانی روی CPU نیازمند بهینهسازی است. این مقاله از Hugging Face روشهای افزایش توان عملیاتی و کاهش تأخیر را بررسی میکند.
 پژوهش
نوآوری OpenAI: سنجش مقاومت هوش مصنوعی در برابر حملات ناشناخته
OpenAI متدی جدید برای سنجش مقاومت شبکههای عصبی در برابر حملات خصمانه پیشبینینشده معرفی کرده است. متریک UAR کارایی مدلها را در برابر تهدیدات ناگهانی ارزیابی میکند.